独立判决:SiteOne Crawler 是一个 MIT 许可的跨平台爬虫和分析器,涵盖 SEO、安全性、可访问性、性能和质量保证。它最适合需要一个可重复的网站库存来进行多项工程和营销质量检查的团队。主要的采用错误是将开放存储库或高星级计数视为其推荐、数据或分数对于每个站点都是正确的证据。
仅当调查结果由所有者传递时,跨职能报告才有用;否则,广度就会变成一大堆积压的工作,没有决策规则。
SiteOne Crawler 实际上做了什么
SiteOne Crawler 应被评估为爬虫工具,而不是通用的 SEO 平台。经过验证的存储库描述为:“SiteOne Crawler 是一个跨平台网站爬虫和分析器,用于 SEO、安全性、可访问性和性能优化,非常适合开发人员、DevOps、QA 工程师和顾问。支持 Windows、macOS 和 Linux(x64 和 arm64)。”这种区别很重要,因为爬虫、结构化数据库和 MCP 连接器解决 SEO 工作流程的不同层。
| 已验证的能力 | 实际意义 |
|---|---|
| 在 Windows、macOS 和 Linux 上运行,包括项目记录的 x64 和 arm64 版本。 | 在依赖之前检查官方设置和版本。 |
| 将网站抓取与多个质量学科相结合,使其对开发人员、DevOps、QA 和顾问有用。 | 将集成视为单独的信任和成本边界。 |
| 广泛的覆盖范围增加了分类工作:一次爬网可以将排名、安全性、可访问性和性能结果与不同的所有者和严重性模型混合在一起。 | 对代表性网站或帐户上的行为进行基准测试。 |
当前 GitHub 证据快照
下表拍摄于 2026 年 10 月 19 日。“最新”是指本次审查中最近的存储库活动,而“热门”是关注度和活动的混合。这两个术语都不是质量保证。
| 证据 | 观察到 | 如何解读它 |
|---|---|---|
| 存储库活动 | 964 颗星 · 90 个叉子 | 社区关注和重用信号;不是 SEO 结果的证明 |
| 最后一推 | 2026-09-27 | 最近的代码活动;在生产前检查版本和重大变更 |
| 许可证 | MIT | 确认分发、SaaS 使用和修改的义务 |
| 主堆栈 | 铁锈 | 表示可能的维护技能,而不是功能完整性 |
最适合的工作流程
最适合:需要一个可重复的网站库存来进行多项工程和营销质量检查的团队。
- 在重新设计启动之前审核暂存站点。
- 为 SEO、安全性和可访问性所有者创建跨职能问题报告。
- 在交付管道中运行可重复的命令行检查。
实际出发点:定义爬网边界和凭据,运行暂存示例,将每个问题类别路由给正确的所有者,手动验证关键发现,然后设置狭窄的回归门。
限制、安全性和运营成本
- 在每个学科中,广泛的扫描仪可能不如专用工具那么专业。
- 经过身份验证和高度交互的应用程序需要仔细的爬网配置。
- 严重性应反映用户和业务影响,而不仅仅是扫描仪标签。
开源消除了一种形式的锁定,但它并没有消除工程时间、模型或 API 费用、浏览器/代理成本、数据提供商条款、身份验证工作、备份或升级风险。在生产使用之前映射每个外部服务和每个可写操作。
SiteOne Crawler 与替代方案相比
| 选项 | 选择它时 | 权衡 |
|---|---|---|
| 自由爬行 | 以本地 SEO 为中心的抓取和定制 | 范围更窄、产品更年轻 |
| SEOmator | 具有桌面和代理选项的大型确定性规则集 | 更多 SEO 评分,不同的报告 |
| 单独的专业扫描仪 | 受监管或深度安全/可访问性工作 | 深度更准确,工具更协调 |
比较是基于任务的,而不是声称某种产品普遍更好。一个狭窄的库可能胜过其框架内的套件,而成熟的商业爬虫可能比维护大规模的开放工具更便宜。
采用前的七步评估
- 1.在安装或连接帐户之前定义一个决策和一个有界测试集。
- 2.固定存储库修订或版本并记录使用的配置。
- 3.根据实时页面、源控制台或其他独立工具验证多个输出。
- 4.将确定性观察结果与分数、估计和模型编写的建议分开。
- 5.测量真实样本的误报、缺失覆盖范围、运行时间和提供商成本。
- 6.使用最低权限凭证;需要批准编辑、提交、清除或发布。
- 7.保留原始导出和回滚计划,以便在更新后审核结果。
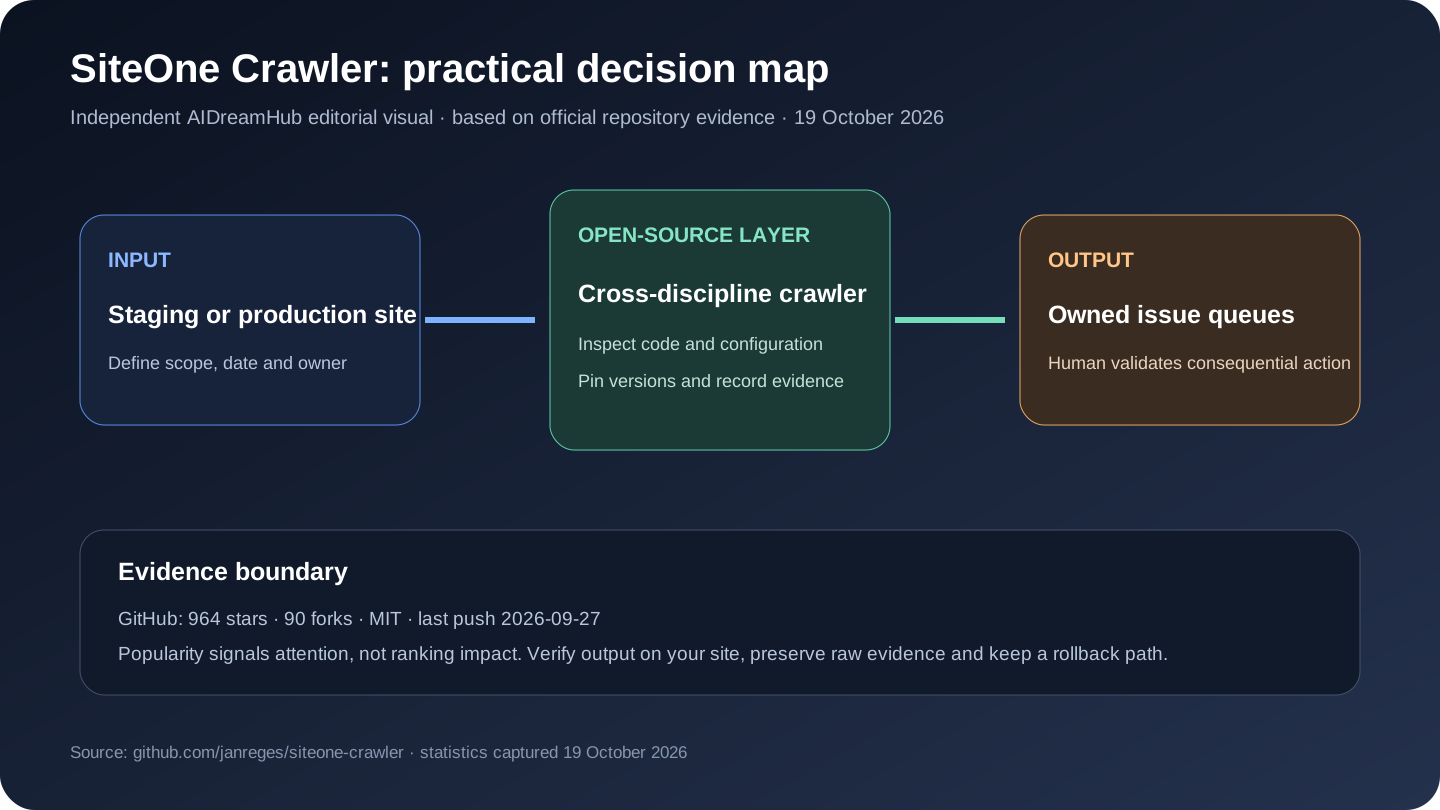
我们的独立看法
仅当调查结果由所有者传递时,跨职能报告才有用;否则,广度就会变成一大堆积压的工作,没有决策规则。这也是决策边界:如果该工具能够产生可重复的证据并减少实际站点上的工作,则保留该工具;如果团队主要收到更多分数、散文或问题量而没有更清晰的决定,则拒绝它。
常见问题
它真的是开源的吗?
GitHub API 于 2026 年 10 月 19 日报告了 MIT。查看存储库的许可证文件和依赖项许可证以了解确切的权利和义务。即使客户端代码开放,连接的云 API 或托管服务也可以有单独的术语。
GitHub 受欢迎程度是否意味着它会提高排名?
不会。星号和叉子表示关注和重用,而不是排名提升、数据准确性或特定站点的适用性。使用带有 Search Console 的受控评估、分析和手动验证的输出。
它最适合谁?
SiteOne Crawler 最适合需要一个可重复的网站库存来进行多项工程和营销质量检查的团队。当团队无法操作其运行时、验证其证据或拥有其请求的权限时,它就不适合。
首先应该测试什么?
使用一种代表性工作流程:在重新设计启动之前审核暂存站点。记录输入、原始输出、时间、故障和任何外部成本,然后与团队当前的方法进行比较。
它可以取代商业 SEO 套件吗?
通常仅适用于定义的工作片段。开源工作流程和审计工具很少包含与成熟付费套件相同的专有反向链接索引、历史 SERP 覆盖范围、支持组织、权限和精美的客户报告。
如何使用SiteOne Crawler:Quick Start
该工作流程是从项目的官方自述文件和文档中浓缩而来的。首先在测试站点、测试属性或本地环境上运行它;当版本更改时再次检查链接的源。
先决条件
- 支持的 Windows、macOS 或 Linux 系统
- macOS/Linux 上预构建的二进制文件或 Homebrew
- 目标站点的权限和限制
安装并运行
brew install janreges/tap/siteone-crawler

# First crawl
siteone-crawler --url=https://example.com

# JavaScript rendering when required
siteone-crawler --url=https://example.com --browser --screenshots
首次使用工作流程
- 安装预构建的二进制文件或 Homebrew 软件包;当 glibc 较旧时选择兼容的 Linux 变体。
- 在小型网站上运行第一次爬网,无需浏览器渲染。
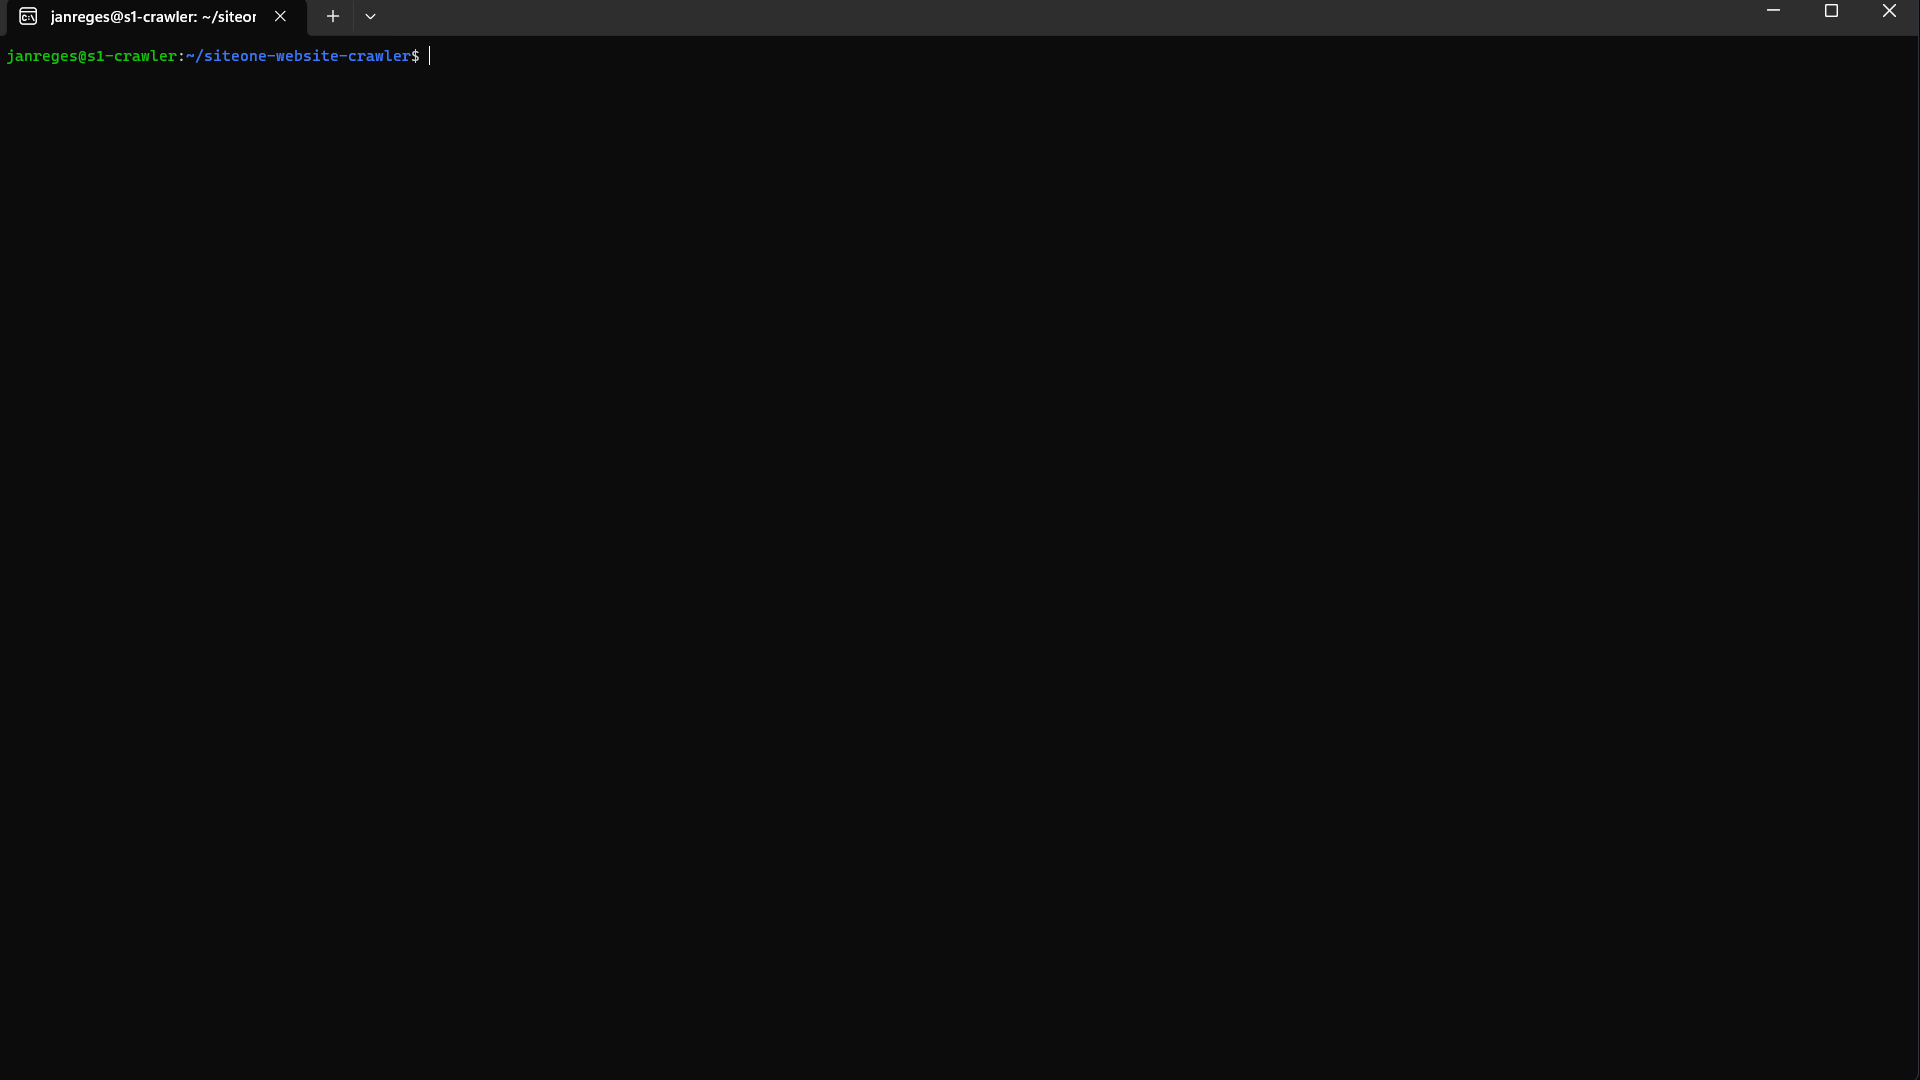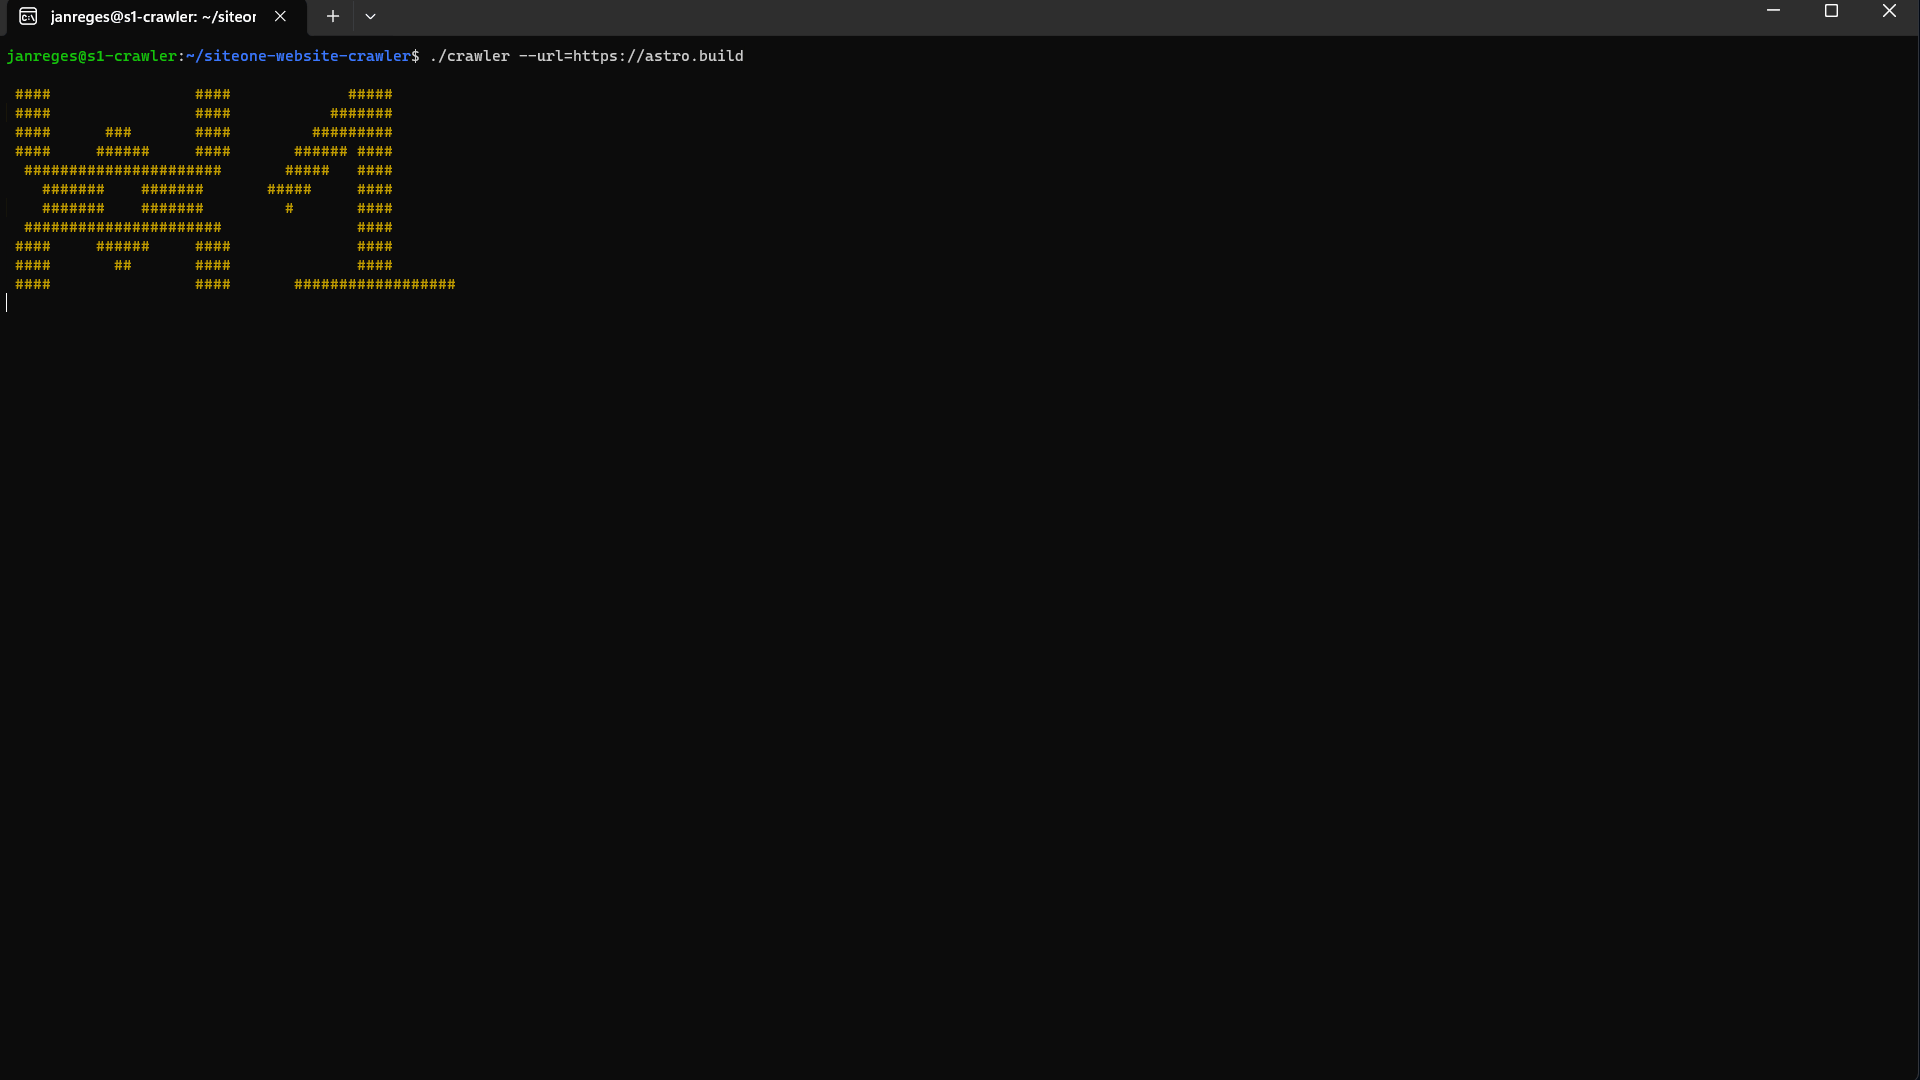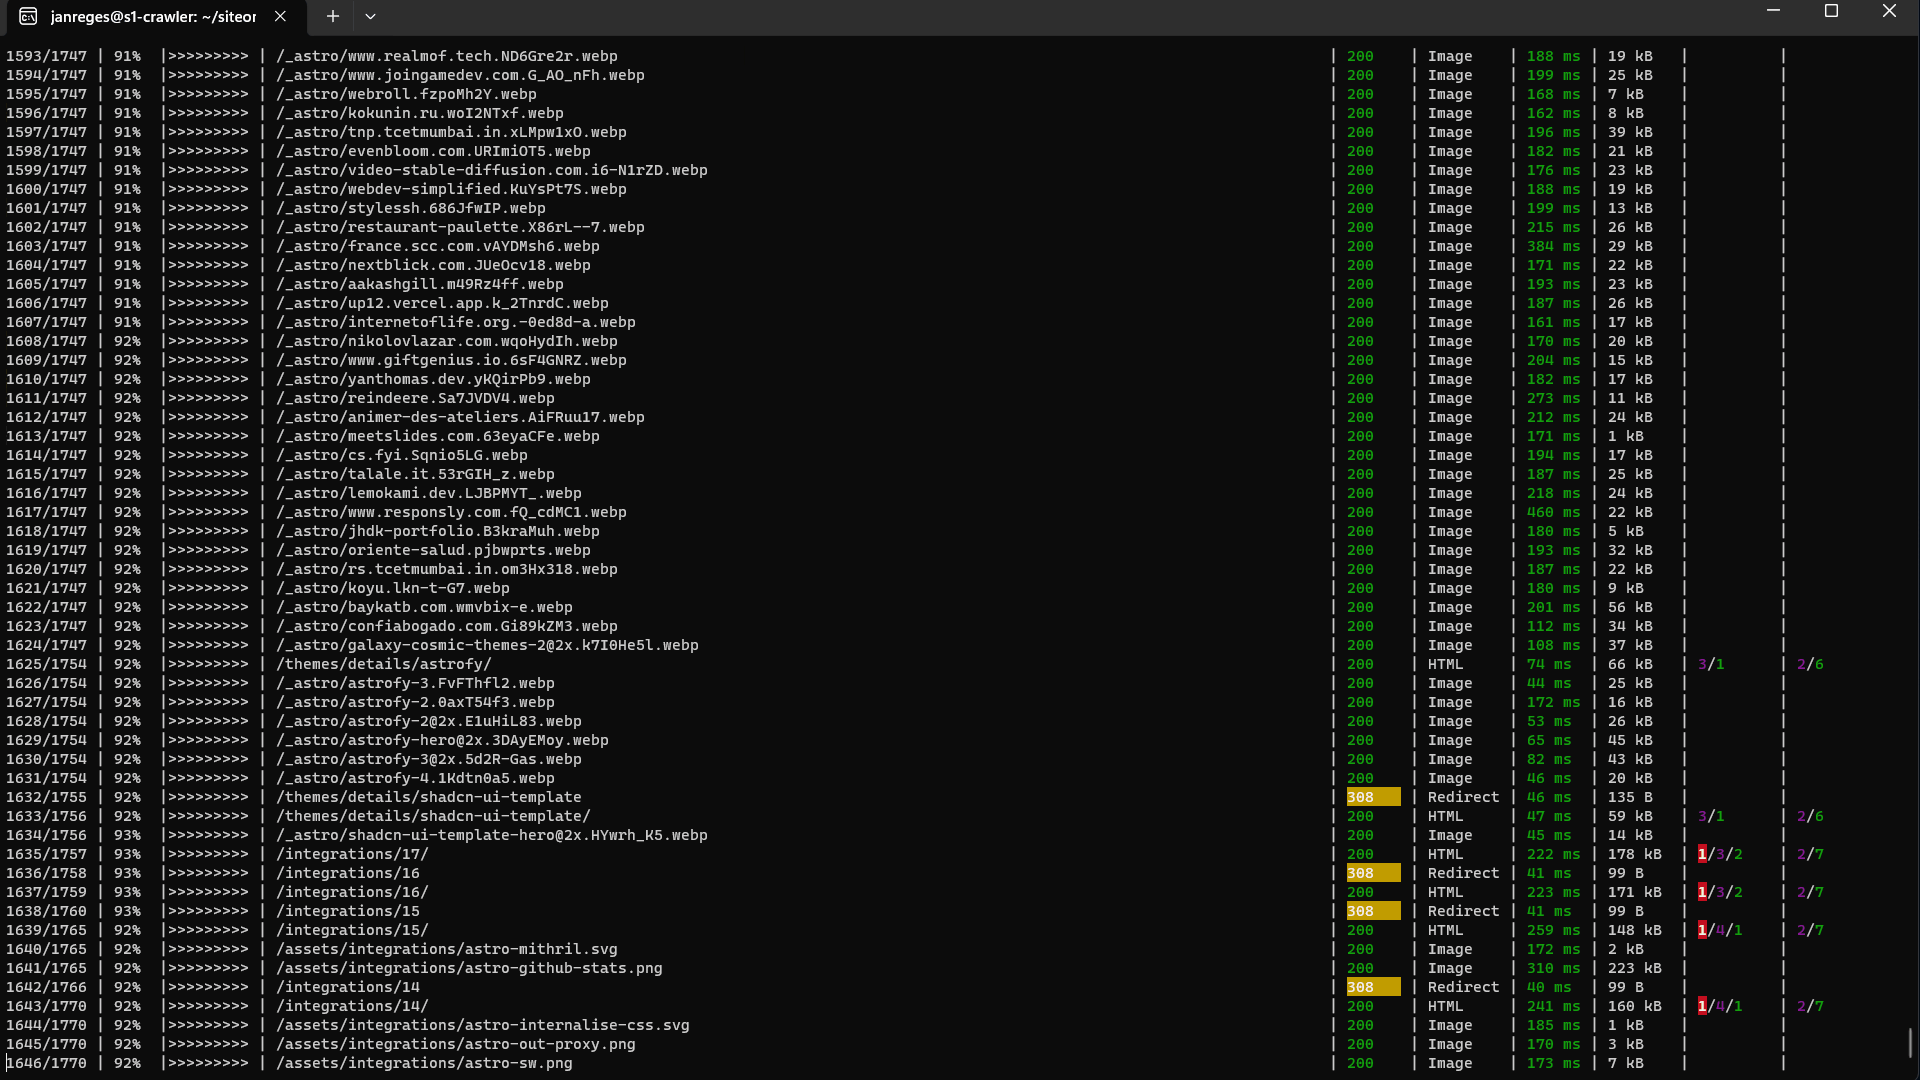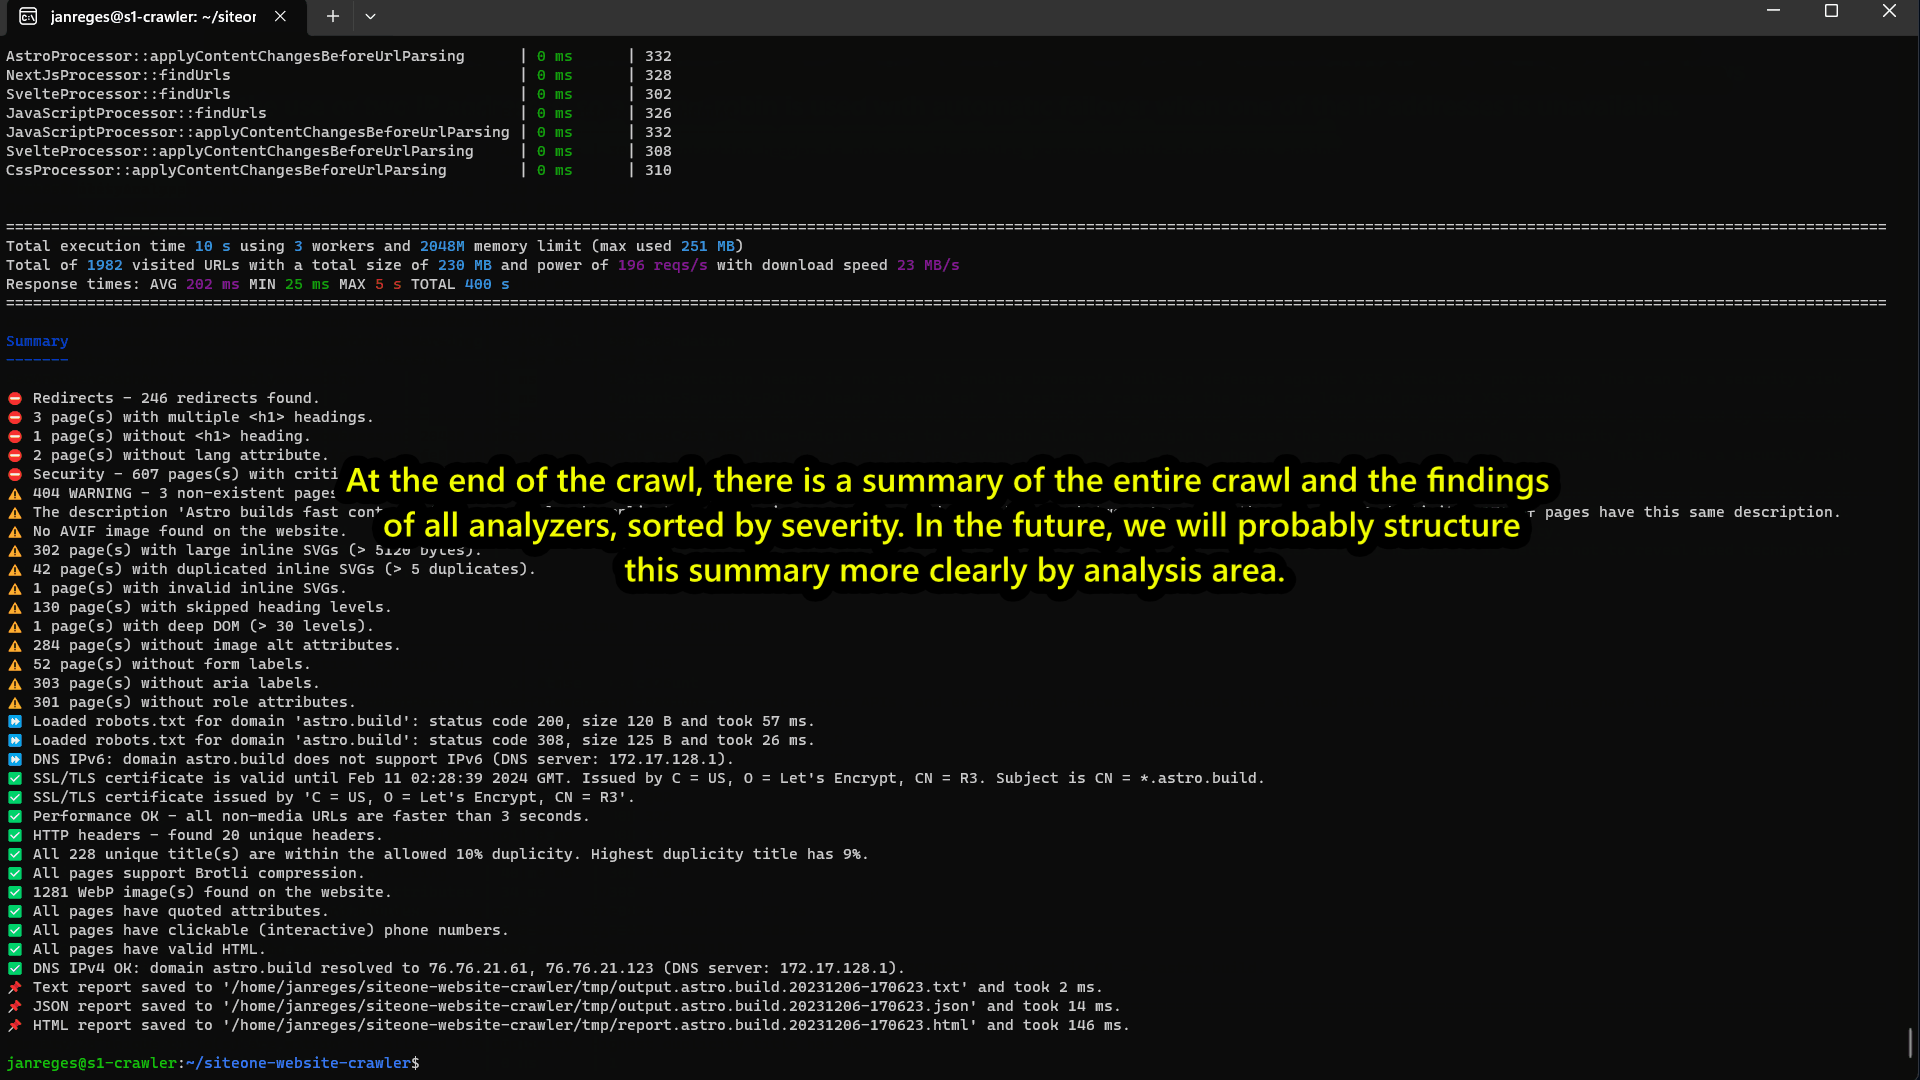
- 查看生成的涵盖 SEO、安全性、可访问性和性能类别的报告。
- 仅当客户端呈现实质上更改页面时才启用 --browser。
- 将每个经过验证的问题类别分配给正确的工程、内容或安全所有者。
如何确认它有效
爬网完成时会提供可审核的 URL 库存,并手动检查高严重性结果是否与实时响应和呈现的页面相匹配。
生产使用前
浏览器渲染和屏幕截图会增加运行时间。不要将每个扫描仪类别合并到一个无主的待办事项中;使用特定学科的严重性和回归门。
官方 Quick Start 来源: janreges/siteone-crawler 自述文件.
来源审查
编辑评论于 2026 年 10 月 19 日更新。存储库统计数据、文档、依赖项和托管服务条款可能会发生变化。在安装、采购或部署之前验证链接的官方来源。