独立判决:SEO Machine 是 MIT 许可的 Claude Code 工作区,用于研究、编写、更新和优化包含品牌背景、专业代理和可选绩效数据的长格式内容。它最适合需要基于存储库的编辑系统并准备审查研究、散文和出版变更的内容团队。主要的采用错误是将开放存储库或高星级计数视为其推荐、数据或分数对于每个站点都是正确的证据。
存储库结构就是产品:持久上下文和分阶段工件比要求模型在一次聊天中编写一篇优化的文章更具防御性。
SEO Machine 实际上做了什么
SEO Machine 应被评估为代理工具,而不是通用的 SEO 平台。经过验证的存储库描述是:“专门的 Claude Code 工作区,用于为任何企业创建长格式、SEO 优化的博客内容。该系统可帮助您研究、编写、分析和优化排名良好并服务于目标受众的内容。”这种区别很重要,因为爬虫、结构化数据库和 MCP 连接器解决 SEO 工作流程的不同层。
| 已验证的能力 | 实际意义 |
|---|---|
| 包括研究、写作、重写、分析、优化、内部链接、发布草稿和优先审查的命令。 | 在依赖之前检查官方设置和版本。 |
| 使用可编辑的上下文文件来表达品牌声音、编写示例、受众和 SEO 规则,而不是仅依赖一次性提示。 | 将集成视为单独的信任和成本边界。 |
| 可以集成 Google Analytics、Search Console 和 DataForSEO,这会添加凭据、提供商条款和可能的使用成本。 | 对代表性网站或帐户上的行为进行基准测试。 |
当前 GitHub 证据快照
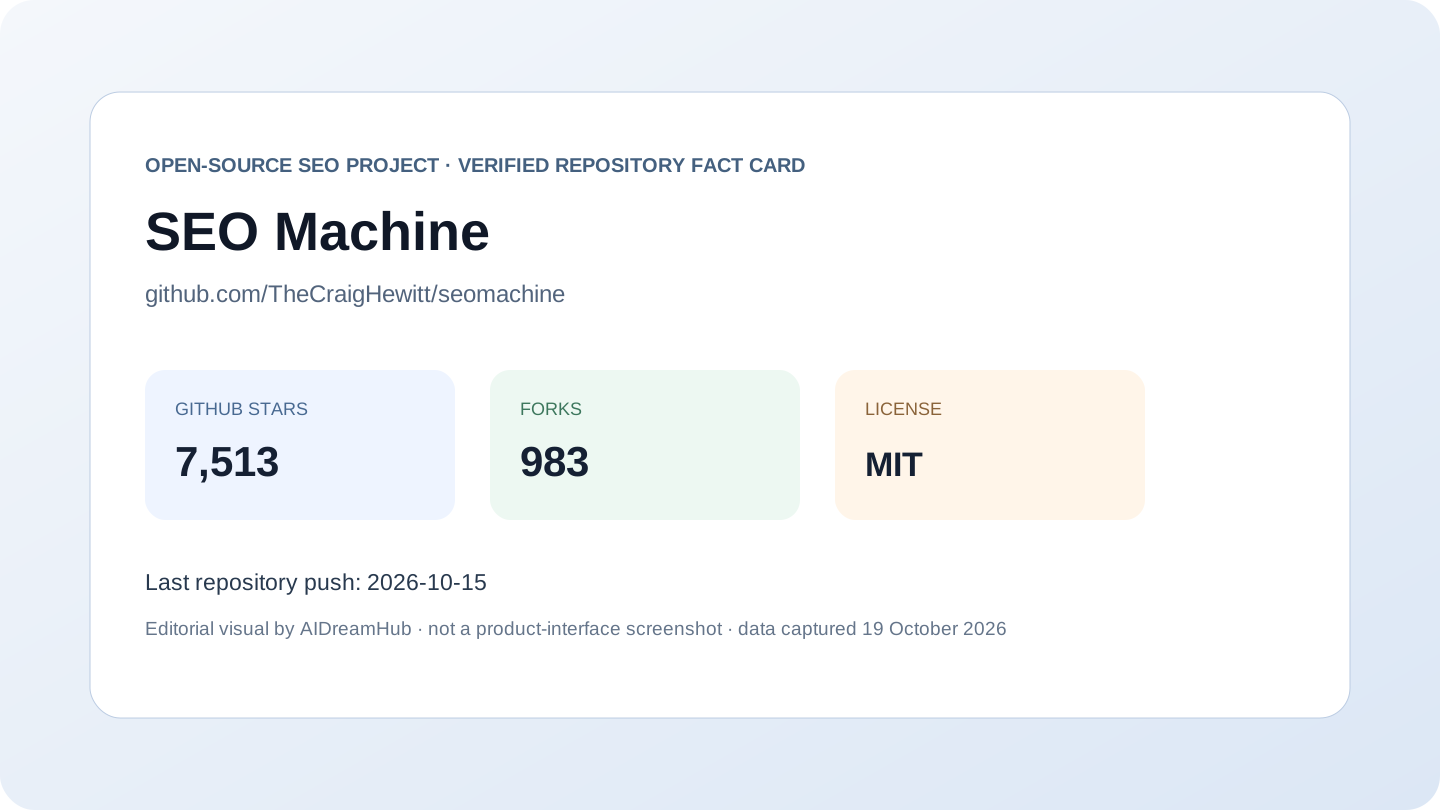
下表拍摄于 2026 年 10 月 19 日。“最新”是指本次审查中最近的存储库活动,而“热门”是关注度和活动的混合。这两个术语都不是质量保证。
| 证据 | 观察到 | 如何解读它 |
|---|---|---|
| 存储库活动 | 7,513 颗星 · 983 个叉子 | 社区关注和重用信号;不是 SEO 结果的证明 |
| 最后一推 | 2026-10-15 | 最近的代码活动;在生产前检查版本和重大变更 |
| 许可证 | MIT | 确认分发、SaaS 使用和修改的义务 |
| 主堆栈 | 蟒蛇 | 表示可能的维护技能,而不是功能完整性 |
最适合的工作流程
最适合:需要基于存储库的编辑系统并准备审查研究、散文和出版变更的内容团队。
- 根据搜索意图和竞争对手证据构建内容简介。
- 使用第一方效果数据刷新现有文章。
- 在人工发布之前运行编辑、元数据和内部链接检查。
实际出发点:用真实的例子填充上下文模板,将第一次运行限制为草稿,要求声明旁边有源链接,并将结果与人工编辑的对照文章进行比较。
限制、安全性和运营成本
- 长格式生成可以在没有源分类帐的情况下产生看似合理的重复或不受支持的声明。
- 该工作区取决于 Claude Code 并且需要有意义的品牌上下文设置。
- 自动关键字密度或分数改进并不能建立有用性或排名提升。
开源消除了一种形式的锁定,但它并没有消除工程时间、模型或 API 费用、浏览器/代理成本、数据提供商条款、身份验证工作、备份或升级风险。在生产使用之前映射每个外部服务和每个可写操作。
SEO Machine 与替代方案相比
| 选项 | 选择它时 | 权衡 |
|---|---|---|
| 营销技巧 | 超越内容的模块化工作流程 | 更便携、更少固执己见的内容管道 |
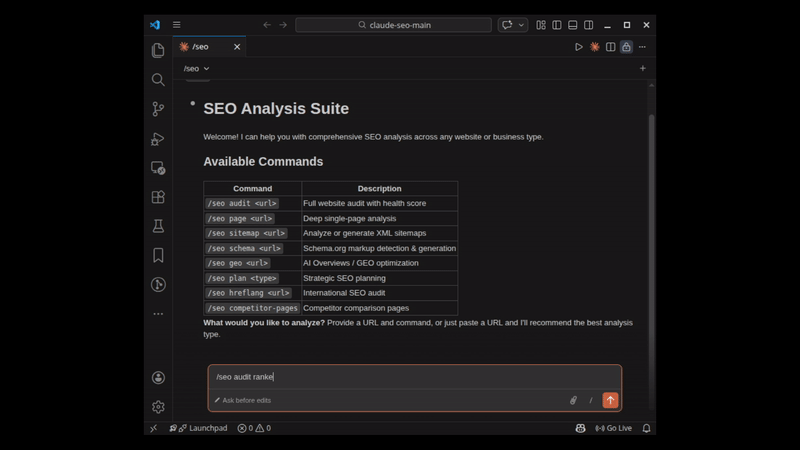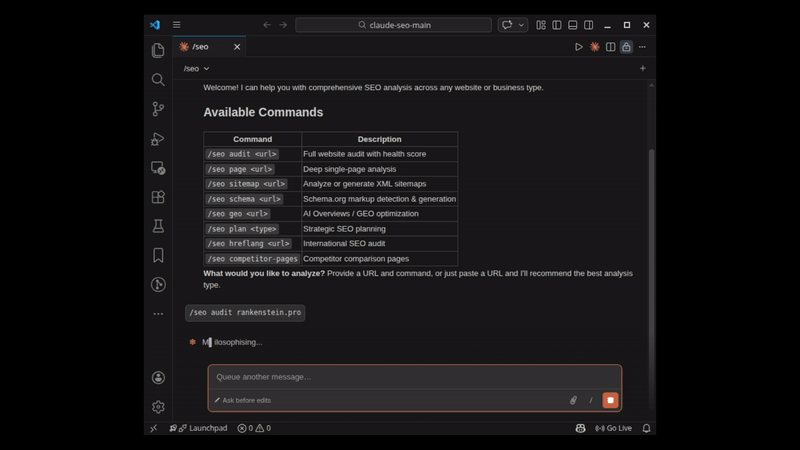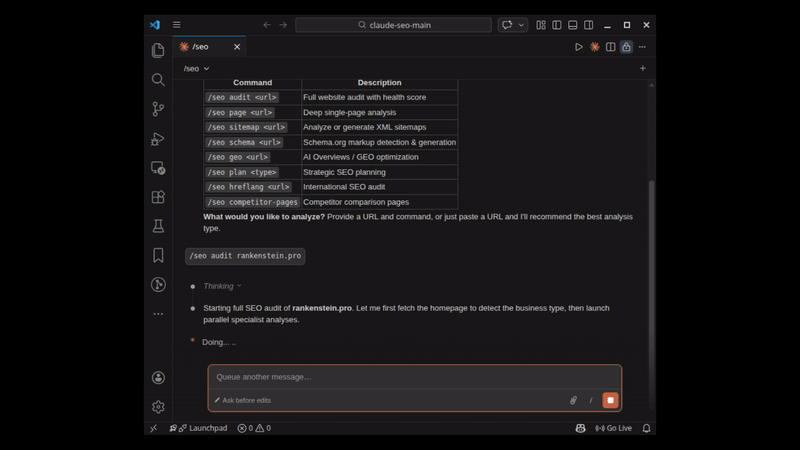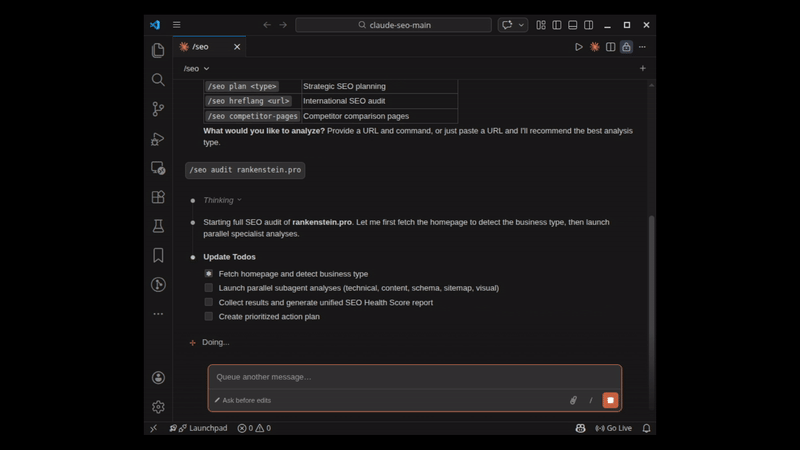
| 克劳德 SEO | 全站点技术和 GEO 审核 | 更强的审计广度,更少的编辑工作流程 |
| 编辑 CMS 工作流程 | 受监管或高风险出版 | 更多的人为控制,更少的自动化 |
比较是基于任务的,而不是声称某种产品普遍更好。一个狭窄的库可能胜过其框架内的套件,而成熟的商业爬虫可能比维护大规模的开放工具更便宜。
采用前的七步评估
- 1.在安装或连接帐户之前定义一个决策和一个有界测试集。
- 2.固定存储库修订或版本并记录使用的配置。
- 3.根据实时页面、源控制台或其他独立工具验证多个输出。
- 4.将确定性观察结果与分数、估计和模型编写的建议分开。
- 5.测量真实样本的误报、缺失覆盖范围、运行时间和提供商成本。
- 6.使用最低权限凭证;需要批准编辑、提交、清除或发布。
- 7.保留原始导出和回滚计划,以便在更新后审核结果。
我们的独立看法
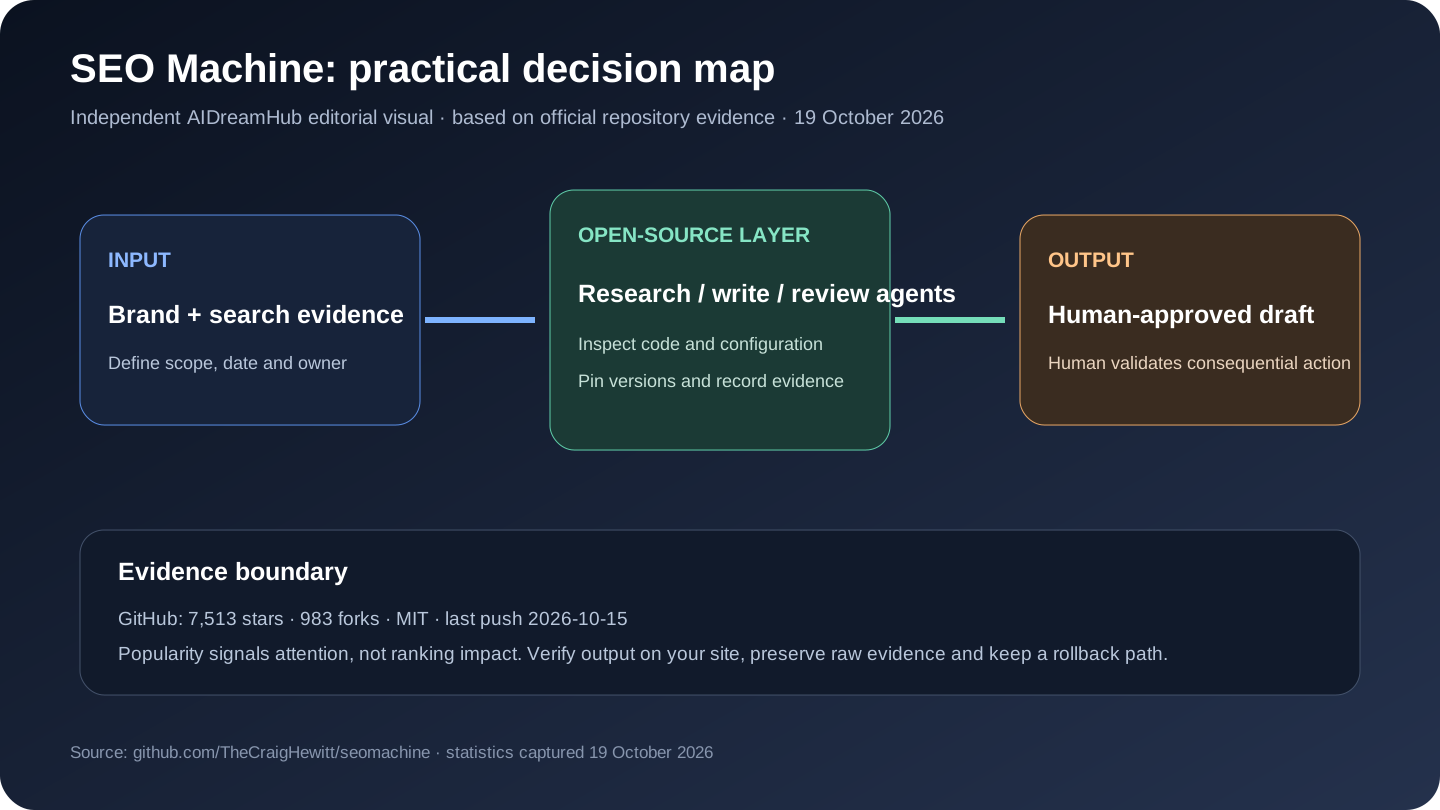
存储库结构就是产品:持久上下文和分阶段工件比要求模型在一次聊天中编写一篇优化的文章更具防御性。这也是决策边界:如果该工具能够产生可重复的证据并减少实际站点上的工作,则保留该工具;如果团队主要收到更多分数、散文或问题量而没有更清晰的决定,则拒绝它。
常见问题
它真的是开源的吗?
GitHub API 于 2026 年 10 月 19 日报告了 MIT。查看存储库的许可证文件和依赖项许可证以了解确切的权利和义务。即使客户端代码开放,连接的云 API 或托管服务也可以有单独的术语。
GitHub 受欢迎程度是否意味着它会提高排名?
不会。星号和叉子表示关注和重用,而不是排名提升、数据准确性或特定站点的适用性。使用带有 Search Console 的受控评估、分析和手动验证的输出。
它最适合谁?
SEO Machine 最适合需要基于存储库的编辑系统并准备审查研究、散文和出版变更的内容团队。当团队无法操作其运行时、验证其证据或拥有其请求的权限时,它就不适合。
首先应该测试什么?
使用一个有代表性的工作流程:根据搜索意图和竞争对手证据构建内容简介。记录输入、原始输出、时间、故障和任何外部成本,然后与团队当前的方法进行比较。
它可以取代商业 SEO 套件吗?
通常仅适用于定义的工作片段。开源工作流程和审计工具很少包含与成熟付费套件相同的专有反向链接索引、历史 SERP 覆盖范围、支持组织、权限和精美的客户报告。
如何使用SEO Machine:Quick Start
该工作流程是从项目的官方自述文件和文档中浓缩而来的。首先在测试站点、测试属性或本地环境上运行它;当版本更改时再次检查链接的源。
先决条件
- Claude Code 和 Anthropic 帐户
- Python 和 pip 用于分析模块
- 可选 Google Analytics、Search Console 和 DataForSEO 凭据
安装并运行
git clone https://github.com/TheCraigHewitt/seomachine.git
cd seomachine
pip install -r data_sources/requirements.txt
claude-code .

# Start with research before drafting
/research your-topic
/write your-topic
首次使用工作流程
- 克隆存储库并安装 Python 数据源要求。
- 打开 Claude Code 中的工作区。
- 将示例上下文文件替换为真实的品牌声音、示例、功能和内部链接图。
- 在 /write 之前运行 /research 并要求事实声明的源链接。
- 将第一个结果保留为草稿,并在发布之前运行编辑器和优化检查。
如何确认它有效
该草稿反映了所提供的品牌背景,保留了源跟踪,并存储在存储库的分阶段工作流程中,而不是直接发布。
生产使用前
不要将生产凭据粘贴到提示中。与人工编辑一起审查不受支持的主张、重复的散文、内部链接和发布更改。
官方 Quick Start 来源: TheCraigHewitt/seomachine 自述文件.
来源审查
编辑评论于 2026 年 10 月 19 日更新。存储库统计数据、文档、依赖项和托管服务条款可能会发生变化。在安装、采购或部署之前验证链接的官方来源。