Stable Audio
Stable Audio는 Stability AI의 생성형 오디오 플랫폼으로 텍스트 프롬프트에서 음악, 루프, 스템, 앰비언스, 사운드 이펙트를 만들 수 있습니다. Stable Audio 3.0 제품군은 예술 실험과 로컬 연구용 open-weight 옵션을 제공합니다.
Stable AudioStability AI 오디오AI 음악 생성
1440
Stable Audio는 Stability AI의 생성형 오디오 플랫폼으로 텍스트 프롬프트에서 음악, 루프, 스템, 앰비언스, 사운드 이펙트를 만들 수 있습니다. Stable Audio 3.0 제품군은 예술 실험과 로컬 연구용 open-weight 옵션을 제공합니다.

Open source library for audio/music generation by Meta, which mainly includes two models, MusicGen: text-to-music model, AudioGen: text-generated sound model. - 스마트 AI 도구로 생산성 향상.

Bark is a transformer-based text-to-audio model created by Suno. Bark can generate highly realistic, multilingual speech as well as other audio - including music, background noise and simple sound effects. - 스마트 AI 도구로 생산성 향상.
ElevenLabs Sound Effects는 텍스트 프롬프트로 커스텀 SFX, 앰비언스, 루프, 시네마틱 오디오를 만드는 text-to-sound-effects 생성기입니다. 길이 제어, prompt influence, 루프 효과, 여러 변형, 다운로드, API 워크플로를 지원합니다.
Mureka는 프롬프트나 가사에서 곡을 만들고 reference audio·Vocal ID·구간 편집·연장·Remix·stem 분리·export까지 제공하는 AI 음악 제작 플랫폼입니다.
Create music from simple text prompts by specifying topics, genres, and other descriptors which are then transformed into professional quality tracks. - 스마트 AI 도구로 생산성 향상.
Create stunning original music for free in seconds using AI. Make your own masterpieces, share with friends, and discover music from artists worldwide. - 스마트 AI 도구로 생산성 향상.
Split vocal and instrumental tracks quickly and accurately with LALAL.AI. Upload any audio file and receive high-quality extracted tracks in a few seconds. - 스마트 AI 도구로 생산성 향상.
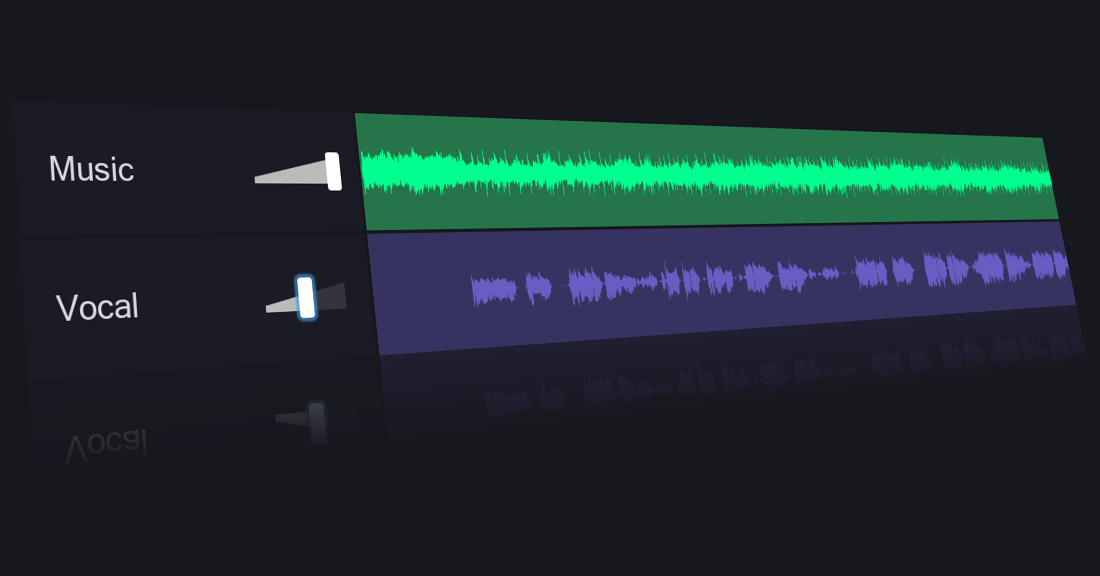
Separate voice from music out of a song free with powerful AI algorithms - 스마트 AI 도구로 생산성 향상.
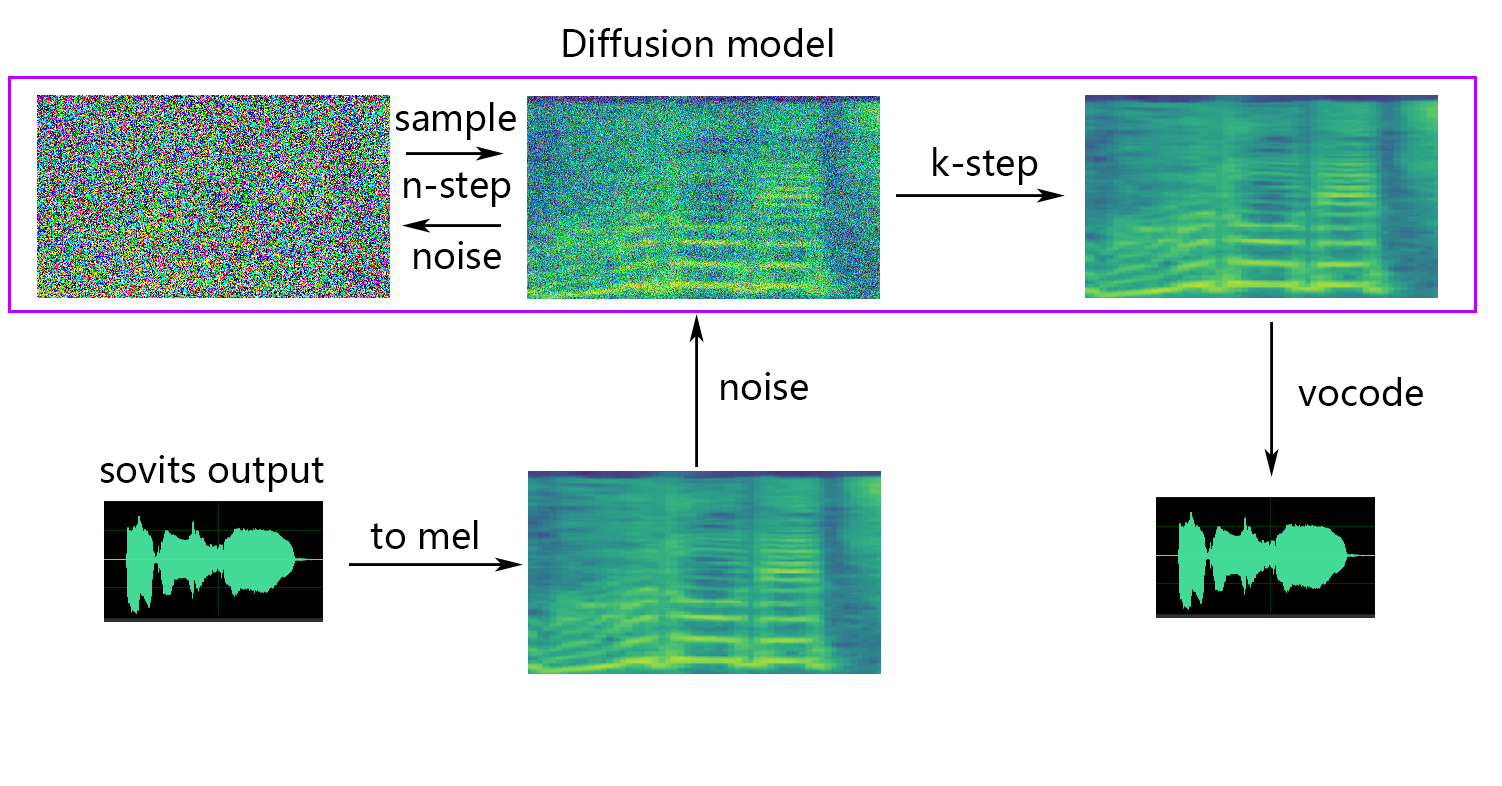
So-VITS-SVC 4.1은 텍스트 음성 변환이 아닌 노래 음성 변환을 위한 보관된 오픈 소스 연구 프레임워크입니다. 이 독립 가이드에서는 동의, 라이선스, 클린 데이터 세트, F0 및 인코더, 교육, 추론, 평가, 공개, 보안 및 대안을 다룹니다.
Shazam은 주변이나 지원되는 앱 안에서 재생되는 음악을 식별하는 Apple의 음악 인식 앱입니다. 곡명, 가사, 영상, 공연 정보, Apple Music 연결을 빠르게 찾고 싶은 사용자에게 유용합니다.
ChatTTS is a text-to-speech model designed specifically for dialogue scenario such as LLM assistant. It supports both English and Chinese languages. - 스마트 AI 도구로 생산성 향상.
Tetos는 여러 TTS 제공자를 하나의 인터페이스로 다루는 오픈소스 Python/CLI 래퍼입니다. Edge TTS, OpenAI, Azure, Google, Volcengine, Baidu, Minimax, Xunfei, Fish Audio 등을 비교하거나 전환하려는 개발자에게 유용합니다.
EmotiVoice는 NetEase Youdao의 무료 오픈소스 다중 음성, 프롬프트 제어 TTS 엔진입니다. 영어와 중국어 음성 합성, 2,000개 이상 음성, 감정/스타일 제어를 지원해 연구, 개발, 캐릭터 음성, 음성 앱 프로토타입에 적합합니다.
ElevenLabs는 TTS, 음성 복제, 더빙, STT, voice agents, 생성 오디오 API를 제공하는 AI 음성 플랫폼입니다.
A deep learning toolkit for Text-to-Speech, battle-tested in research and production - 스마트 AI 도구로 생산성 향상.
Hailuo AI TTS는 MiniMax Audio와 연결된 다국어 텍스트 음성 변환, AI 음성, 음성 복제 도구입니다.
The best and most realistic voice tools currently available - 스마트 AI 도구로 생산성 향상.
IndexTTS는 Bilibili의 오픈소스 산업급 제어 가능 고효율 제로샷 TTS 시스템입니다. 완성형 웹 음성 앱이 아니라 음성 연구자와 개발자를 위한 실험 프로젝트에 가깝습니다.
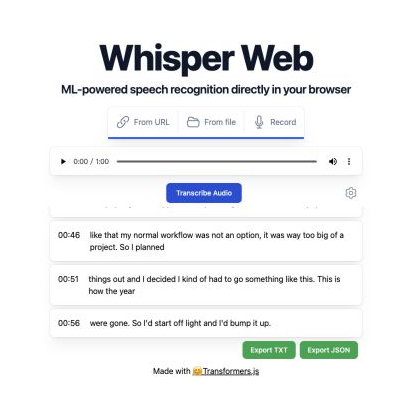
Whisper Web는 Transformers.js 기반의 MIT 라이선스 브라우저 음성 인식 데모로, 로컬 전사와 타임스탬프, TXT/JSON 내보내기를 지원합니다.
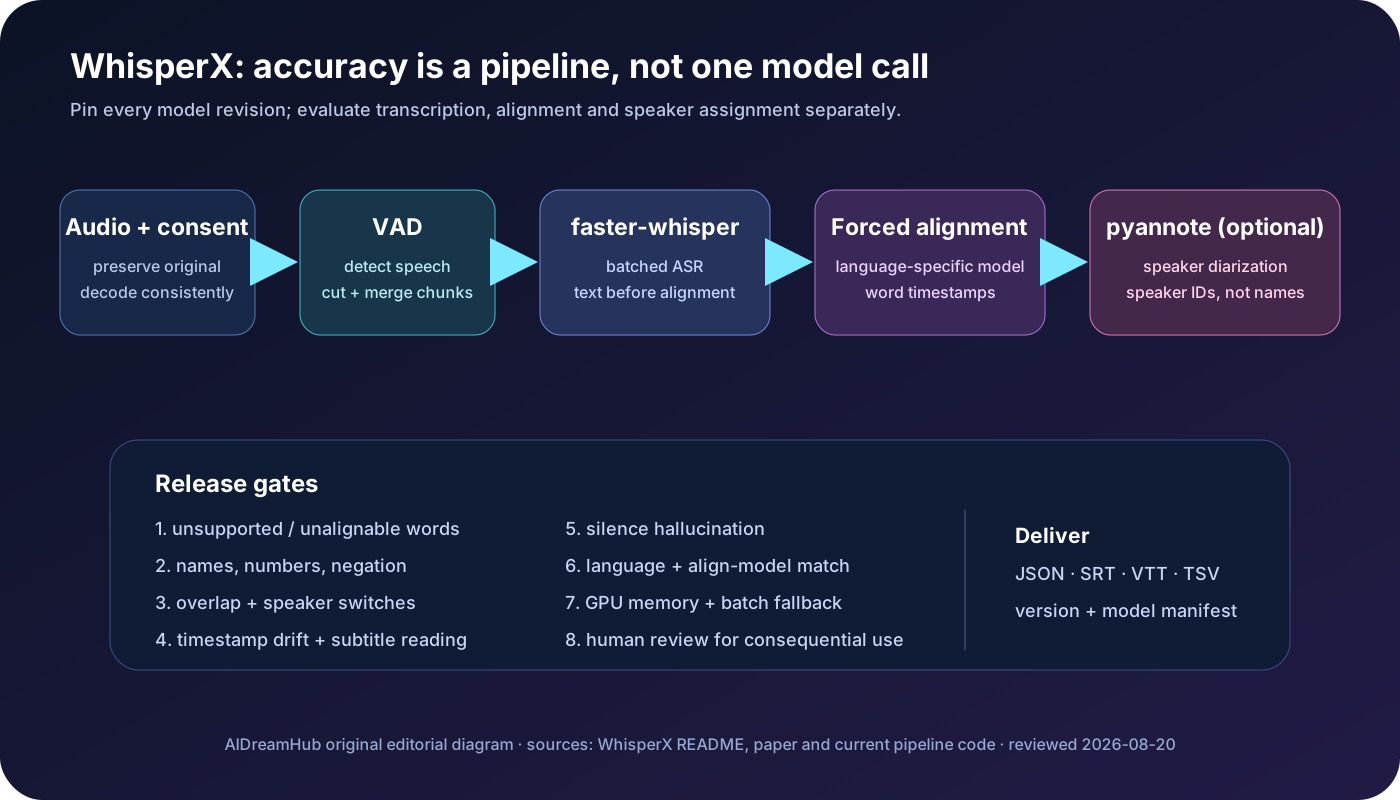
WhisperX는 faster-whisper 배치 전사에 언어별 단어 강제 정렬과 선택적 pyannote 화자 분리를 더하는 장문 음성용 오픈소스 파이프라인입니다.
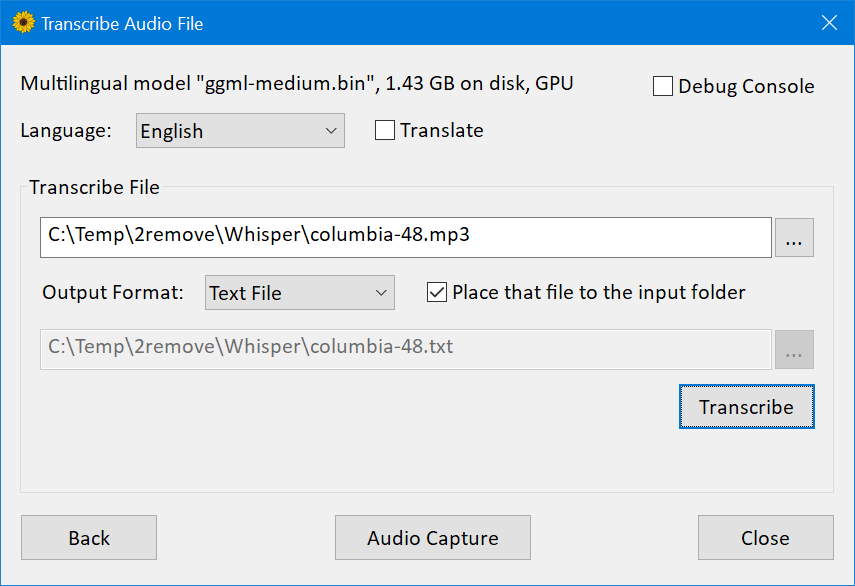
WhisperDesktop은 오디오, 비디오 및 마이크 입력에서 로컬로 OpenAI Whisper을 실행하기 위한 Windows 데스크톱 앱 및 DirectCompute 구현입니다. 이 가이드에서는 설정, 모델, GPU, 자막, 개인 정보 보호 및 대안을 다룹니다.
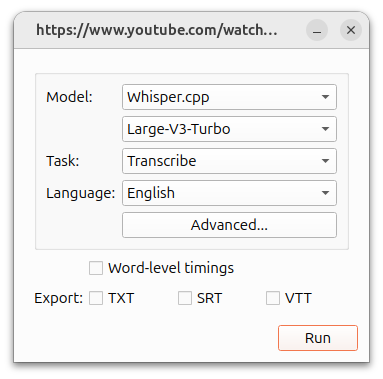
Buzz은 macOS, Windows 및 Linux에서 로컬 Whisper 전사, 자막, 라이브 캡션, 번역 및 화자 레이블 지정을 위한 무료 MIT 라이선스 데스크톱 앱입니다. 이 가이드에서는 백엔드, 하드웨어, 개인 정보 보호, 정확성 테스트, 자막 QA, CLI 자동화 및 클라우드 대안을 비교합니다.
Whisper.cpp은 로컬 전사, 번역, 스트리밍, 서버 및 임베디드 앱을 위한 OpenAI Whisper의 종속성이 적은 C/C++ 구현입니다. 이 가이드에서는 모델, 양자화, 백엔드, 정확성, 개인 정보 보호 및 배포를 다룹니다.