Stable Audio
Stable Audio は Stability AI の生成音声プラットフォームです。テキストから音楽、ループ、ステム、環境音、効果音を作れます。Stable Audio 3.0 は芸術的実験向けで、研究やローカル制作向けの open-weight 選択肢もあります。
Stable AudioAI音楽生成text to music
1310
Stable Audio は Stability AI の生成音声プラットフォームです。テキストから音楽、ループ、ステム、環境音、効果音を作れます。Stable Audio 3.0 は芸術的実験向けで、研究やローカル制作向けの open-weight 選択肢もあります。

Open source library for audio/music generation by Meta, which mainly includes two models, MusicGen: text-to-music model, AudioGen: text-generated sound model. - スマートな AI ツールで生産性を向上。

Bark is a transformer-based text-to-audio model created by Suno. Bark can generate highly realistic, multilingual speech as well as other audio - including music, background noise and simple sound effects. - スマートな AI ツールで生産性を向上。
ElevenLabs Sound Effects は、テキストからカスタムSFX、環境音、ループ、映画的な効果音を生成するツールです。長さ、prompt influence、ループ、複数バリエーション、ダウンロード、APIワークフローに対応します。
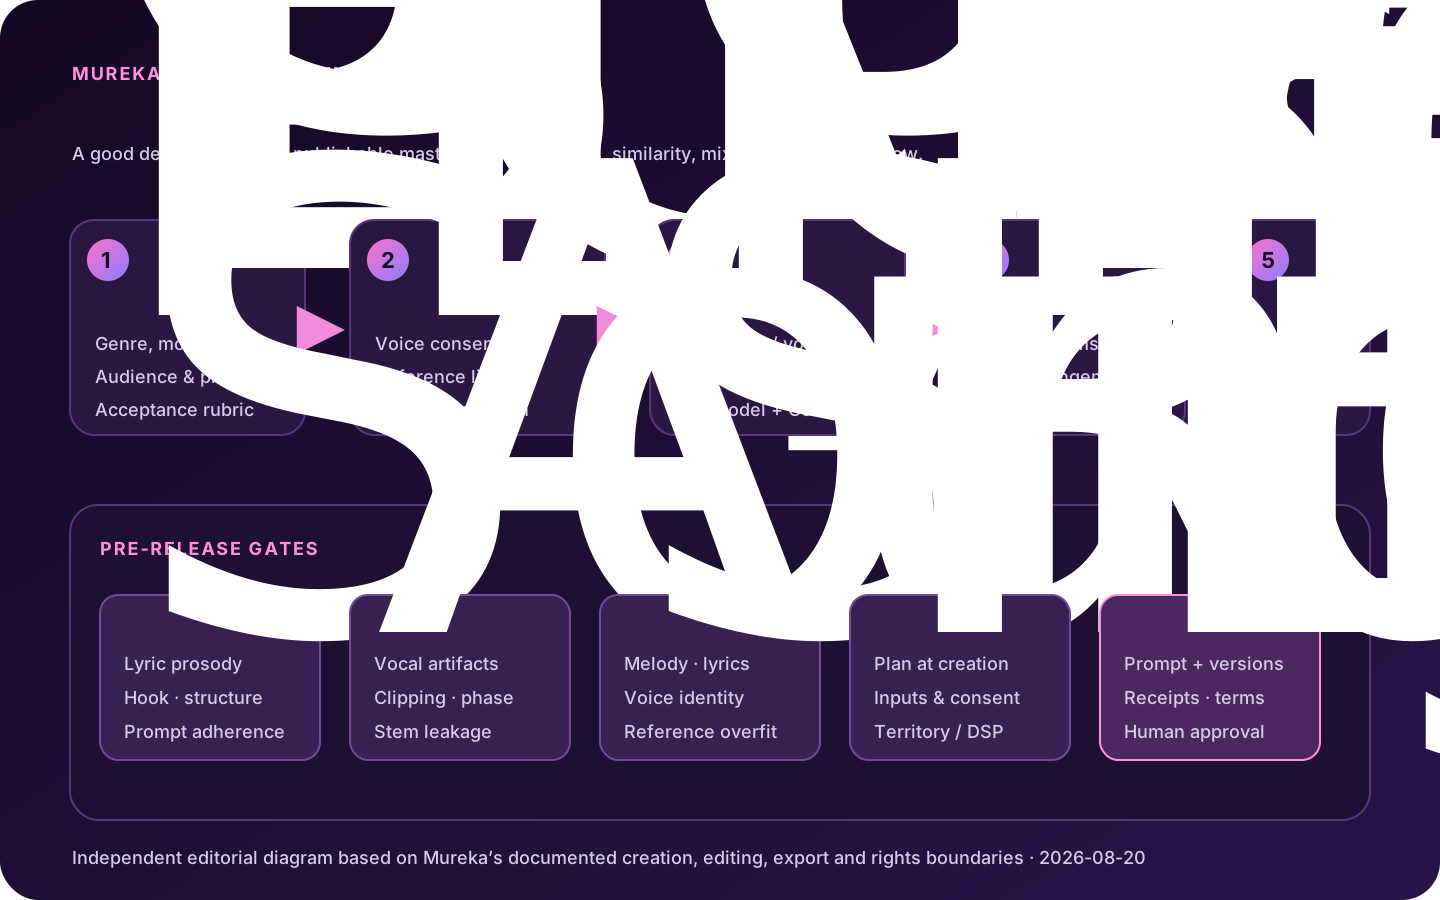
Mureka はプロンプトや歌詞から曲を生成し、参照音声や Vocal ID、区間編集、延長、Remix、ステム分離、書き出しまで扱う AI 音楽制作プラットフォームです。
Create music from simple text prompts by specifying topics, genres, and other descriptors which are then transformed into professional quality tracks. - スマートな AI ツールで生産性を向上。
Create stunning original music for free in seconds using AI. Make your own masterpieces, share with friends, and discover music from artists worldwide. - スマートな AI ツールで生産性を向上。
Split vocal and instrumental tracks quickly and accurately with LALAL.AI. Upload any audio file and receive high-quality extracted tracks in a few seconds. - スマートな AI ツールで生産性を向上。
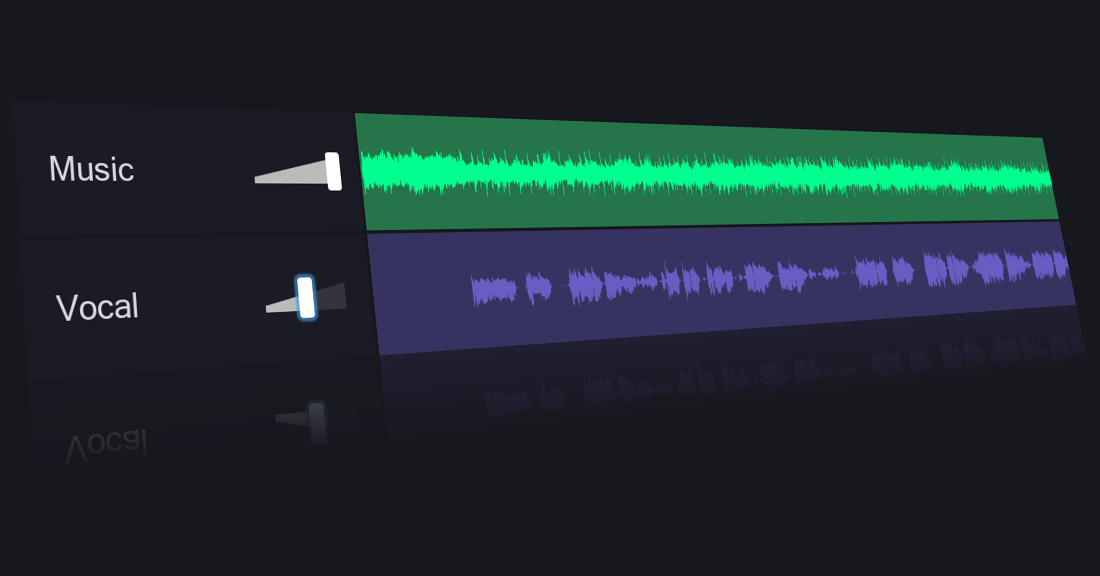
Separate voice from music out of a song free with powerful AI algorithms - スマートな AI ツールで生産性を向上。
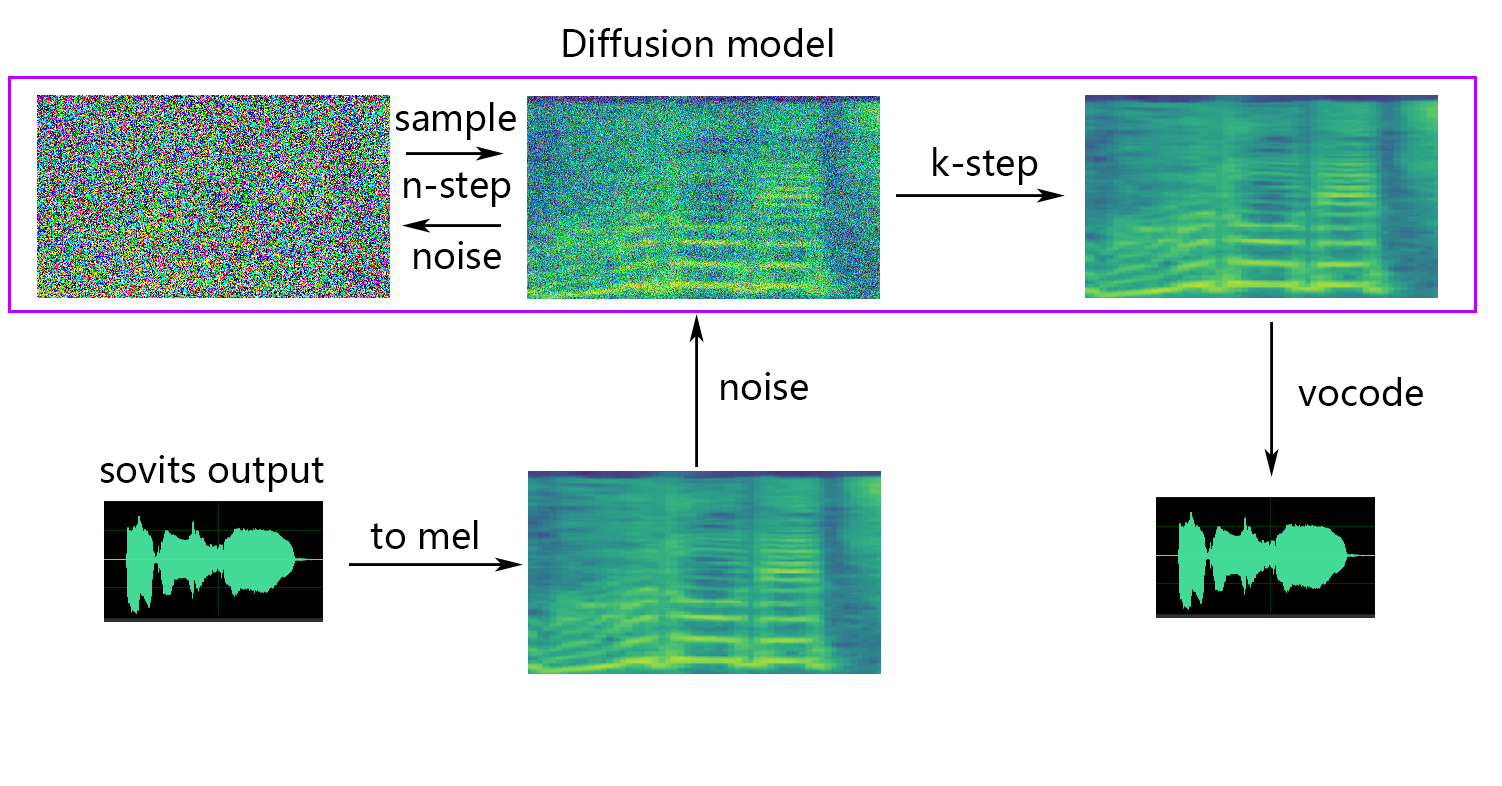
So-VITS-SVC 4.1 は、テキスト読み上げではなく、歌声変換のためのアーカイブされたオープンソース研究フレームワークです。この独立したガイドでは、同意、ライセンス、クリーンなデータセット、F0 とエンコーダー、トレーニング、推論、評価、開示、セキュリティ、および代替手段について説明します。
ShazamはAppleの音楽認識アプリで、周囲や対応アプリ内で流れている曲を識別できます。曲名、歌詞、ビデオ、ライブ情報、Apple Musicへの導線をすばやく得たいユーザーに向いています。
ChatTTS is a text-to-speech model designed specifically for dialogue scenario such as LLM assistant. It supports both English and Chinese languages. - スマートな AI ツールで生産性を向上。
Tetosは、複数のText-to-Speechプロバイダーを統一インターフェースで扱うオープンソースのPython/CLIラッパーです。Edge TTS、OpenAI、Azure、Google、Volcengine、Baiduなどを比較・切り替えたい開発者に向いています。
EmotiVoice は NetEase Youdao の無料オープンソース多音声・プロンプト制御 TTS です。英語と中国語、2000以上の声、感情・話し方制御に対応し、研究、開発、音声アプリのプロトタイプに向いています。
ElevenLabsは、TTS、音声クローン、吹き替え、音声認識、音声エージェント、生成音声APIに対応するAI音声プラットフォームです。
A deep learning toolkit for Text-to-Speech, battle-tested in research and production - スマートな AI ツールで生産性を向上。
Hailuo AI TTSは、MiniMax Audioと関連する多言語テキスト読み上げ、AI音声、音声クローン向けの音声生成ツールです。
The best and most realistic voice tools currently available - スマートな AI ツールで生産性を向上。
IndexTTSはBilibiliのオープンソース、産業レベルの制御可能で効率的なゼロショットTTSシステムです。完成したWeb音声アプリではなく、音声研究者と開発者向けの実験プロジェクトです。
Whisper Webは、Transformers.jsで動くMITライセンスのブラウザ音声認識デモです。端末内で文字起こしし、タイムスタンプ付き結果をTXT/JSONで保存できます。
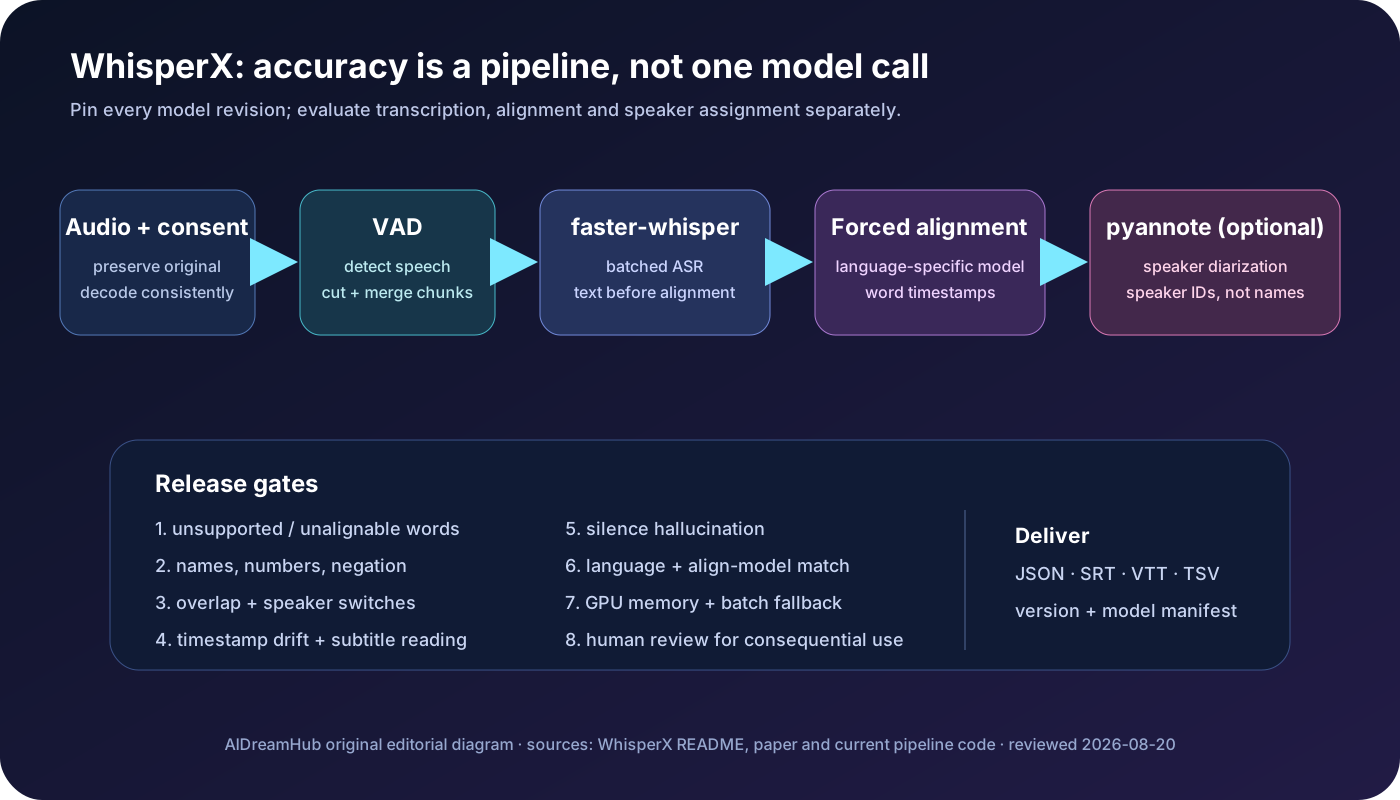
WhisperXは、faster-whisperのバッチ文字起こしに言語別の単語強制アラインメントと任意のpyannote話者分離を加える長時間音声向けOSSパイプラインです。
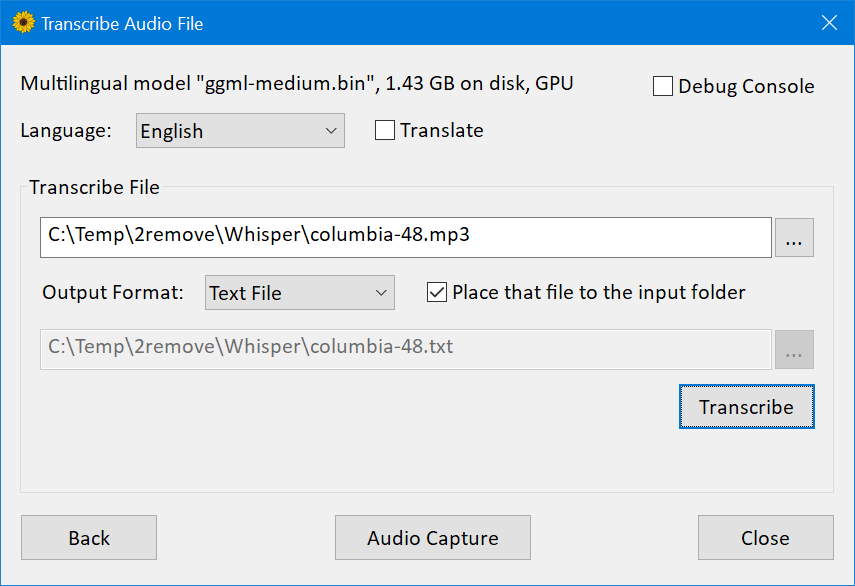
WhisperDesktop は、オーディオ、ビデオ、およびマイク入力でローカルに OpenAI Whisper を実行するための Windows デスクトップ アプリおよび DirectCompute 実装です。このガイドでは、セットアップ、モデル、GPU、字幕、プライバシー、および代替手段について説明します。
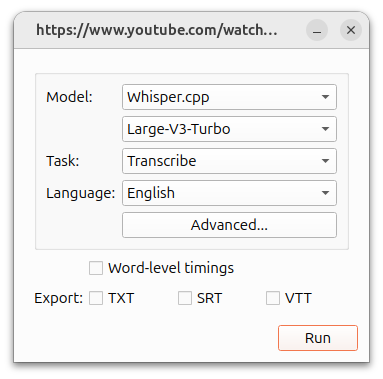
Buzz は、macOS、Windows、Linux 上でローカルの Whisper 文字起こし、字幕、ライブ キャプション、翻訳、話者ラベル付けを行うための MIT ライセンスの無料デスクトップ アプリです。このガイドでは、バックエンド、ハードウェア、プライバシー、精度テスト、字幕 QA、CLI 自動化、およびクラウド代替手段を比較します。
Whisper.cpp は、ローカルの文字起こし、翻訳、ストリーミング、サーバー、組み込みアプリ向けの OpenAI Whisper の依存関係の少ない C/C++ 実装です。このガイドでは、モデル、量子化、バックエンド、精度、プライバシー、展開について説明します。