AnyGen
AnyGen est un workspace IA pour rapports, documents, présentations, analyses, plans et livrables professionnels.
AnyGenAI workspaceAI assistant
1940
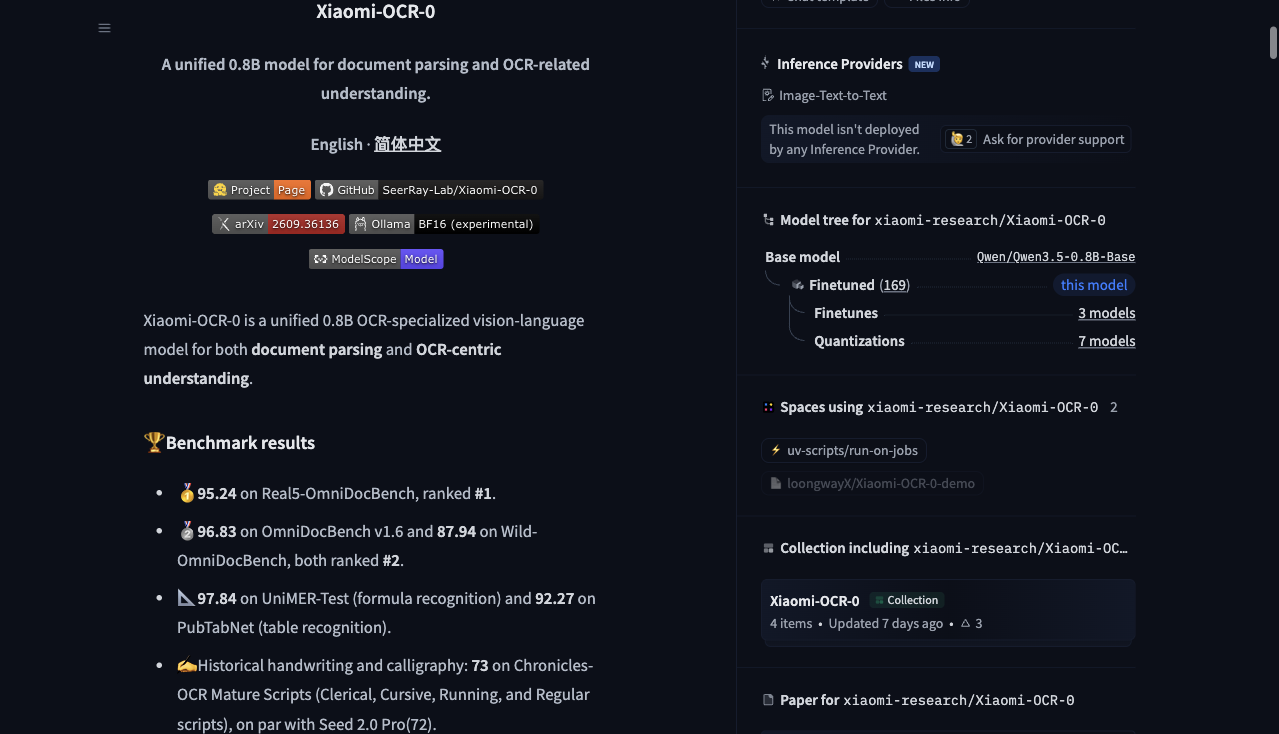
Xiaomi-OCR-0 est un modèle documentaire de 0,8B pour pages, tableaux, formules, questions et extraction structurée. Sa valeur dépend aussi des validations après génération.
0
Views
0
Likes
Nov 2026
Added
huggingface.co
Website
A quick visual look at Xiaomi-OCR-0 before you visit the official site.
Editorial Review
Sources vérifiées le 6 novembre 2026. Affirmations de l’éditeur et essais tiers sont distingués ; pas de benchmark AIDreamHub exécuté.
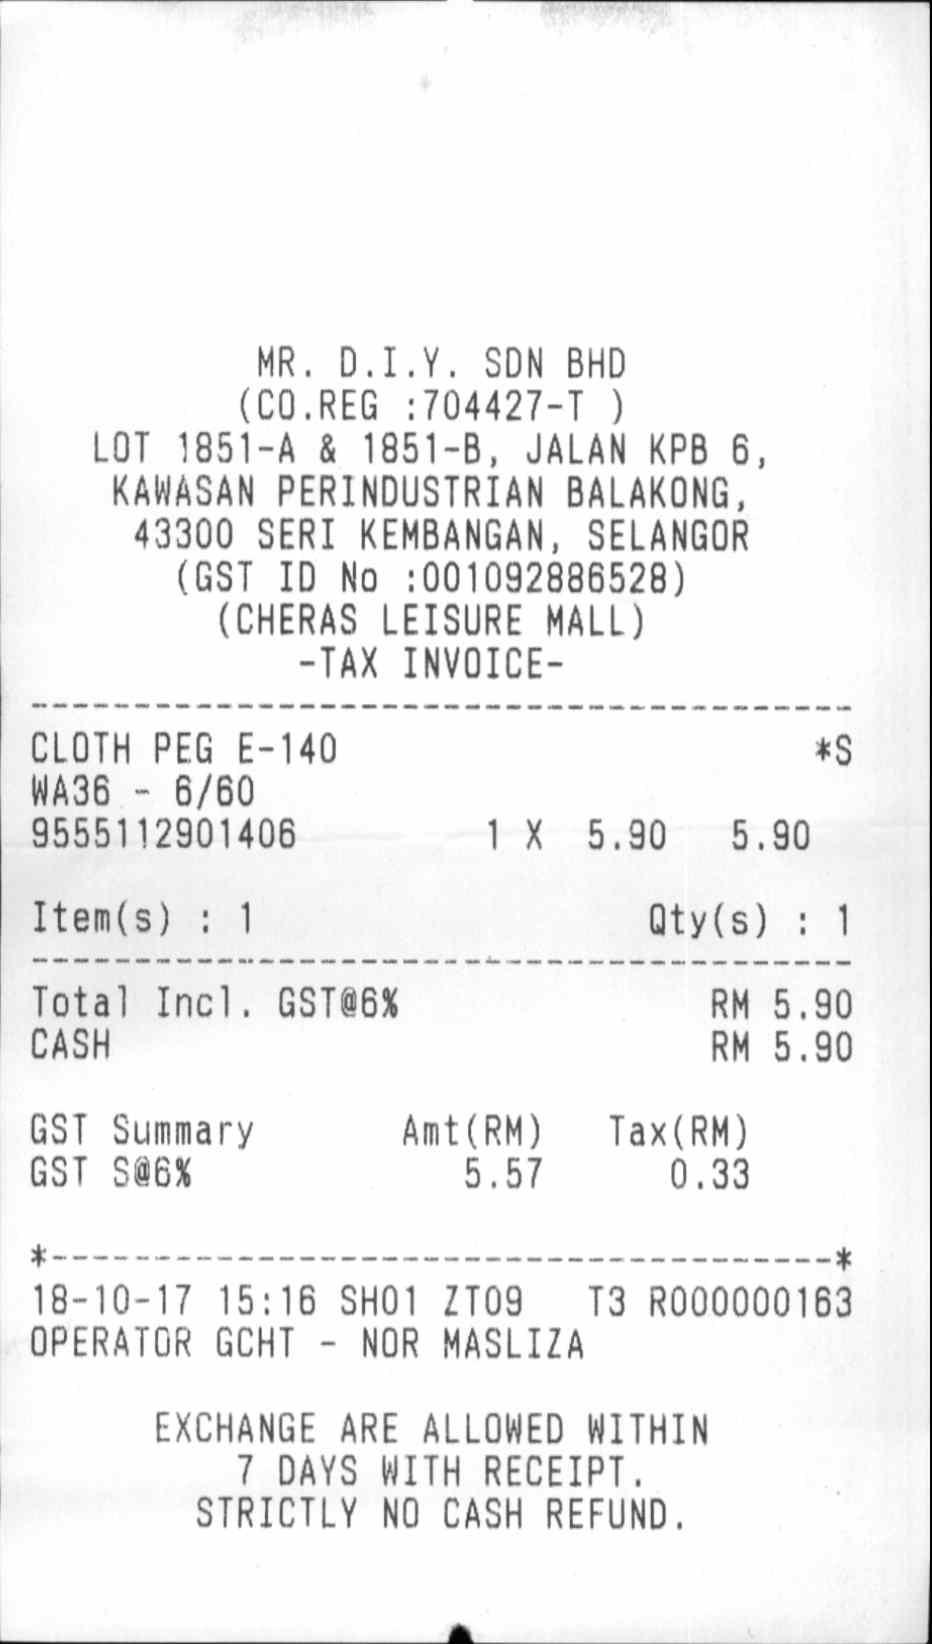
Fondé sur Qwen3.5-0.8B-Base, Xiaomi-OCR-0 combine parsing, questions centrées sur l’OCR et extraction d’informations. Un pilote pertinent peut viser fournisseur, date, devise et total d’une famille précise de reçus.
La réponse n’est pas encore une écriture vérifiée. Préparation d’image, pages PDF, schéma, règles déterministes, exceptions et export font partie du produit à construire. Le bénéfice doit être moins de corrections, pas simplement un CSV rempli.
Page officielle capturée par AIDreamHub, pas une exécution locale du produit.
L’éditeur publie 96,83 sur OmniDocBench v1.6, 95,24 sur Real5 et 87,94 sur Wild. Il s’agit de parsing, pas d’exactitude des champs de factures ni de taux de pages parfaites. Le rapport utilise PP-DocLayoutV3 pour Real5 ; un traitement de page entière n’hérite pas automatiquement de ce résultat.
PaddleOCR-VL-1.6 obtient 96,33, 93,19 et 87,36 dans le même tableau. Ces valeurs proches ne prouvent aucun avantage métier sur vos documents. Nous avons vérifié les sources, sans exécuter le benchmark. La recherche a surtout fourni des présentations de lancement, pas un consensus indépendant étendu.
| Comparaison de l’éditeur | OmniDocBench v1.6 | Real5 | Wild |
|---|---|---|---|
| Xiaomi-OCR-0 · 0.8B | 96.83 | 95.24 | 87.94 |
| PaddleOCR-VL-1.6 · 0.9B | 96.33 | 93.19 | 87.36 |
Le dépôt documente Python 3.10+, une démo web, MCP et des moteurs séparés. SGLang ou vLLM exigent une plateforme compatible ; le parcours Ollama expérimental utilise un paquet BF16 communautaire. Les commandes ci-dessous reprennent le parcours officiel, sans prétendre à une installation testée ici.
Gardez Ollama actif, examinez les dépendances dans un environnement isolé et ouvrez http://127.0.0.1:8787. Télécharger le modèle ne règle pas seul prétraitement et décodage : utilisez Demo ou MCP. Le mode régions ajoute PaddlePaddle, PaddleX et PP-DocLayoutV3, contrairement à l’OCR de page entière, KIE et VQA.
ollama pull longwayxu/xiaomi-ocr-0:bf16
git clone https://github.com/xiaomi-research/Xiaomi-OCR-0.git
cd Xiaomi-OCR-0
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
export XIAOMI_OCR_BACKEND=ollama
export XIAOMI_OCR_MODEL=longwayxu/xiaomi-ocr-0:bf16
export XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:11434/v1
python demo/server.py --port 8787Commencez par des exemples réels anonymisés. Définissez supplier, document_number, invoice_date, currency, subtotal, tax et total. Autorisez null quand le texte est illisible et interdisez les suppositions. Reliez image, réponse brute et ligne normalisée.
Séparez développement et test réservé par fournisseur ou gabarit. Incluez flou, rotation, devise absente, remboursements et documents multipages. Mesurez champs exacts et lignes entièrement correctes séparément : neuf bonnes valeurs ne compensent pas un total erroné.
Validez le schéma JSON. Conservez les numéros en chaînes avec leurs zéros initiaux et normalisez dates et devises uniquement sans ambiguïté. Réconciliez les montants en tenant compte des remises, frais et arrondis ; signalez l’écart au lieu d’inventer une correction.
Neutralisez les préfixes de formules des chaînes CSV non fiables avant ouverture dans un tableur. Gardez une version brute et une exportation sécurisée distinctes. Mesurez aussi les minutes de correction par ligne acceptée et le taux de revue humaine.
| Champ | Vérification | En cas d’échec |
|---|---|---|
| Numéro | Chaîne et zéros initiaux | Comparer à l’image |
| Date / devise | Sens non ambigu | Laisser vide ou revoir |
| Montants | Précision et rapprochement | Signaler la différence |
| Chaînes CSV | Éviter les formules exécutables | Séparer brut et export sûr |
Comparez PaddleOCR-VL pour les mises en page complexes, OCR classique et règles pour les formulaires stables, et un VLM plus puissant pour l’interprétation inhabituelle. Ce sont des options de workflow, pas un classement mesuré par nous.
Utilisez images réservées, champs et règles identiques. Mémoire réelle, maintenance et corrections déterminent l’intérêt du petit modèle. 0,8B ne fixe ni RAM globale, ni durée par page, ni compatibilité de chaque quantification.
| Parcours | Raison de comparer | Question d’acceptation |
|---|---|---|
| Xiaomi-OCR-0 | Parsing et extraction compacts | Les lignes complètes sont-elles justes ? |
| PaddleOCR-VL | Structure documentaire | Moins de contenu oublié ? |
| OCR + règles | Formulaires stables | Résiste aux changements de gabarit ? |
Le checkpoint porte Apache-2.0 ; les composants conservent leurs conditions. Téléchargez les fichiers avant le mode hors ligne et vérifiez images, journaux et PDF temporaires. Un modèle local ne rend pas une démo distante privée.
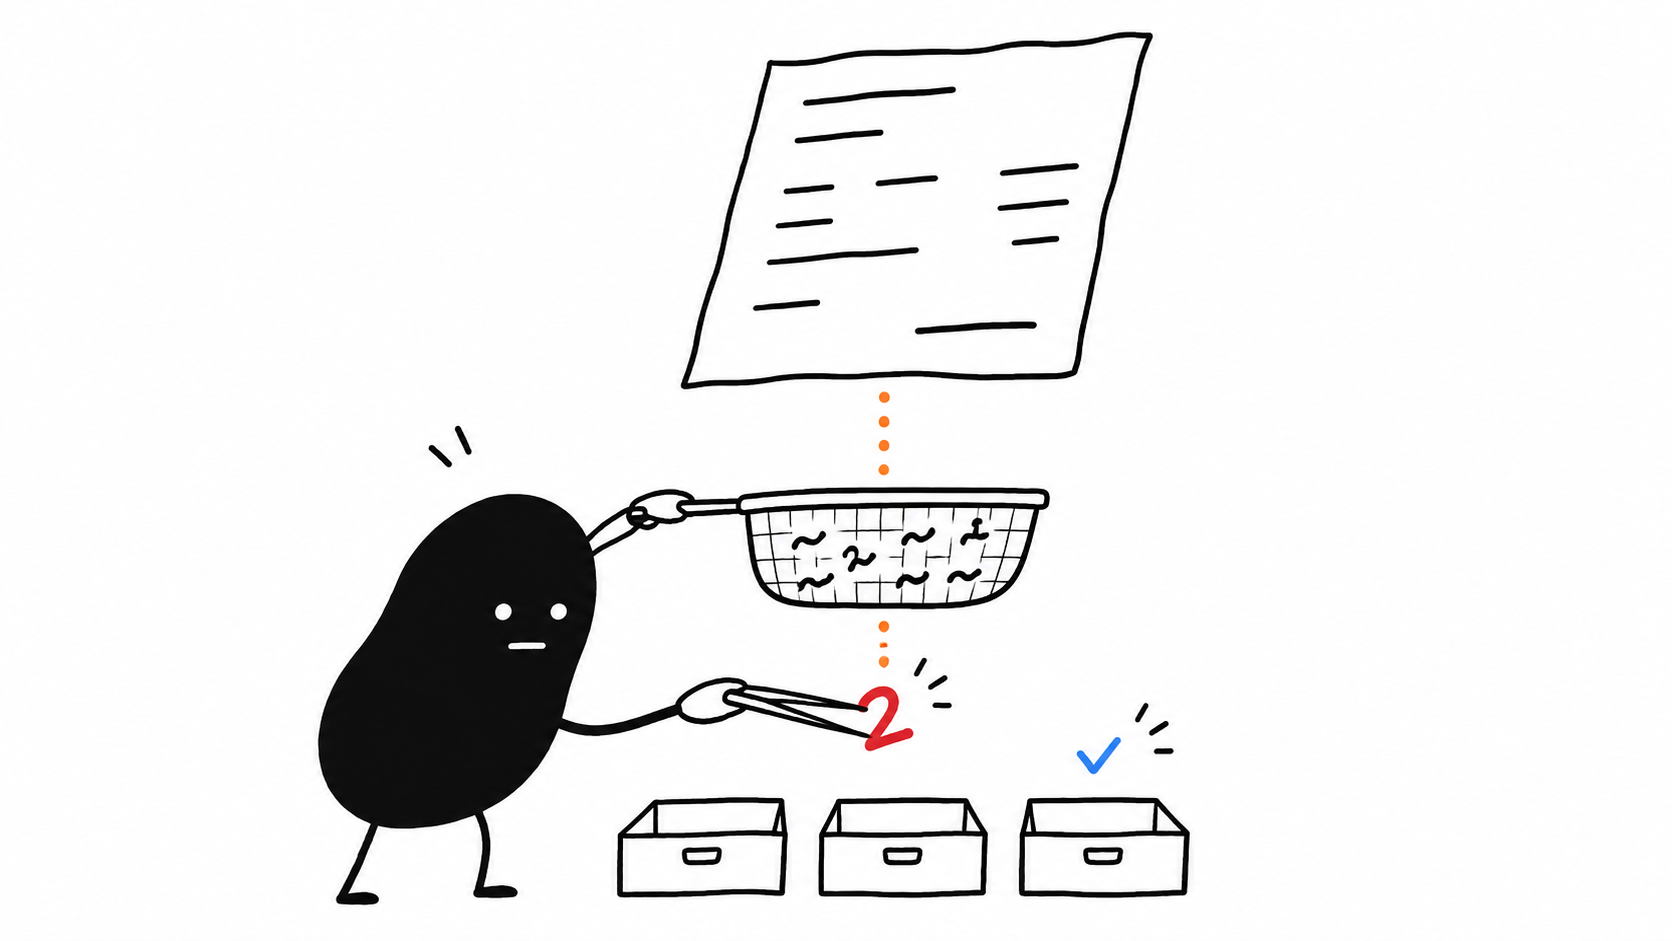
Ollama est expérimental et sept tests d’alignement ne démontrent pas une parité générale. Un lien GGUF communautaire était indisponible à la vérification et n’est pas recommandé ici. Suivez le parcours officiel actuel et notez modèle, projecteur et moteur. Le dessin est une métaphore, pas une sortie OCR produite.
Il faut contrôler schéma, dates, devises, rapprochement, formules et exceptions. Gardez image et réponse brute. L’unité utile est la ligne complète acceptée ; un JSON valide ne garantit pas des faits exacts.
Pas automatiquement. Les benchmarks d’origine et quelques tests d’alignement ne démontrent pas l’équivalence des conversions. Prétraitement, projecteur visuel, moteur et décodage comptent. Évaluez le paquet réellement utilisé sur vos documents réservés.
Le nombre de paramètres n’est pas une garantie matérielle. Moteur, images, contexte et modèles de mise en page ajoutent des contraintes. Préparez les fichiers et vérifiez la plateforme ; le dépôt distingue GPU compatibles et Ollama expérimental.
Visit the official website to get started
Have an AI tool to share?
Get your product in front of people actively exploring AI tools.
Submit Your ToolAnyGen est un workspace IA pour rapports, documents, présentations, analyses, plans et livrables professionnels.
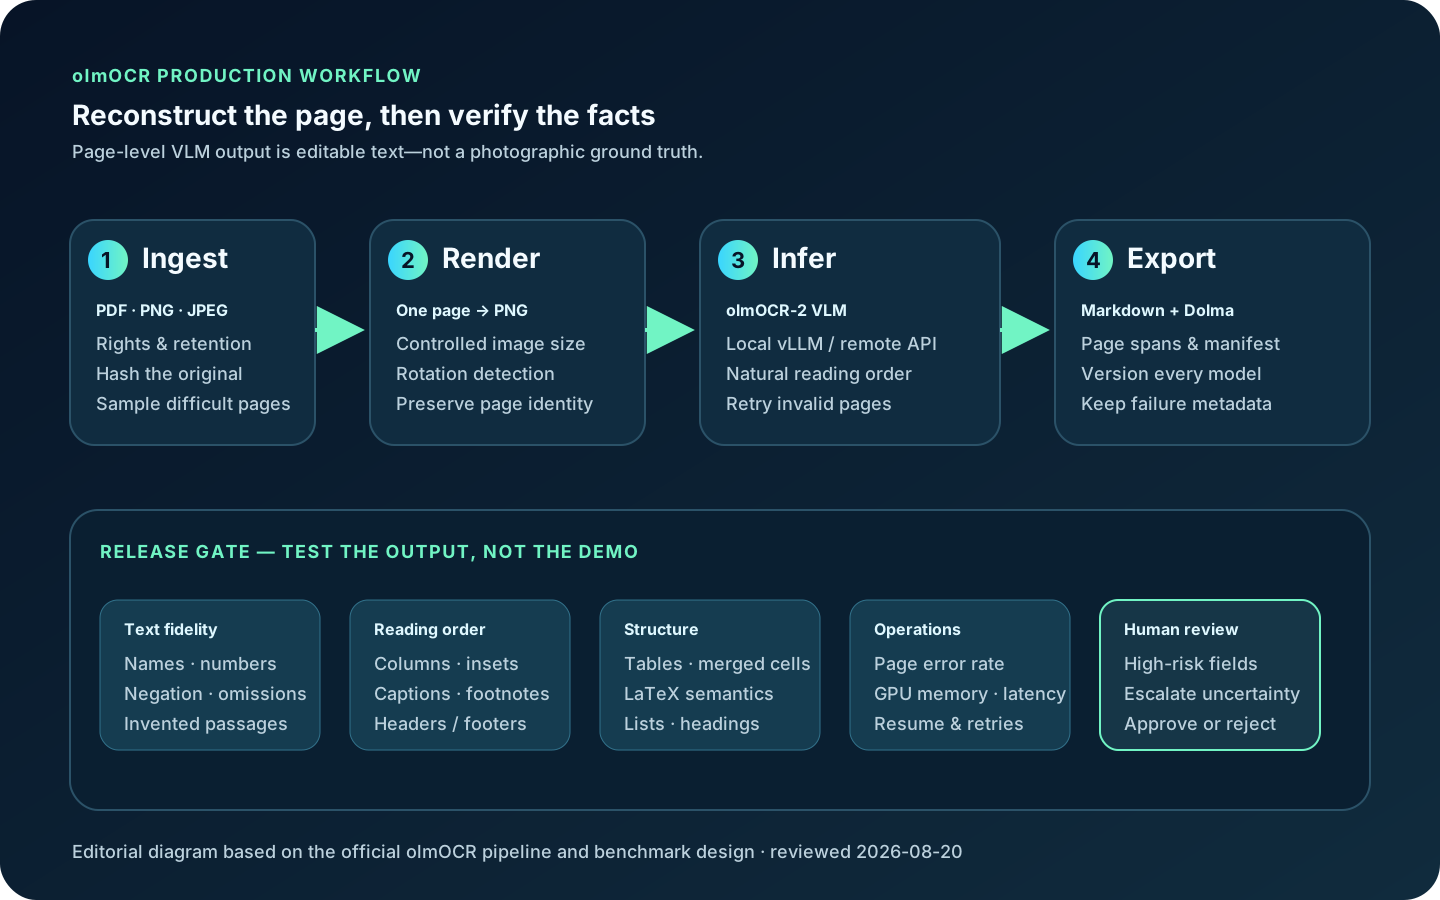
olmOCR est l’outil open source d’AI2 pour reconstruire des documents sur GPU : il transforme des pages PDF, PNG et JPEG, tableaux et formules compris, en Markdown ou texte naturellement ordonné.
Gamma est un espace de travail assisté par IA pour créer des présentations, des documents, des pages Web, des publications sociales et des graphiques modifiables. Ce guide indépendant couvre les modes de création, les limites actuelles du plan, les importations et les exportations, l'assurance qualité de la marque et de l'accessibilité, la vérification des faits, la publication du site, la confidentialité et les alternatives.
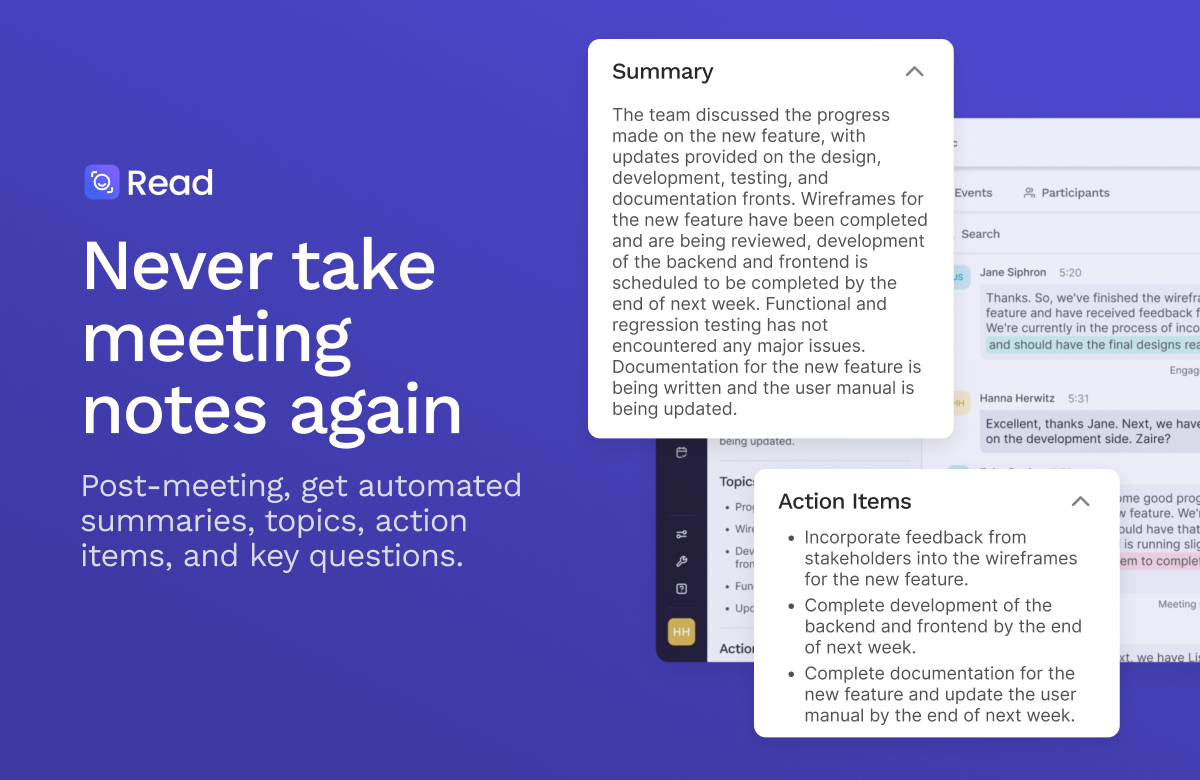
Read AI Digital Twin - work digital twin. À partir de sources officielles et publiques fiables, cette fiche résume usages, forces, limites et alternatives. Avant adoption, il faut vérifier prix, permissions, confidentialité, disponibilité et qualité réelle.