Verdict indépendant :LibreCrawl est un robot d'exploration de bureau SEO sous licence MIT positionné comme une alternative gratuite et personnalisable pour explorer des sites, extraire des données SEO et exporter des résultats. Ce qui lui convient le mieux, ce sont les consultants indépendants et les équipes techniques qui valorisent le contrôle local et sont prêts à tester un robot plus jeune. La principale erreur d’adoption serait de considérer un référentiel ouvert ou un nombre élevé d’étoiles comme une preuve que ses recommandations, données ou scores sont corrects pour chaque site.
Son différenciateur le plus important est l’inspectabilité. L'adoption doit toujours être décidée par la parité d'exploration et le taux de faux positifs sur le propre site de l'équipe.
Ce que fait réellement LibreCrawl
LibreCrawl doit être évalué comme un outil d'exploration, et non comme une plate-forme SEO universelle. La description vérifiée du référentiel est la suivante : "Explorateur d'exploration de bureau gratuit SEO - alternative open source à Screaming Frog et outils similaires. Explorez des sites Web, analysez les liens, extrayez les données SEO et exportez les résultats sans frais d'abonnement. Entièrement personnalisable et extensible !" La distinction est importante car un robot d'exploration, une bibliothèque de données structurées et un connecteur MCP résolvent différentes couches du flux de travail SEO.
| Capacité vérifiée | Signification pratique |
|---|---|
| Se concentre sur l'exploration du bureau local sans abonnement logiciel récurrent. | Vérifiez la configuration et la version officielles avant de vous y fier. |
| Le code ouvert peut être étendu pour une extraction personnalisée et des contrôles spécifiques à une équipe. | Traitez les intégrations comme des limites distinctes de confiance et de coût. |
| Le projet a débuté en 2025, donc son comportement à l'échelle, sa couverture de rendu et la qualité des rapports doivent être comparés plutôt que déduits de la liste des fonctionnalités. | Comparez le comportement sur un site ou un compte représentatif. |
Aperçu actuel des preuves GitHub
Le tableau ci-dessous a été capturé le 19 octobre 2026. « Dernière » signifie l'activité récente du référentiel dans cette revue, tandis que « chaud » est un mélange d'attention et d'activité. Aucun des deux termes n’est une garantie de qualité.
| Preuve | Observé | Comment l'interpréter |
|---|---|---|
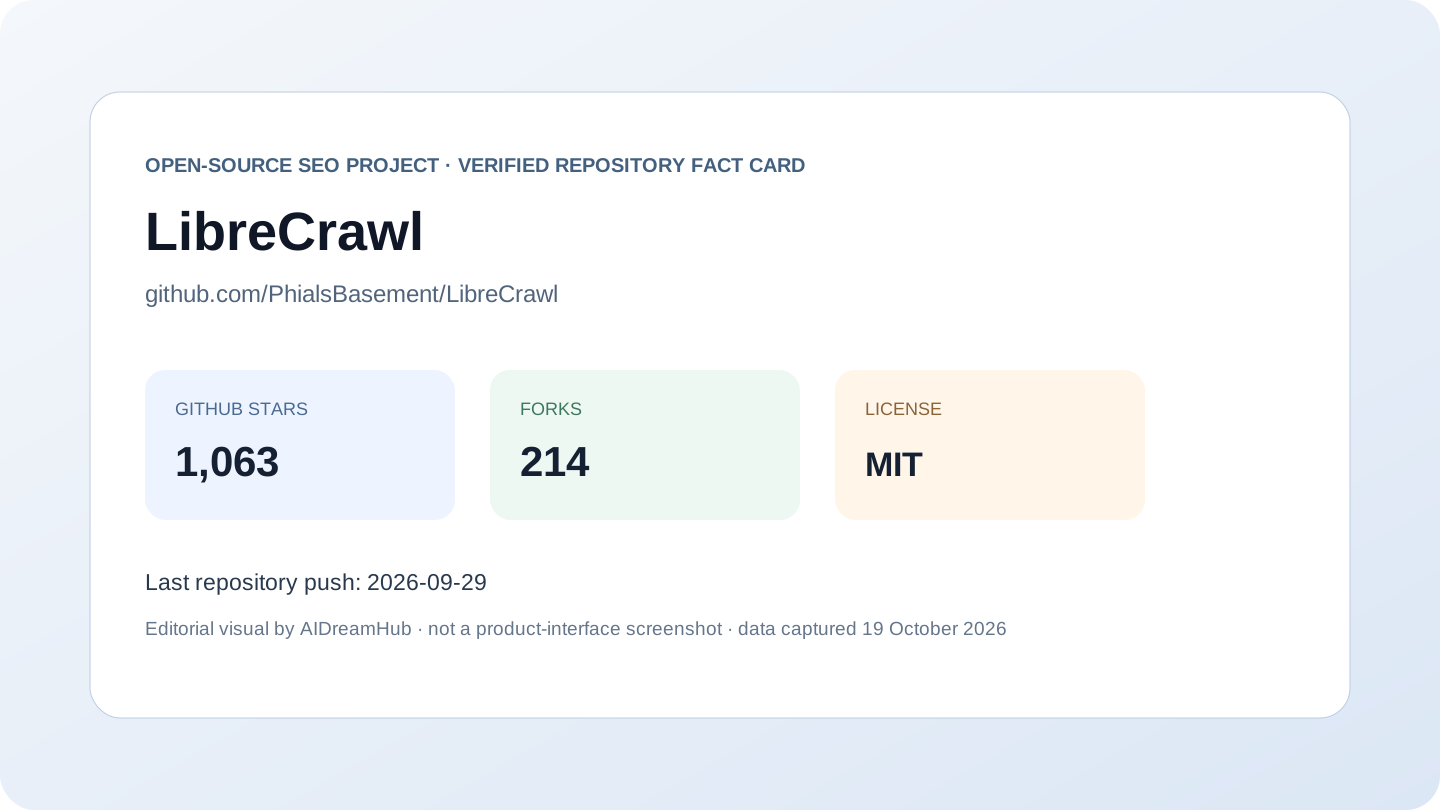
| Activité du référentiel | 1 063 étoiles · 214 fourchettes | Attention de la communauté et signal de réutilisation ; pas une preuve des résultats SEO |
| Dernière poussée | 2026-09-29 | Activité de code récente ; inspecter les versions et les modifications majeures avant la production |
| Licence | MIT | Confirmer les obligations de distribution, d'utilisation du SaaS et de modifications |
| Pile principale | Python | Indique les compétences de maintenance probables, et non l'exhaustivité des fonctionnalités |
Flux de travail les mieux adaptés
Meilleur ajustement :des consultants indépendants et des équipes techniques qui valorisent le contrôle local et sont prêts à tester un robot plus jeune.
- Créez un inventaire local des titres, des vedettes, des canoniques et des codes de statut.
- Exportez les lignes d’analyse pour une feuille de calcul ou une analyse personnalisée.
- Ajoutez des règles d'extraction ou d'émission spécifiques au projet dans un fork.
Point de départ pratique :Comparez un sous-répertoire représentatif à un robot d'exploration établi, comparez la découverte d'URL et la sortie rendue, mesurez l'utilisation de la mémoire et conservez un fichier de configuration reproductible.
Limites, sécurité et coûts d’exploitation
- Les ressources du bureau limitent les analyses très volumineuses et le rendu JavaScript peut augmenter le temps et l'utilisation de la mémoire.
- L'Open Source ne garantit pas un modèle de problème mature, une réponse de support ou une cadence de mise à jour.
- Les résultats du robot d'exploration nécessitent toujours des journaux, des analyses et des preuves Search Console pour la priorisation.
L'open source supprime une forme de verrouillage, mais il ne supprime pas le temps d'ingénierie, les frais de modèle ou d'API, les coûts de navigateur/proxy, les conditions du fournisseur de données, le travail d'authentification, les sauvegardes ou les risques de mise à niveau. Mappez chaque service externe et chaque action compatible en écriture avant utilisation en production.
LibreCrawl par rapport aux alternatives
| Options | Choisissez-le quand | Compromis |
|---|---|---|
| Screaming Frog | exploration technique configurable mature | licence commerciale au-dessus de la limite gratuite |
| Robot d'exploration SiteOne | SEO plus sécurité, accessibilité et performances | portée plus large, flux de travail différent |
| SEOnaut | audits récurrents auto-hébergés | configuration du serveur et de la base de données au lieu d'une utilisation sur un ordinateur de bureau |
La comparaison est basée sur les tâches et ne prétend pas qu’un produit est universellement meilleur. Une bibliothèque étroite peut surpasser une suite dans son cadre, tandis qu'un robot commercial mature peut être moins cher que la maintenance d'un outil ouvert à grande échelle.
Une évaluation en sept étapes avant l’adoption
- 1.Définissez une décision et un ensemble de tests limités avant d'installer ou de connecter des comptes.
- 2.Épinglez la révision ou la version du référentiel et enregistrez la configuration utilisée.
- 3.Vérifiez plusieurs sorties par rapport à la page en direct, à la console source ou à un autre outil indépendant.
- 4.Séparez les observations déterministes des scores, des estimations et des recommandations écrites par le modèle.
- 5.Mesurez les faux positifs, la couverture manquante, la durée d’exécution et le coût du fournisseur sur un échantillon réaliste.
- 6.Utilisez les informations d'identification avec le moindre privilège ; exiger une approbation pour les modifications, les soumissions, les purges ou la publication.
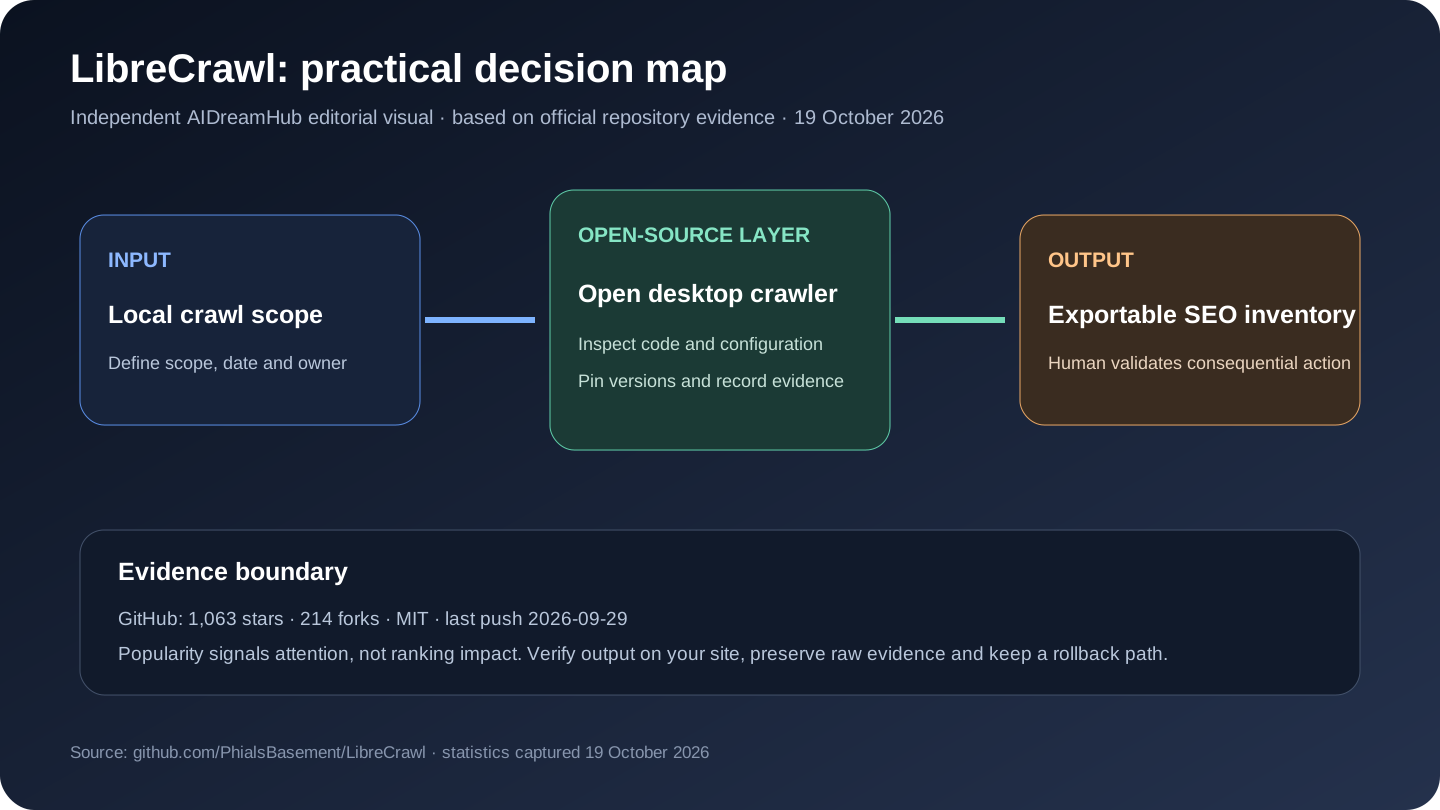
- 7.Conservez les exportations brutes et un plan de restauration afin que le résultat puisse être audité après une mise à jour.
Notre prise indépendante
Son différenciateur le plus important est l’inspectabilité. L'adoption doit toujours être décidée par la parité d'exploration et le taux de faux positifs sur le propre site de l'équipe. C'est aussi la limite de la décision : conserver l'outil s'il produit des preuves reproductibles et réduit le travail sur un chantier réel ; rejetez-le si l'équipe reçoit principalement plus de partitions, de prose ou de volume de numéros sans décisions plus claires.
Questions fréquemment posées
Est-ce vraiment open source ?
L'API GitHub a signalé MIT le 19 octobre 2026. Consultez le fichier de licence du référentiel et les licences de dépendance pour connaître les droits et obligations exacts. Une API cloud connectée ou un service hébergé peut avoir des termes distincts même lorsque le code client est ouvert.
La popularité de GitHub signifie-t-elle que cela améliore le classement ?
Les étoiles et les fourchettes indiquent l'attention et la réutilisation, et non l'amélioration du classement, l'exactitude des données ou l'adéquation à un site particulier. Utilisez une évaluation contrôlée avec Search Console, des analyses et une sortie vérifiée manuellement.
Pour qui est-ce le mieux ?
LibreCrawl convient mieux aux consultants indépendants et aux équipes techniques qui valorisent le contrôle local et sont prêts à tester un robot d'exploration plus jeune. Cela ne convient pas lorsque l'équipe ne peut pas exploiter son environnement d'exécution, vérifier ses preuves ou posséder les autorisations qu'elle demande.
Que faut-il tester en premier ?
Utilisez un flux de travail représentatif : créez un inventaire local des titres, des vedettes, des canoniques et des codes de statut. Enregistrez les entrées, les résultats bruts, le temps, les échecs et tout coût externe, puis comparez-les avec la méthode actuelle de l'équipe.
Peut-il remplacer une suite commerciale SEO ?
Généralement uniquement pour une tranche de travail définie. Les outils de flux de travail et d'audit open source incluent rarement le même index de backlinks propriétaire, la même couverture SERP historique, l'organisation de support, les autorisations et les mêmes rapports clients raffinés qu'une suite payante mature.
Comment utiliser LibreCrawl : Quick Start
Ce flux de travail est condensé du README et de la documentation officiels du projet. Exécutez-le d’abord sur un site de test, une propriété de test ou un environnement local ; vérifiez à nouveau la source liée lorsque les versions changent.
Conditions préalables
- Docker et Docker Composez pour le chemin recommandé
- Git
- Suffisamment de mémoire locale et de disque pour l'exploration et le rendu JavaScript facultatif
Installer et exécuter
git clone https://github.com/PhialsBasement/LibreCrawl.git
cd LibreCrawl
cp .env.example .env
docker compose up -d

# Open the local interface
http://localhost:5000
Flux de travail de première utilisation
- Clonez le référentiel et examinez l'exemple de fichier d'environnement.
- Gardez LOCAL_MODE activé uniquement pour un usage local privé et démarrez les services Docker.
- Ouvrez l'interface utilisateur locale et créez une petite analyse avec des limites d'URL et de concurrence conservatrices.
- Exportez le résultat et comparez les URL découvertes, les canoniques et le résultat rendu avec un deuxième robot d'exploration.
Comment confirmer que cela a fonctionné
L'interface locale s'ouvre, l'exploration limitée se termine et les lignes exportées correspondent aux pages vérifiées manuellement sans inflation d'URL inexpliquée.
Avant utilisation en production
Le script de démarrage automatique peut installer des dépendances et des navigateurs. Examinez-le avant utilisation, n’exposez jamais le mode local non authentifié à Internet et évaluez l’utilisation des ressources avant de grandes analyses.
Source officielle Quick Start : PhialsBasement/LibreCrawl LISEZMOI.
Sources examinées
- Dépôt officiel GitHub
- README officiel
- Sorties officielles
- Historique de validation
- Licence de référentiel
Revue éditoriale mise à jour le 19 octobre 2026. Les statistiques du référentiel, la documentation, les dépendances et les conditions du service hébergé peuvent changer. Vérifiez les sources officielles liées avant l’installation, l’approvisionnement ou le déploiement.