LFM3-1.7B
LFM3-1.7B est le petit modèle de texte de Liquid AI pour extraction locale et sélection d’outils limitée. Plusieurs formats et une licence commerciale spécifique sont proposés.
1
Views
0
Likes
Nov 2026
Added
huggingface.co
Website
Tags
Product Preview
A quick visual look at LFM3-1.7B before you visit the official site.
Editorial Review
About LFM3-1.7B
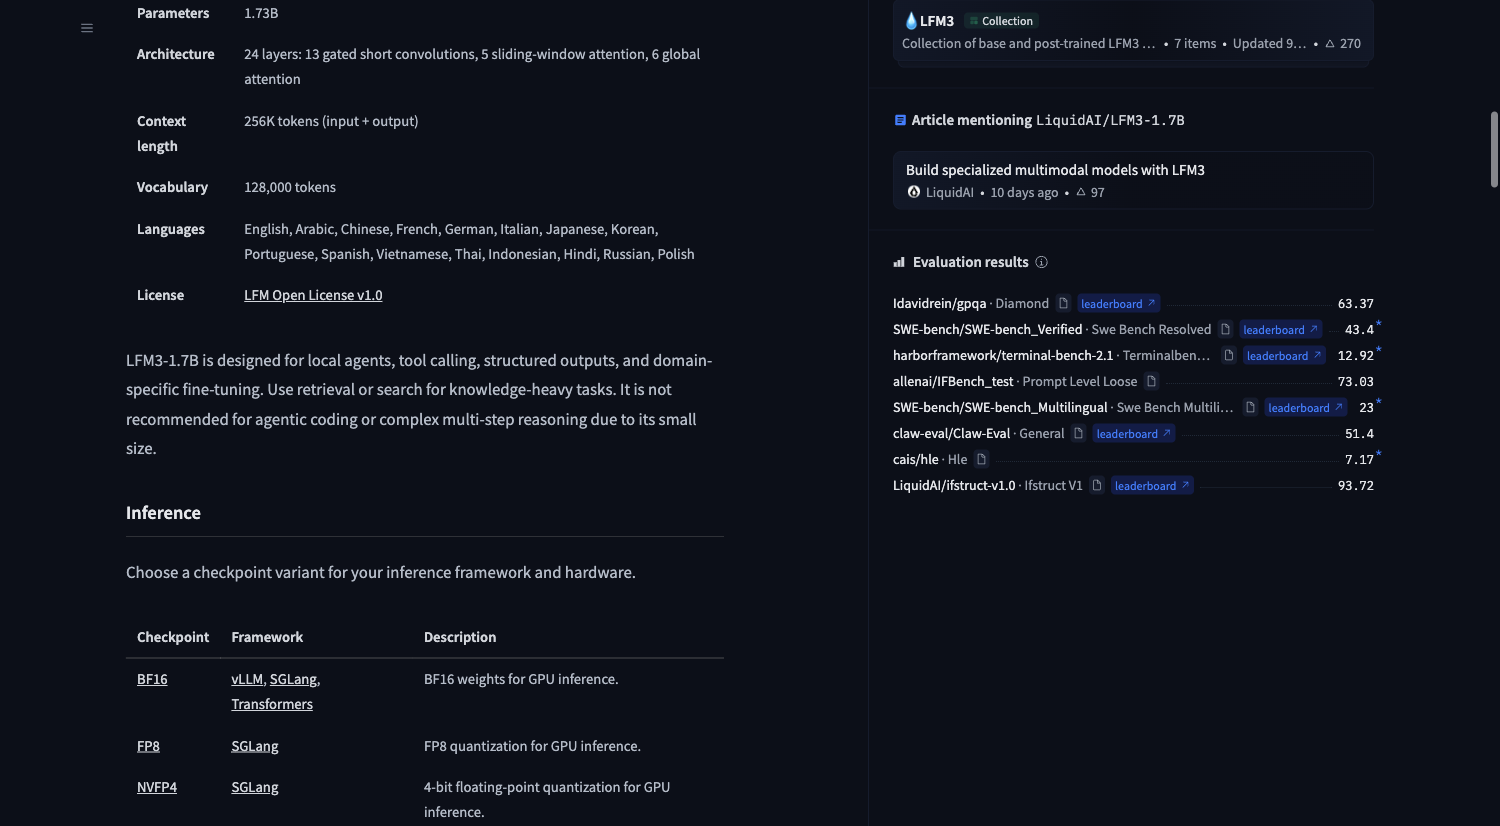
Sources vérifiées le 6 novembre 2026. Affirmations de l’éditeur et essais tiers sont distingués ; pas de benchmark AIDreamHub exécuté.
Un composant local au périmètre précis
Ce modèle post-entraîné de 1,73B combine sur 24 couches convolutions courtes, attention locale et globale. La fiche annonce 256K pour entrée plus sortie et 16 langues. Ce ne sont pas des garanties sur tout appareil et toute tâche.
Commencez par quelques outils, un schéma strict ou des réponses à partir de pièces fournies. L’éditeur déconseille code agentique et raisonnement complexe à plusieurs étapes. Un composant utile ne doit pas être présenté comme assistant universel.
Page officielle capturée par AIDreamHub, pas une exécution locale du produit.
Relier mémoire et charge réelle
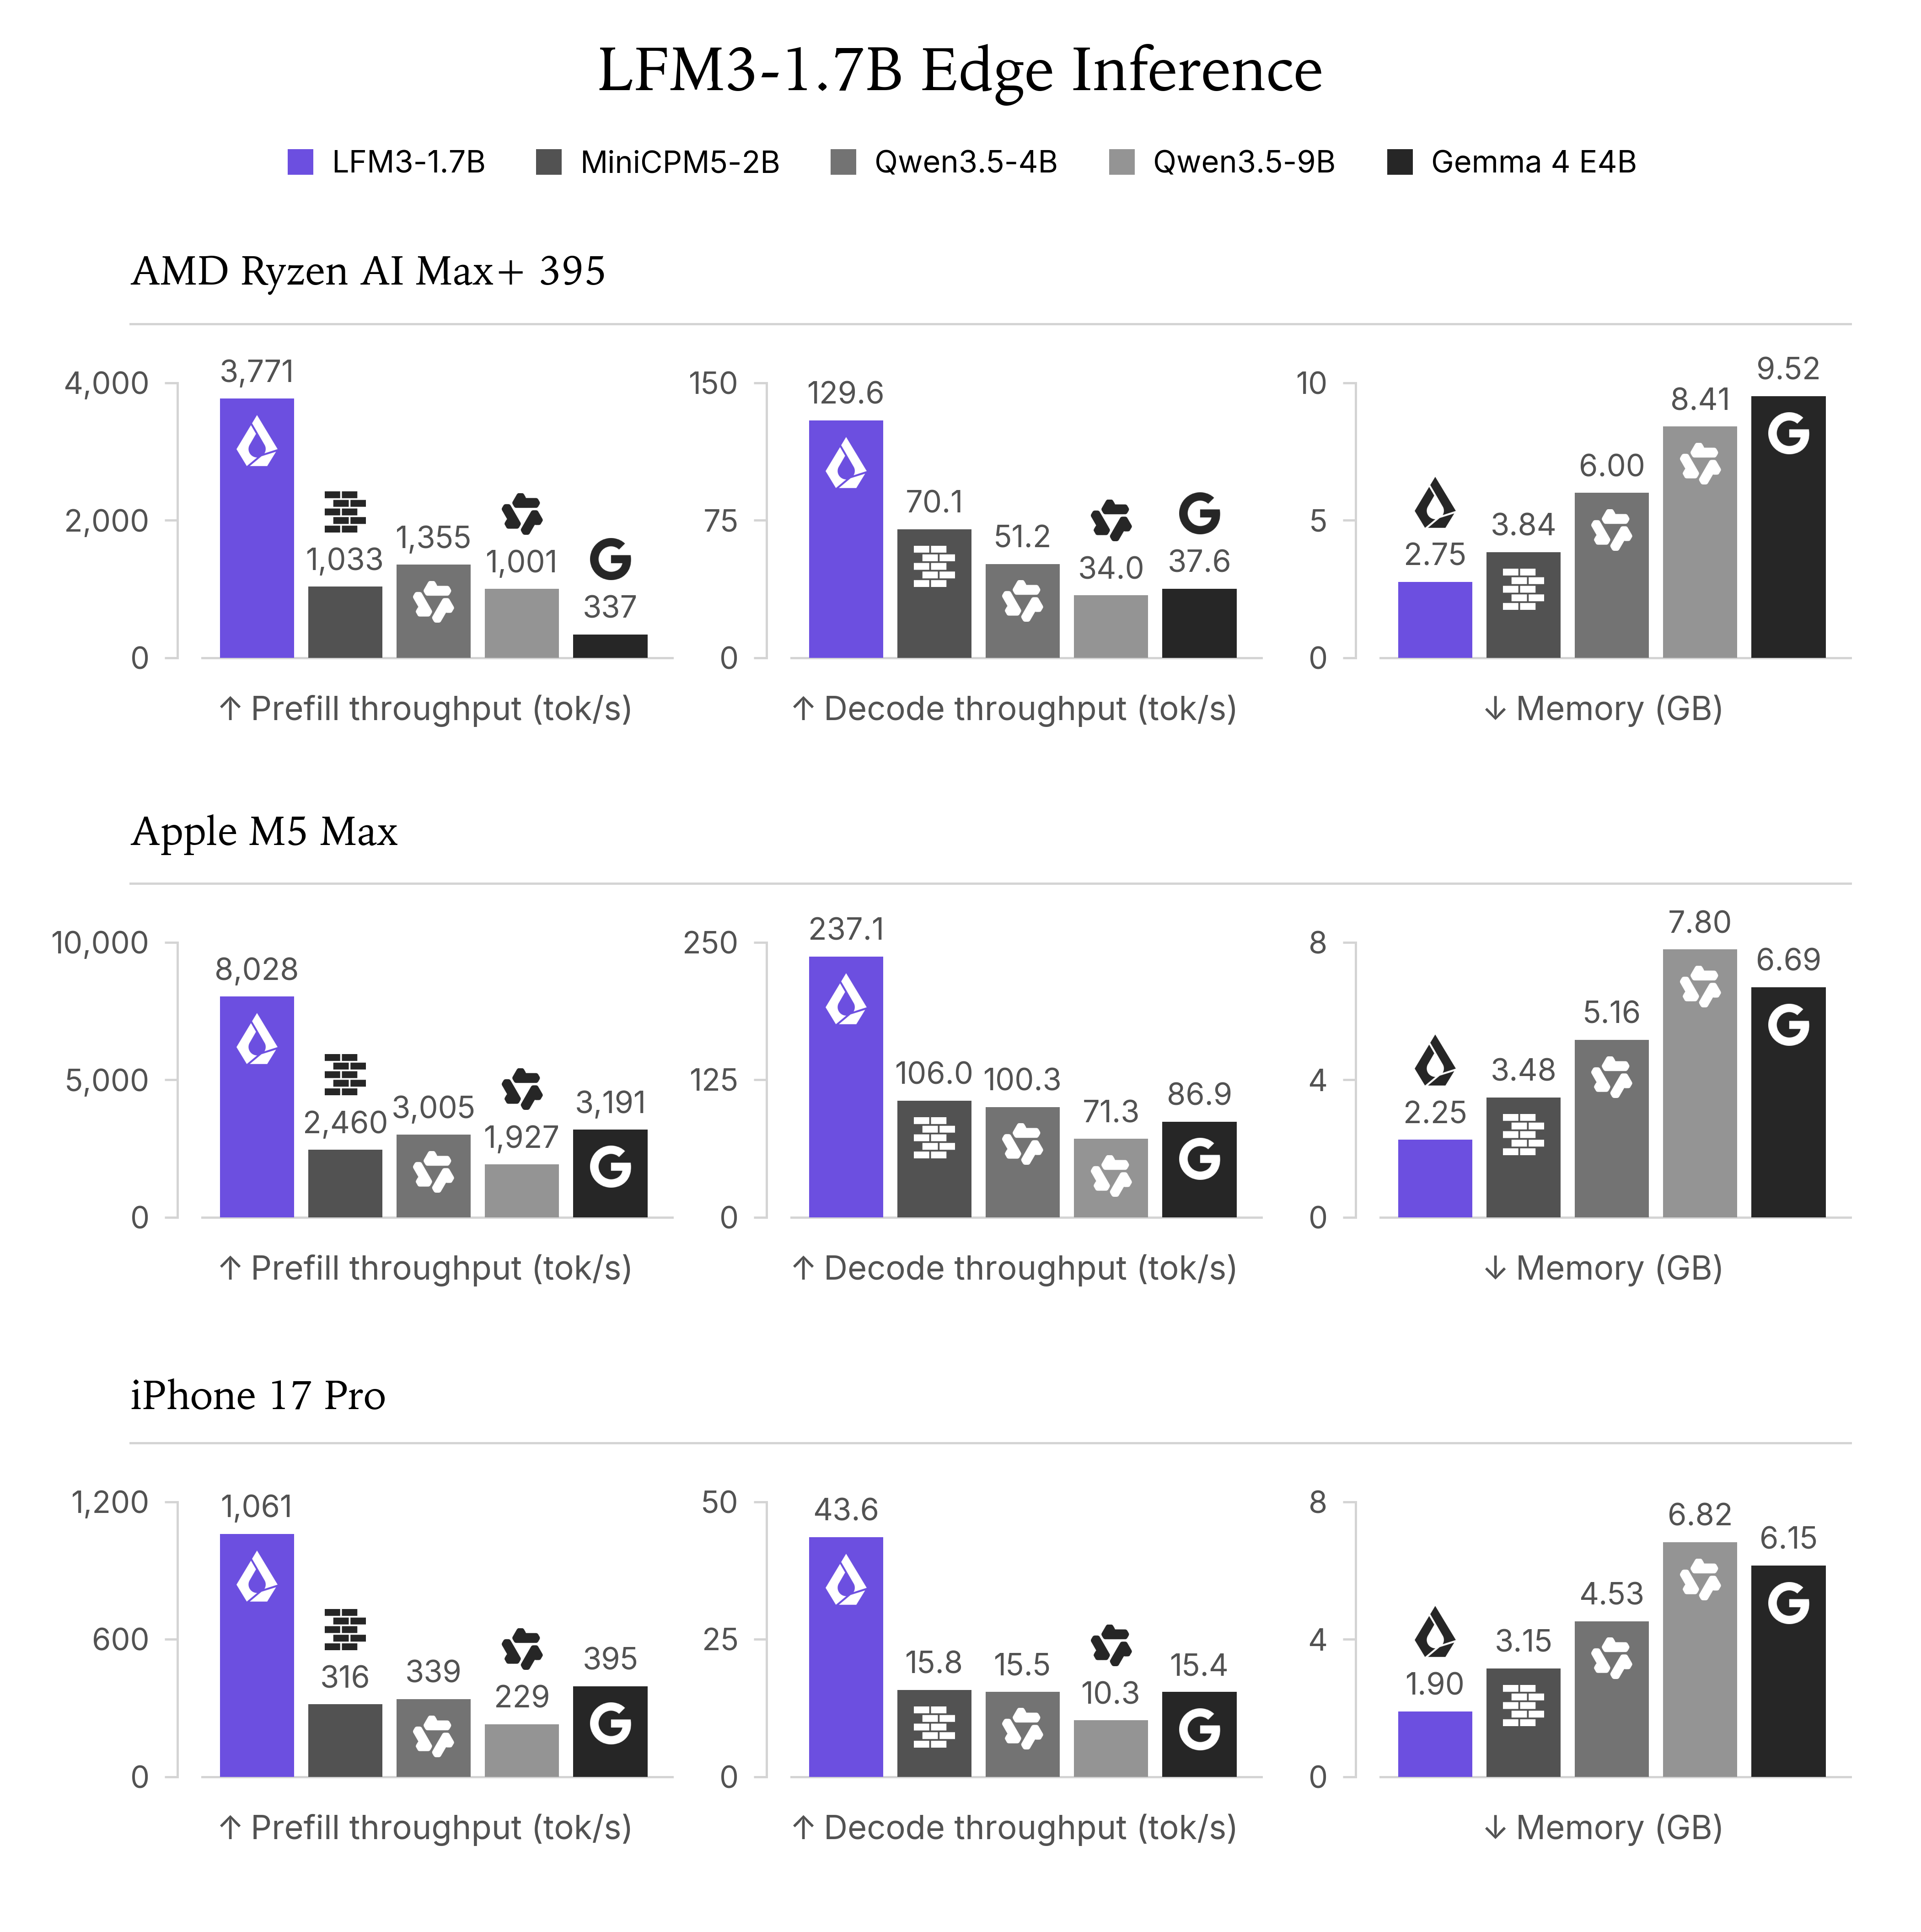
Environ 1 GB en quatre bits décrit un profil compact, pas toute conversation 256K. Runtime, contexte et descriptions d’outils consomment aussi. BF16, FP8, NVFP4, GGUF, MLX et ONNX ne sont pas interchangeables.
Choisissez système et accélérateur, fixez quantification et version puis mesurez une charge réaliste. Une extraction courte ne prouve ni vitesse en long contexte, ni fiabilité générale, ni confidentialité de l’application environnante.
Mode d’emploi : schéma et peu d’outils
L’exemple Transformers utilise trust_remote_code. Examinez et fixez l’implémentation en environnement isolé. Le code ci-dessous génère un texte borné; il n’installe pas d’agent métier et n’accorde pas de droits.
Définissez clés, types et null pour absences puis validez hors modèle. L’exécuteur impose noms, arguments, permissions et erreurs explicites. Deux outils inoffensifs sont un meilleur début qu’un accès à tout le poste.
from transformers import pipeline
generator = pipeline("text-generation", model="LiquidAI/LFM3-1.7B", trust_remote_code=True)
messages = [{"role": "user", "content": "Extract supplier and total as JSON. Use null when missing. Text: Supplier North Pier; total 12.50 USD."}]
output = generator(messages, do_sample=True, temperature=0.1,
    top_k=50, repetition_penalty=1.1, max_new_tokens=256)
print(output[0]["generated_text"][-1]["content"])
Lire les limites du retour tiers
Le compte rendu local MindStudio du 28 octobre décrit JSON et arguments réussis, mais corrections de code et HTML ratés. Il relève aussi une hypothèse de fuseau horaire. Ce sont des exemples limités d’un fournisseur commercial, pas nos mesures ni un taux statistique.
Son essai d’environ 80 langues dépassait les 16 annoncées. Il ne démontre pas l’échec de toutes les langues couvertes. Testez vos langues, schémas et contrats, et précisez unités et fuseau.
Recette pour extraction et orientation
Conservez des cas inédits avec champs manquants, dates contradictoires, outils interdits et instructions dans les documents. null ou refus peut être correct. Séparez JSON valide et exactitude : un mauvais identifiant bien formaté reste faux.
Mesurez correction, mémoire et requêtes acceptées. Les retours d’outils ne sont pas des instructions fiables. Si le besoin devient du débogage complexe, passez à une voie plus forte plutôt que cacher les reprises.
| Critère | Preuve | En cas d’échec |
|---|---|---|
| Schéma | Clés et types exacts | Refuser la sortie |
| Sens | Valeurs fondées sur entrée | null ou revue |
| Outil | Nom, arguments et fuseau permis | Refuser l’action |
| Charge | Mémoire et corrections mesurées | Escalader hors périmètre |
Comparer le flux complet
Comparez petits modèles avec même quantification et tâches, grand modèle pour interprétation difficile et règles pour formats fixes. Un score agrégé ne décide pas une chaîne documentaire précise.
Pour le hors ligne, préparez poids et dépendances puis contrôlez réseau de l’interface, des logs et intégrations. Des poids locaux ne rendent pas tout le système privé par eux-mêmes.
| Voie | Usage | Compromis |
|---|---|---|
| LFM3-1.7B | Extraction et outils limités | Limites et licence spécifique |
| Grand modèle | Interprétation ou code difficile | Ressources et coût |
| Règles / parseurs | Formats déterministes | Variabilité des entrées |
Vérifier la licence avant usage commercial
LFM Open License v1.0 remplace ici toute supposition Apache-2.0. Elle contient un seuil de chiffre d’affaires annuel de 10 millions USD et des limites par entité. Lisez définitions et section 5 avec le responsable.
Disponibilité des poids ne signifie pas permission commerciale générale. Licence, précision et confidentialité sont distinctes. Le dessin explique un travail borné confié à un petit modèle, sans résultat mesuré.
Questions avant adoption
Toutes les langues sont-elles couvertes ?
La fiche en annonce 16. Le test tiers d’environ 80 sort de ce périmètre. Vérifiez langues, dates, chiffres et termes avec une revue native.
Puis-je utiliser Apache-2.0 pour le commercial ?
Non : LFM Open License v1.0 s’applique, avec conditions de revenus et d’entité à examiner.
1 GB comprend-il la conversation 256K ?
Ne le supposez pas. Poids, runtime et état de contexte diffèrent. Mesurez le paquet sur appareil et charge cibles.
Sources consultées
- Liquid AI — model card
- Liquid AI — LFM Open License v1.0
- MindStudio — local hands-on report, 2026-10-28
Explorer les outils associés
Ready to try LFM3-1.7B?
Visit the official website to get started
Quick Info
- Website
- huggingface.co
- Category
- Génération de Texte
- Added
- 11/6/2026
- Published
- 11/6/2026
- Updated
- 11/6/2026
Have an AI tool to share?
Submit it to AI Dreamhub
Get your product in front of people actively exploring AI tools.
Submit Your Tool