AnyGen
AnyGenは、レポート、文書、プレゼン、分析、計画を作成・改善するAIワークスペースです。
AnyGenAI workspaceAI assistant
2240
0
Views
0
Likes
Nov 2026
Added
huggingface.co
Website
A quick visual look at Xiaomi-OCR-0 before you visit the official site.
Editorial Review
資料確認日:2026年11月6日。発表元の主張と第三者の体験を区別し、AIDreamHubの実測とはしていません。
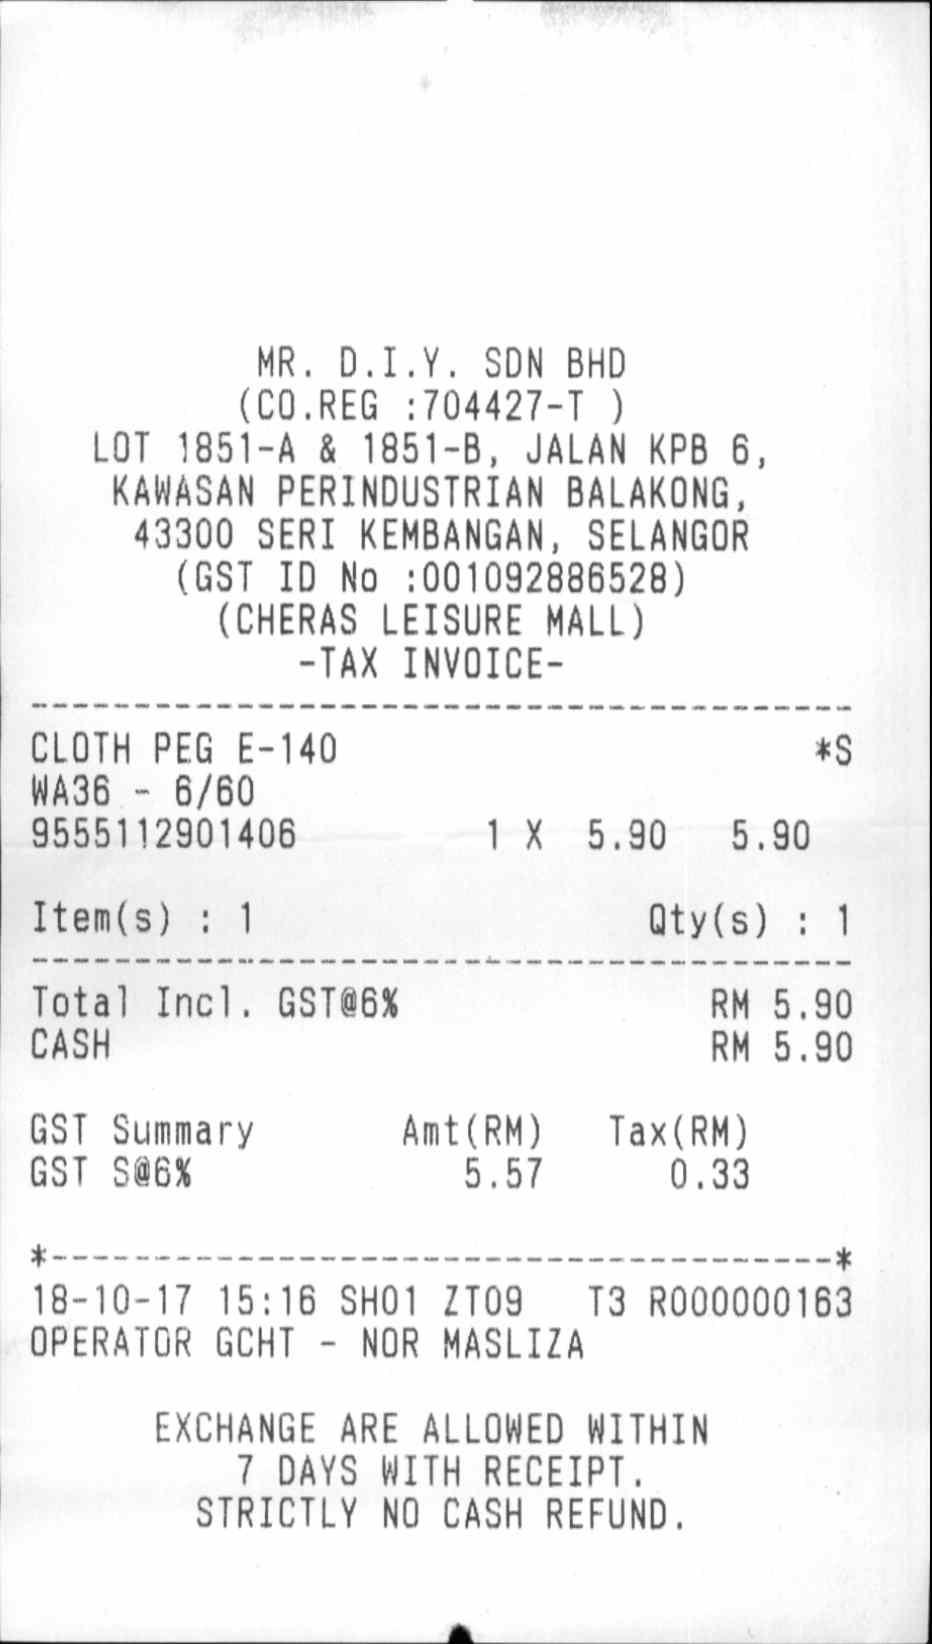
Xiaomi-OCR-0はQwen3.5-0.8B-Baseを基に、文書解析、OCR中心の質問応答、重要情報の抽出へ特化したモデルです。固定した仕入先の領収書から日付、通貨、税額、合計を取り出すなど、対象を絞った業務の部品として評価できます。
出力がそのまま検証済みの会計データになるわけではありません。画像前処理、PDFのページ処理、スキーマ、ルール検証、例外確認と出力が別途必要です。価値は見栄えのするCSVではなく、特定帳票の修正作業を減らせるかにあります。
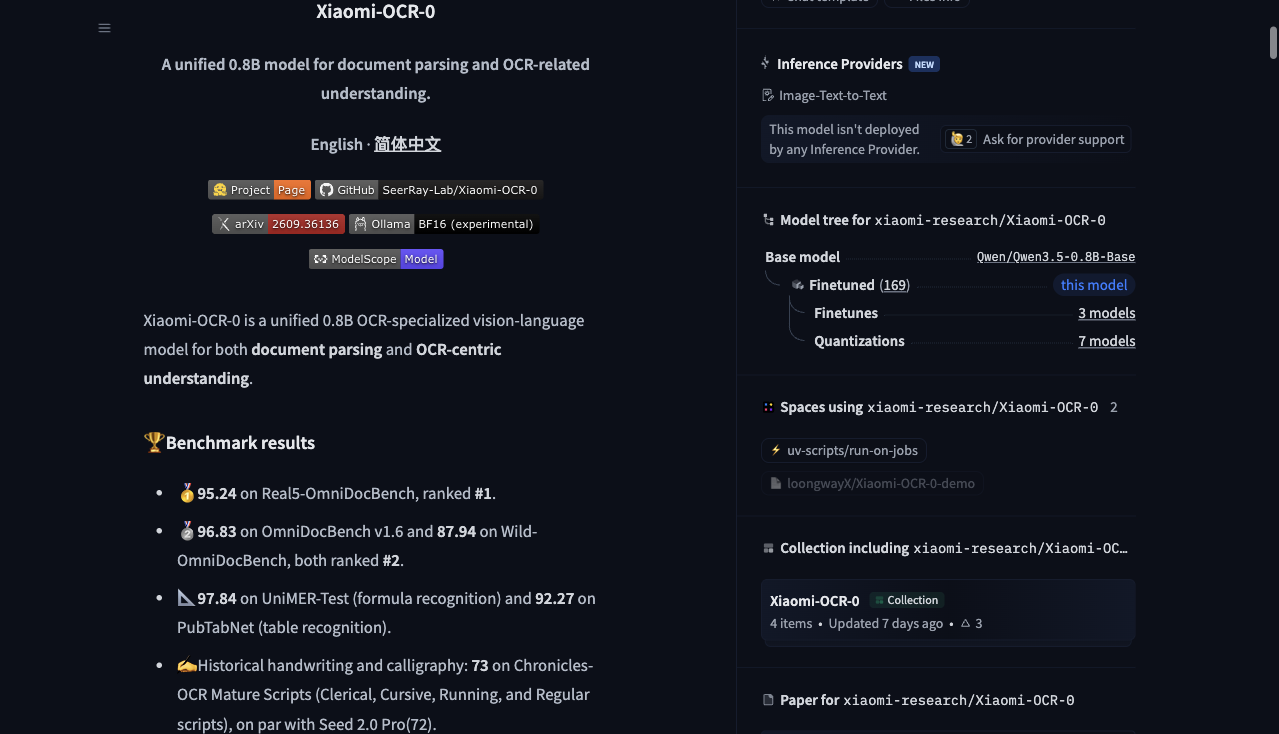
AIDreamHubが撮影した公式ページ。製品をローカル実行した画面ではありません。
公開スコアはOmniDocBench v1.6が96.83、Real5が95.24、Wildが87.94です。発表元の文書解析指標で、請求書の項目正解率や全項目正解ページの割合ではありません。報告書のReal5ではPP-DocLayoutV3を使うため、全ページを一度に処理するだけの構成へそのまま適用できません。
同表のPaddleOCR-VL-1.6は96.33、93.19、87.36です。近い値から個別業務の優位性は断定できません。本稿は一次資料の調査で、独立ベンチマークではありません。検索結果は発表紹介が中心で、広い第三者再現の合意までは確認できませんでした。
| 発表元の比較 | OmniDocBench v1.6 | Real5 | Wild |
|---|---|---|---|
| Xiaomi-OCR-0 · 0.8B | 96.83 | 95.24 | 87.94 |
| PaddleOCR-VL-1.6 · 0.9B | 96.33 | 93.19 | 87.36 |
公式コードはPython 3.10以降のブラウザデモ、MCP、別の推論バックエンドを用意しています。対応GPU環境ではSGLangやvLLM、実験的なローカル経路ではコミュニティBF16パッケージのOllamaを使えます。下のコマンドは公式のOllama+デモ経路で、本稿の実行実績ではありません。
Ollamaを動かし、隔離したPython環境で依存関係を確認してからhttp://127.0.0.1:8787を開きます。モデルをpullしただけでは前処理とデコード条件は揃いません。領域モードにはPaddlePaddle、PaddleX、PP-DocLayoutV3が追加で必要ですが、全ページOCR・KIE・VQAには不要です。
ollama pull longwayxu/xiaomi-ocr-0:bf16
git clone https://github.com/xiaomi-research/Xiaomi-OCR-0.git
cd Xiaomi-OCR-0
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
export XIAOMI_OCR_BACKEND=ollama
export XIAOMI_OCR_MODEL=longwayxu/xiaomi-ocr-0:bf16
export XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:11434/v1
python demo/server.py --port 8787匿名化した実例で始め、supplier、document_number、invoice_date、currency、subtotal、tax、totalを先に定義します。読めない値はnullを許し、推測を禁止します。原画像、生の回答、正規化行を関連付け、誰が何を直したか追えるようにします。
仕入先や帳票型で開発用と未使用テストを分け、ぼけ、傾き、通貨欠落、返金、多ページを含めてください。項目単位と行全体の正解を別々に数えます。九項目が正しくても合計が違えば、業務上は不合格です。
返されたJSONを構造検証し、番号は文字列として先頭のゼロを保持します。日付と通貨は曖昧でない場合だけ標準化します。金額照合には割引、手数料、端数処理も考慮し、不一致をモデルで勝手に修正せず人へ回します。
CSVの外部文字列は表計算ソフトの数式として解釈されないよう処理します。生データと安全な出力は別に保存してください。本番判断では速度だけでなく、合格行ごとの修正時間と人への振り分け率を測ります。
| 対象 | 検証 | 失敗時 |
|---|---|---|
| 伝票番号 | 文字列・先頭ゼロ | 原画像と照合 |
| 日付・通貨 | 書式と意味が明確 | 空欄か人へ |
| 金額 | 桁と整合性 | 差異を記録し捏造しない |
| CSV文字列 | 数式起動の抑制 | 生データと別保存 |
複雑なレイアウトならPaddleOCR-VL、固定帳票なら従来OCR+ルール、珍しい文書の解釈が重要なら強いVLMも候補です。これは仕事別の選択肢で、実測順位ではありません。
同じ未使用画像、項目定義、合格条件で比較します。0.8Bという数字だけで全体のRAMやページ時間は決まりません。実際の機器でメモリ、維持費、修正負担まで成立して初めて小型化が役立ちます。
| 経路 | 比較する理由 | 合格の問い |
|---|---|---|
| Xiaomi-OCR-0 | 小型の解析と抽出 | 検証後の行は正しいか |
| PaddleOCR-VL | 文書レイアウト処理 | 見落としが減るか |
| OCR+固定ルール | 安定した帳票 | 様式変更で壊れないか |
モデルはApache-2.0表記ですが追加部品には別条件があります。オフライン前にファイルを揃え、画像・ログ・一時PDFの保存先を確認します。ローカルモデルと遠隔ホストのデモは同じプライバシー条件ではありません。
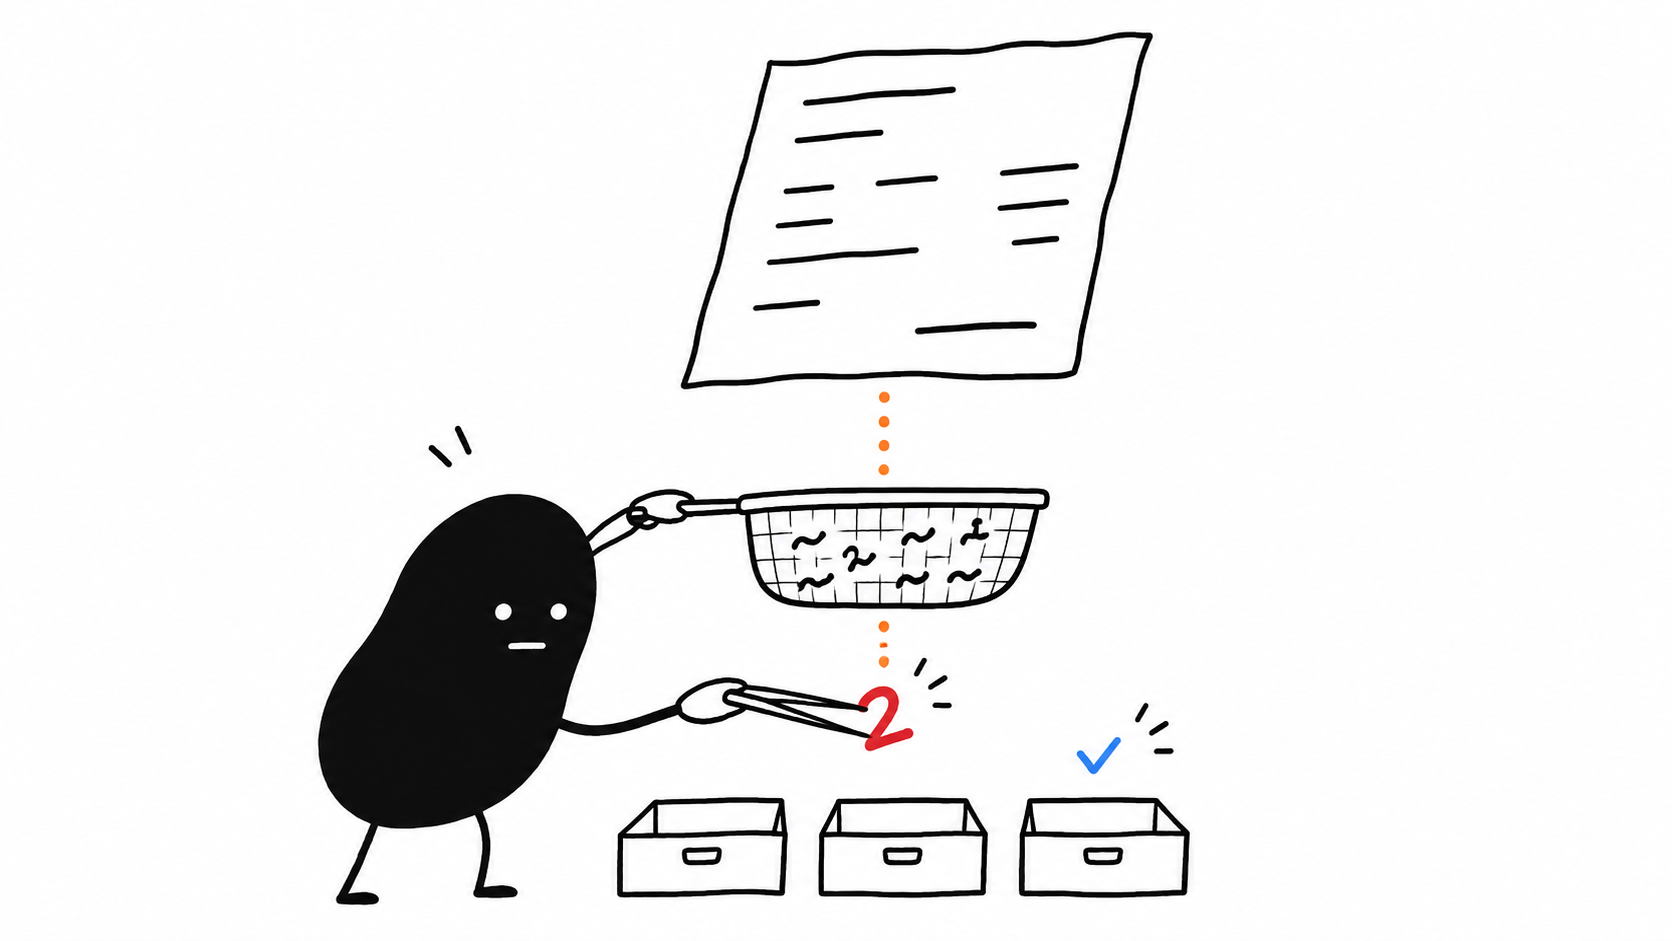
Ollamaは実験的で、公式の整合性確認は七例に限られます。一般精度や基準スコアの一致を証明しません。調査時にはモデルカードの一つのGGUFリンクが利用できなかったため推奨していません。現行の公式手順と正確なモデル・投影器・実行環境の版を記録します。手描き図は検証の比喩で、生成したOCR結果ではありません。
抽出の後に構造、日付、通貨、金額、数式対策と例外確認が必要です。原画像と生の回答を保存し、行全体の合格を判断してください。JSONとして正しいことは、内容が正しいこととは違います。
使えません。元の重みの評価と少数の整合性試験は、各変換版の一般的な同等性を示しません。前処理、投影器、実行環境、デコード条件を揃え、実際のパッケージで未使用文書を評価します。
パラメータ数は動作保証ではありません。バックエンド、画像処理、文脈長、追加レイアウトモデルの条件を確認し、必要ファイルを事前取得してください。公式は対応GPUサービスと実験的Ollama経路を区別しています。
Visit the official website to get started
Have an AI tool to share?
Get your product in front of people actively exploring AI tools.
Submit Your ToolAnyGenは、レポート、文書、プレゼン、分析、計画を作成・改善するAIワークスペースです。
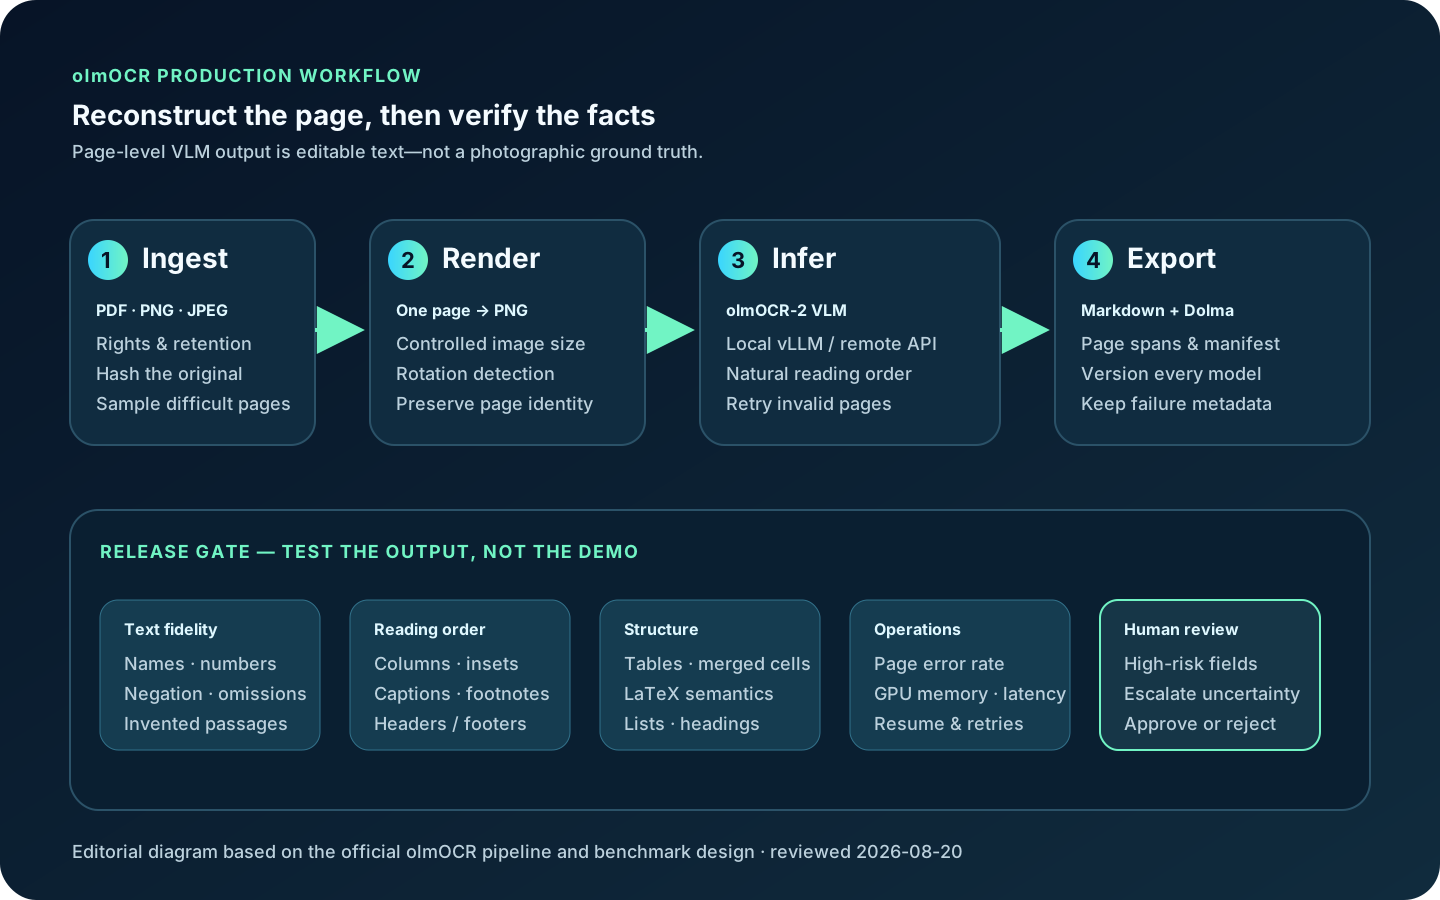
olmOCR は AI2 が公開する GPU 文書再構成ツールで、PDF・PNG・JPEG を自然な読み順の Markdown/テキストに変換し、表や数式にも対応します。
Gamma は、編集可能なプレゼンテーション、ドキュメント、Web ページ、ソーシャル投稿、グラフィックを作成するための AI 支援ワークスペースです。この独立したガイドでは、作成モード、現在の計画の境界、インポートとエクスポート、ブランドとアクセシビリティの QA、事実確認、サイトの公開、プライバシーと代替案について説明します。
Read AI Digital Twin - work digital twin. 公式情報と信頼できる公開資料をもとに、用途、強み、制限、比較候補を整理します。導入前には価格、権限、データ保護、提供地域、実際の品質を確認してください。