Whisper は、OpenAI が公開したエンコーダー・デコーダー型の音声モデル群であり、MIT ライセンスの Python 参照実装の名称でもあります。発話言語の文字起こし、言語識別、対応する多言語モデルによる英語への音声翻訳を行えます。ただし GitHub リポジトリは完成したクラウドサービスではなく、導入、計算資源、ファイル管理、セキュリティ、キュー、監視、校正は運用者の責任です。
混同しやすい三つの対象を区別してください。openai-whisper はダウンロード可能なチェックポイントを実行する Python パッケージ、whisper-1 は OpenAI Audio API 上の別のホステッドモデル、faster-whisper、whisper.cpp、WhisperX や各種 Web UI は Whisper 系の重みを利用する第三者実装またはパイプラインです。速度・費用・プライバシーを比較するときは、どの層の話かを明示する必要があります。
一文で判断する
透明性の高い上流ベースライン、ローカル制御、広いエコシステム互換性が必要で、計算資源と品質管理を自分で持てるなら Whisper が有力です。運用負担を減らすことが重要ならマネージド API、CPU・エッジ推論、スループット、単語アラインメント、話者分離が主目的なら特化ランタイムも比較すべきです。
Whisper の持続的な強みは、あらゆるベンチマークで常に首位になることではなく、同じモデル家族を研究ノート、オフライン端末、GPU バッチ、エッジ環境へ展開できる選択肢の広さです。そのため共通の評価基準には向きますが、あるラッパーと特定ハードウェアの速度を上流 Whisper の保証として扱うことはできません。
提供範囲と不足するもの
| 層 | 含まれるもの | 別途必要なもの |
|---|---|---|
| チェックポイント | 英語専用・多言語の複数サイズ | 保存領域、推論ランタイム、ハードウェア |
| Python パッケージ | CLI、Python API、デコード、TXT/SRT/VTT/JSON 等の出力 | FFmpeg、ジョブ管理、再試行、監視 |
| 文字起こし | 原言語テキスト、セグメント時刻、任意の単語時刻 | 人手修正、話者分離、分野別検証 |
| 音声翻訳 | 対応モデルで英語へ翻訳 | 英語以外への翻訳。turbo は翻訳非対応 |
| MIT ライセンス | 条件に従った利用・改変・再配布 | 録音の権利、同意、通知、業務上の遵守 |
Whisper 自体は話者分離、会議編集、同意管理、監査ログ、保持ポリシーを提供しません。また、上流パッケージだけで本番用のリアルタイム配信が完成するわけでもありません。第三者が組み合わせた機能を上流の標準機能と誤記しないことが重要です。
モデルと導入先の選び方
| モデル | パラメータ | 概算 VRAM | 相対速度* | 出発点 |
|---|---|---|---|---|
| tiny / tiny.en | 39M | 約1 GB | 約10倍 | 試作・制約のある端末 |
| base / base.en | 74M | 約1 GB | 約7倍 | 高速なローカル下書き |
| small / small.en | 244M | 約2 GB | 約4倍 | バランス型の基準 |
| medium / medium.en | 769M | 約5 GB | 約2倍 | 精度優先 |
| large | 1.55B | 約10 GB | 1倍 | 多言語品質 |
| turbo | 809M | 約6 GB | 約8倍 | 高速な転写(翻訳には不向き) |
*OpenAI README の A100 上での英語文字起こし(large 比)です。2026-08-20 に確認。言語、音声、ハードウェア、実装で変わるため、一般的な待ち時間の保証ではありません。
tiny、base、small、medium には多言語版と .en 英語専用版があります。英語専用版の差は tiny と base で大きく、small と medium では小さくなると OpenAI は説明しています。GPU で一般的な文字起こしなら turbo、資源を抑える基準なら small、英語のみなら同サイズの .en を候補にしてください。英語への音声翻訳は medium または large を使い、turbo は選ばないでください。
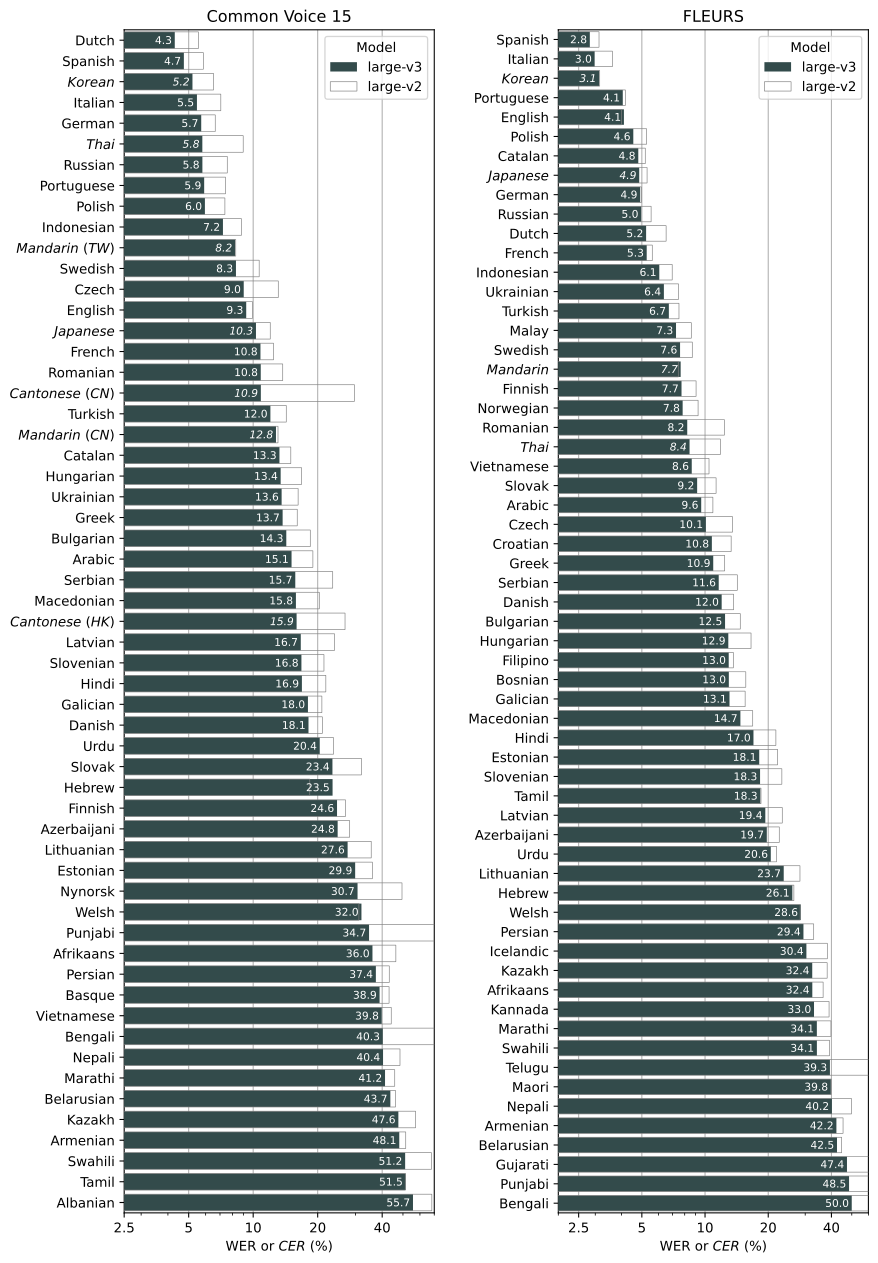
「98 言語対応」はカバレッジであり、98 言語が同じ精度という意味ではありません。公式モデルカードは、学習データ量、言語、アクセント、方言によって差があると明記しています。言語が既知の単言語ジョブでは指定する価値があります。コードスイッチを含む音声では、一つの自動検出ラベルに依存せず専用の評価例を用意してください。
ローカル導入と再現可能な初回実行
上流の導入は、openai-whisper と OS 側の FFmpeg を用意し、モデルを選んで CLI または Python API を実行する流れです。現行メタデータは Python 3.8 以上を要求し 3.13 まで分類していますが、README の互換説明はより保守的です。本番ではパッケージのコミットとモデル名を固定し、main の追随を無記録で行わないでください。
python -m venv .venv
source .venv/bin/activate
pip install -U openai-whisper
whisper interview.wav --model turbo --output_format all \
  --output_dir transcripts
CLI は TXT、VTT、SRT、TSV、JSON を出力できます。transcribe() は 30 秒のスライディング窓で処理し、全文、セグメント、検出言語を返します。初回はモデル取得時間を含むため、コールドスタートとウォーム推論を分けて計測します。CPU でも動作しますが、大きなモデルは遅く、VRAM 表は計画値にすぎません。
バッチ文字起こしと字幕の実務フロー
- 成果物を定義する。検索用メモ、字幕下書き、公開原稿、高リスク判断用の記録では校正基準が異なります。
- 非公開テストセットを作る。雑音、無音、音楽、アクセント、固有名詞、数値、コードスイッチ、最長ファイルを含め、人手の正解文を用意します。
- 音声処理を分離する。原本を保持し、デコードを統一します。VAD やノイズ除去は語頭欠落と幻覚への影響を測ってから採用します。
- 条件を固定して比較する。ハードウェア、言語指定、デコード設定を固定し、2〜3 サイズのモデルと実時間係数を記録します。
- 失敗の種類を見る。名称、数字、否定、無音上のテキスト、反復、言語切替、時刻ずれを平均 WER と別に採点します。
- 納品形式を整える。SRT/VTT または JSON を出し、行長、読み速度、句読点、話者ラベルは後処理で管理します。
- 重要用途は人が聞き直す。医療・法律・雇用・研究引用・アクセシビリティ公開では原音確認が必要です。
音声 + 同意
   ↓
統一デコード / 任意 VAD ── 原本保持
   ↓
モデル + 言語 + 記録済み設定
   ↓
無音・反復・固有名詞・数値・時刻ずれ検査
   ↓
人手確認 ── 書き出し ── 保持/削除
精度、幻覚、評価の読み方
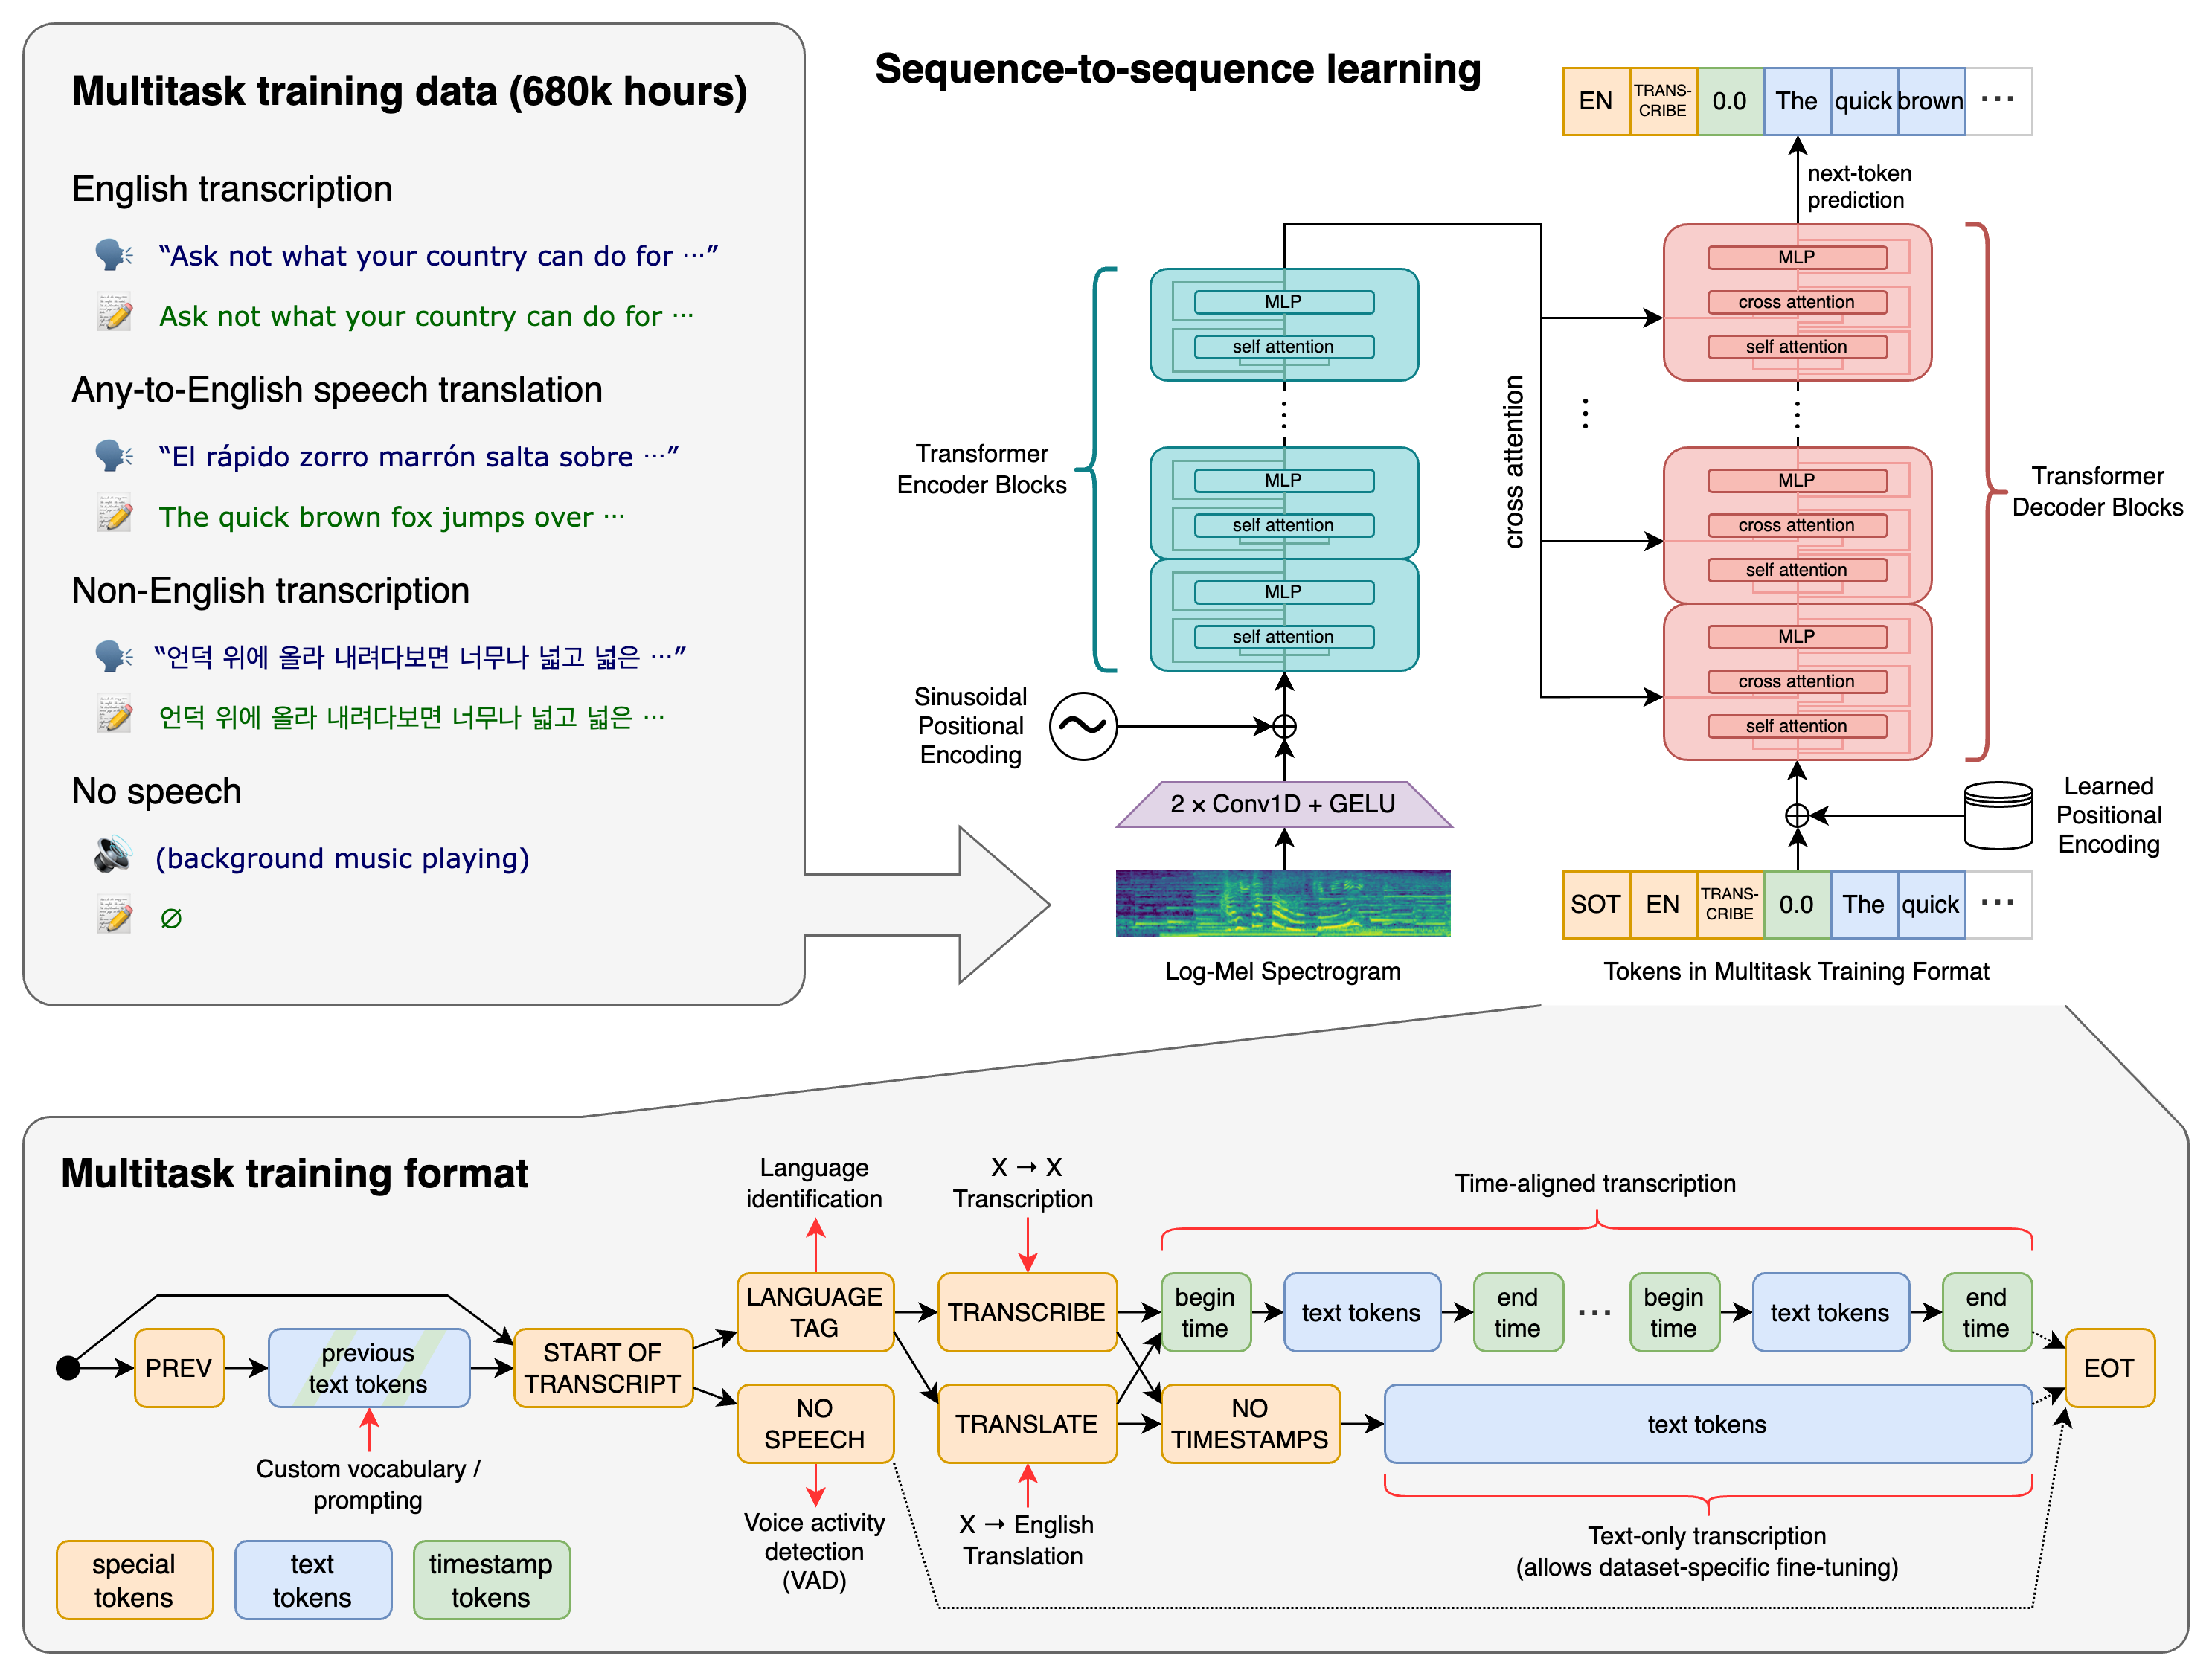
Whisper 論文は 68 万時間の弱教師あり多言語・多タスク音声で高いゼロショット堅牢性を示しました。一方、公式モデルカードは、実際に話されていない文の生成、反復、言語・アクセント・方言間の偏りを明記しています。無音、音楽、雑音、不明瞭な発話では、音響証拠より言語として自然な続きを出す危険を特に確認すべきです。
| 指標 | 使い方 | 見逃すもの |
|---|---|---|
| WER/CER | 人手正解と比較。日本語は CER も利用 | 一つの名称・否定・数値の重大性 |
| 固有表現/数値 | 人名、商品、日付、量、単位を個別採点 | 全体の流暢さ |
| 幻覚区間率 | 非音声区間で出たテキストを標識 | 実発話内の通常誤り |
| 時刻ずれ | 長尺の先頭・中間・末尾で境界確認 | 文字の正しさ |
| 実時間係数 | 処理秒数÷音声秒数 | 取得、待ち、人手修正 |
| 1時間当たり校正時間 | 音声1時間の人手修正分数 | インフラ費用 |
本ページは単一の「Whisper WER」を掲載しません。モデル、言語、データ、前処理、デコード条件がなければ比較不能だからです。公開値は公式図と論文付録を参照し、導入判断はバージョン管理された社内テストで行ってください。
prompt は専門語の綴りを誘導できますが保証ではなく、prompt 自体が反復される可能性もあります。温度フォールバック、前文条件、閾値、単語時刻、無音幻覚オプションを変えるときも、固定評価セットでエラーの交換を測る必要があります。
プライバシー、安全性、運用境界
| 境界 | 実務上の対策 |
|---|---|
| ローカル処理 | 重みの取得先と外向き通信を管理し、原音・結果を暗号化し削除を定義する |
| 同意 | 録音と文字起こしの許可を確認する。モデルカードも無同意の個人録音を警告 |
| 高リスク用途 | 未確認原稿だけで医療、法律、雇用等を決めない |
| 話者分離 | 別モデルとして評価する。Whisper は誰が話したかを証明しない |
| リアルタイム | 上流は即時ストリーミング製品ではなく、ラッパー固有の遅延がある |
| 保守 | 依存・モデルを固定し、更新前に回帰コーパスを実行 |
| ライセンス | MIT 通知に加え、録音・原稿・第三者部品の権利を確認 |
Whisper と代替実装の比較
| 選択肢 | 選ぶ理由 | 主なトレードオフ |
|---|---|---|
| openai-whisper | 上流 Python 基準、ローカル制御 | 性能調整、バッチ、運用を自分で持つ |
| faster-whisper | CTranslate2 の GPU/CPU スループット、量子化、バッチ | 別実装なので上流との回帰比較が必要 |
| whisper.cpp | C/C++、CPU、Apple Silicon、モバイル/エッジ、オフライン | ビルドとモデル変換の管理が増える |
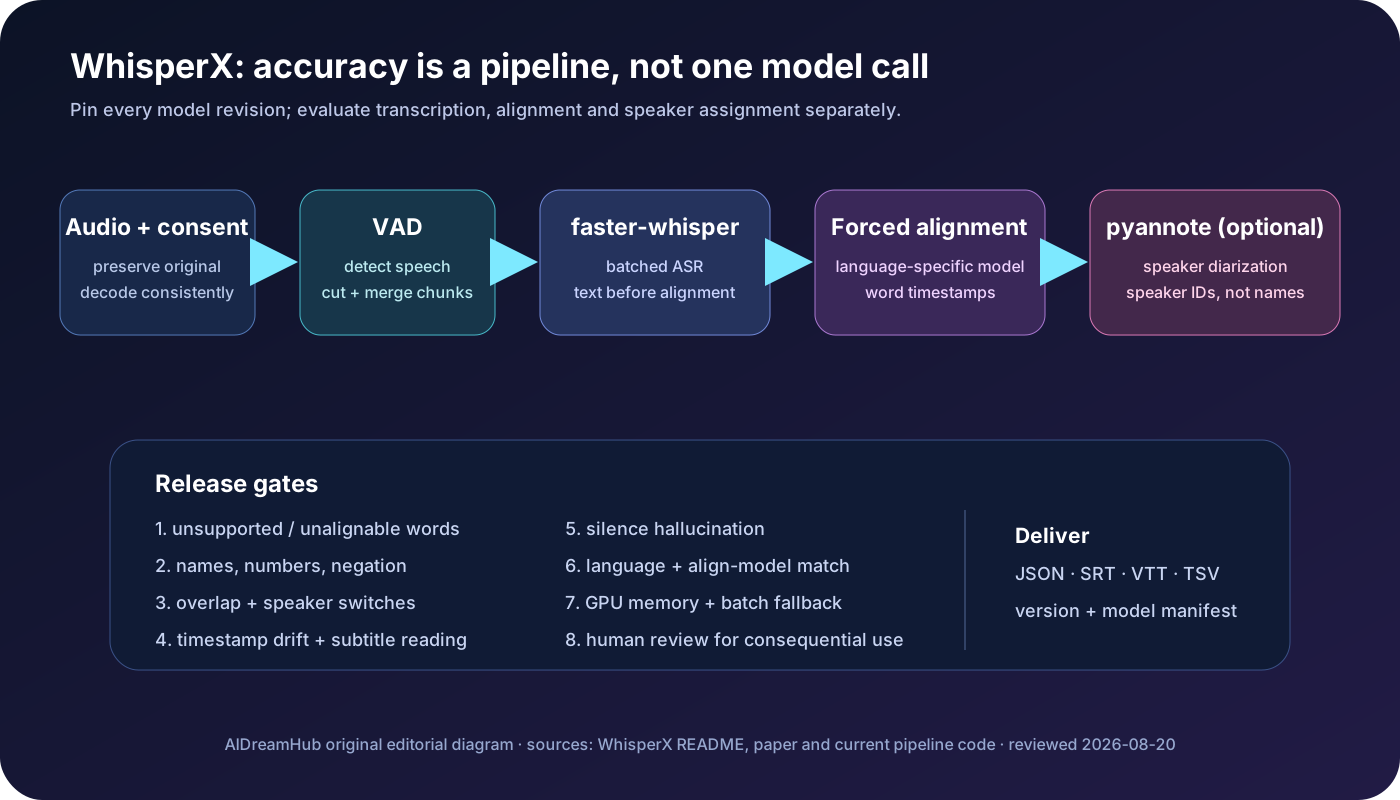
| WhisperX | 長尺バッチ、単語アラインメント、任意の話者分離 | 追加モデル、依存、ライセンスを管理 |
| OpenAI 音声 API | マネージド推論と現行モデル | 音声の外部送信、従量課金、API 制限 |
OpenAI の現行ガイドは通常の録音転写に gpt-transcribe を推奨し、単語/区間時刻、字幕形式、英語への音声翻訳では whisper-1 を案内しています。2026-08-20 時点の公式見積りは gpt-transcribe が $0.0045/分、gpt-4o-transcribe が $0.006/分、mini が $0.003/分でした。価格と提供モデルは変わるため予算前に再確認してください。アップロード上限は 25 MB と記載されています。
よくある質問
Whisper は無料ですか?
上流コードと公開モデルは MIT ライセンスで、ローカル実行に分単位の利用料はありません。ただし計算資源、保存、開発、校正費は発生します。ホステッド API は別料金です。
完全にオフラインで動きますか?
依存関係とモデルを事前に保存すれば、音声を API に送らず推論できます。隔離環境を名乗るならアプリ全体の通信、ログ、保存も検証してください。
どのモデルから始めるべきですか?
GPU の高速転写は turbo、バランスは small、英語のみは .en を比較します。自社音声で最低2サイズを試し、英語への音声翻訳には turbo を使いません。
話者を識別できますか?
Whisper 単体には話者分離がありません。WhisperX 等は別のモデルを組み合わせるため、精度、権利、依存を個別に評価します。
リアルタイム転写できますか?
上流パッケージは完成したストリーミングサービスではありません。第三者実装では可能ですが、VAD、バッファ、文脈、遅延はその実装の性質です。
なぜ存在しない文や反復が出ますか?
公式モデルカードが認める失敗モードです。無音や音楽を評価に含め、流暢さを正しさとみなさず重要箇所を聞き直してください。
確認した情報源
- OpenAI Whisper 公式リポジトリ
- 公式 README
- 公式モデルカード
- MIT ライセンス
- Whisper 論文
- OpenAI Audio API ガイド
- OpenAI API 価格
- faster-whisper
- whisper.cpp
- WhisperX
独立技術レビュー:2026-08-20。モデル、説明、API、価格は変わり得ます。導入前に一次情報と自社評価を確認してください。