Stable Audio
Stable Audio ist Stability AIs Plattform für generative Musik und Soundeffekte aus Textprompts. Die Stable-Audio-3.0-Familie unterstützt experimentelle Audio-Workflows und Open-Weight-Optionen für Forschung und lokale Kreativarbeit.

Stable Audio ist Stability AIs Plattform für generative Musik und Soundeffekte aus Textprompts. Die Stable-Audio-3.0-Familie unterstützt experimentelle Audio-Workflows und Open-Weight-Optionen für Forschung und lokale Kreativarbeit.
Open source library for audio/music generation by Meta, which mainly includes two models, MusicGen: text-to-music model, AudioGen: text-generated sound model. - Intelligentes KI-Tool für mehr Produktivität.
Bark is a transformer-based text-to-audio model created by Suno. Bark can generate highly realistic, multilingual speech as well as other audio - including music, background noise and simple sound effects. - Intelligentes KI-Tool für mehr Produktivität.

ElevenLabs Sound Effects ist ein Text-to-Sound-Effects-Generator für individuelle SFX, Ambience, Loops und Cinematic Audio. Er unterstützt Dauersteuerung, Prompt Influence, Loops, mehrere Varianten, Downloads und API-Workflows.
Mureka ist eine KI-Musikplattform, die Songs aus Prompts oder Texten erzeugt und Referenzaudio, Vocal IDs, Bereichsedits, Verlängerung, Remix, Stem-Trennung und Export verbindet.

Create music from simple text prompts by specifying topics, genres, and other descriptors which are then transformed into professional quality tracks. - Intelligentes KI-Tool für mehr Produktivität.

Create stunning original music for free in seconds using AI. Make your own masterpieces, share with friends, and discover music from artists worldwide. - Intelligentes KI-Tool für mehr Produktivität.

Split vocal and instrumental tracks quickly and accurately with LALAL.AI. Upload any audio file and receive high-quality extracted tracks in a few seconds. - Intelligentes KI-Tool für mehr Produktivität.

Separate voice from music out of a song free with powerful AI algorithms - Intelligentes KI-Tool für mehr Produktivität.

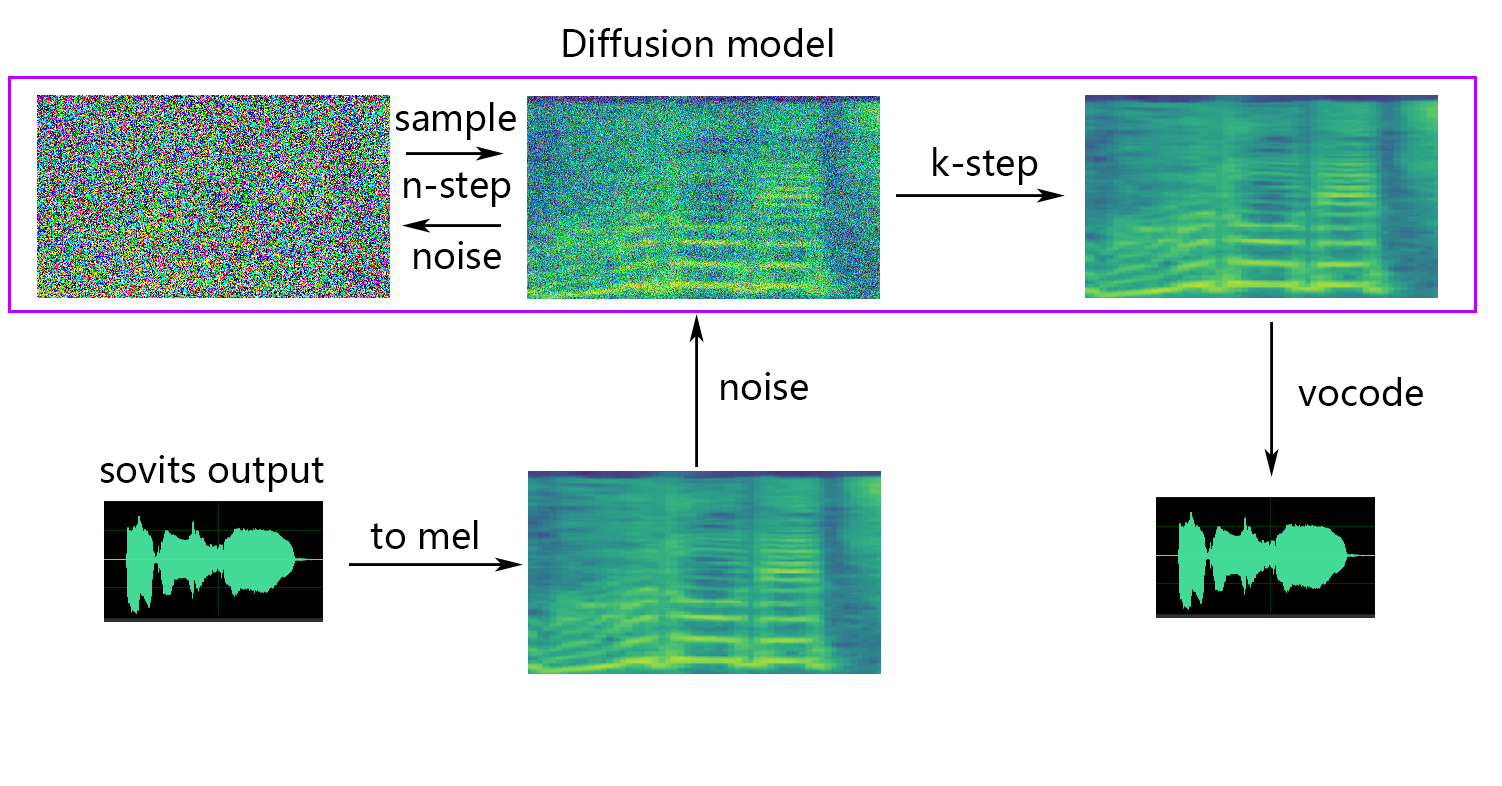
So-VITS-SVC 4.1 ist ein archiviertes Open-Source-Forschungsframework für die Konvertierung von Gesangsstimmen, nicht für die Umwandlung von Text in Sprache. Dieser unabhängige Leitfaden behandelt Einwilligung, Lizenzierung, saubere Datensätze, F0 und Encoder, Schulung, Schlussfolgerung, Bewertung, Offenlegung, Sicherheit und Alternativen.

Shazam ist Apples App zur Musikerkennung für Songs in der Umgebung oder in unterstützten Apps. Sie ist nützlich für schnelle Song-IDs, Lyrics, Videos, Konzertinformationen und den Übergang zu Apple Music.

ChatTTS is a text-to-speech model designed specifically for dialogue scenario such as LLM assistant. It supports both English and Chinese languages. - Intelligentes KI-Tool für mehr Produktivität.

Tetos ist ein Open-Source-Python- und CLI-Wrapper mit einheitlicher Schnittstelle für mehrere Text-to-Speech-Anbieter. Nützlich für Entwickler, die Edge TTS, OpenAI, Azure, Google, Volcengine, Baidu, Minimax, Xunfei, Fish Audio und andere Engines vergleichen oder wechseln wollen.

EmotiVoice ist eine kostenlose Open-Source-TTS-Engine von NetEase Youdao mit mehreren Stimmen und Prompt-Steuerung. Sie unterstützt Englisch und Chinesisch, über 2.000 Stimmen und emotionale Steuerung für Forschung, Prototypen und Voice-Anwendungen.

ElevenLabs ist eine AI-Voice-Plattform für Text-to-Speech, Voice Cloning, Dubbing, Speech-to-Text, Voice Agents und generative Audio-APIs.

A deep learning toolkit for Text-to-Speech, battle-tested in research and production - Intelligentes KI-Tool für mehr Produktivität.

Hailuo AI TTS ist ein mit MiniMax Audio verbundenes Tool für mehrsprachige Text-to-Speech-Erzeugung, KI-Stimmen und Voice Cloning.

The best and most realistic voice tools currently available - Intelligentes KI-Tool für mehr Produktivität.

IndexTTS ist Bilibili’s Open-Source-System für industrielle, steuerbare und effiziente Zero-Shot-Text-to-Speech-Synthese. Es richtet sich eher an Speech-Forscher und Entwickler als an Nutzer einer fertigen Web-App.

Whisper Web ist eine MIT-lizenzierte Browser-Spracherkennungsdemo mit Transformers.js für lokale Transkription, Zeitstempel und TXT/JSON-Export.
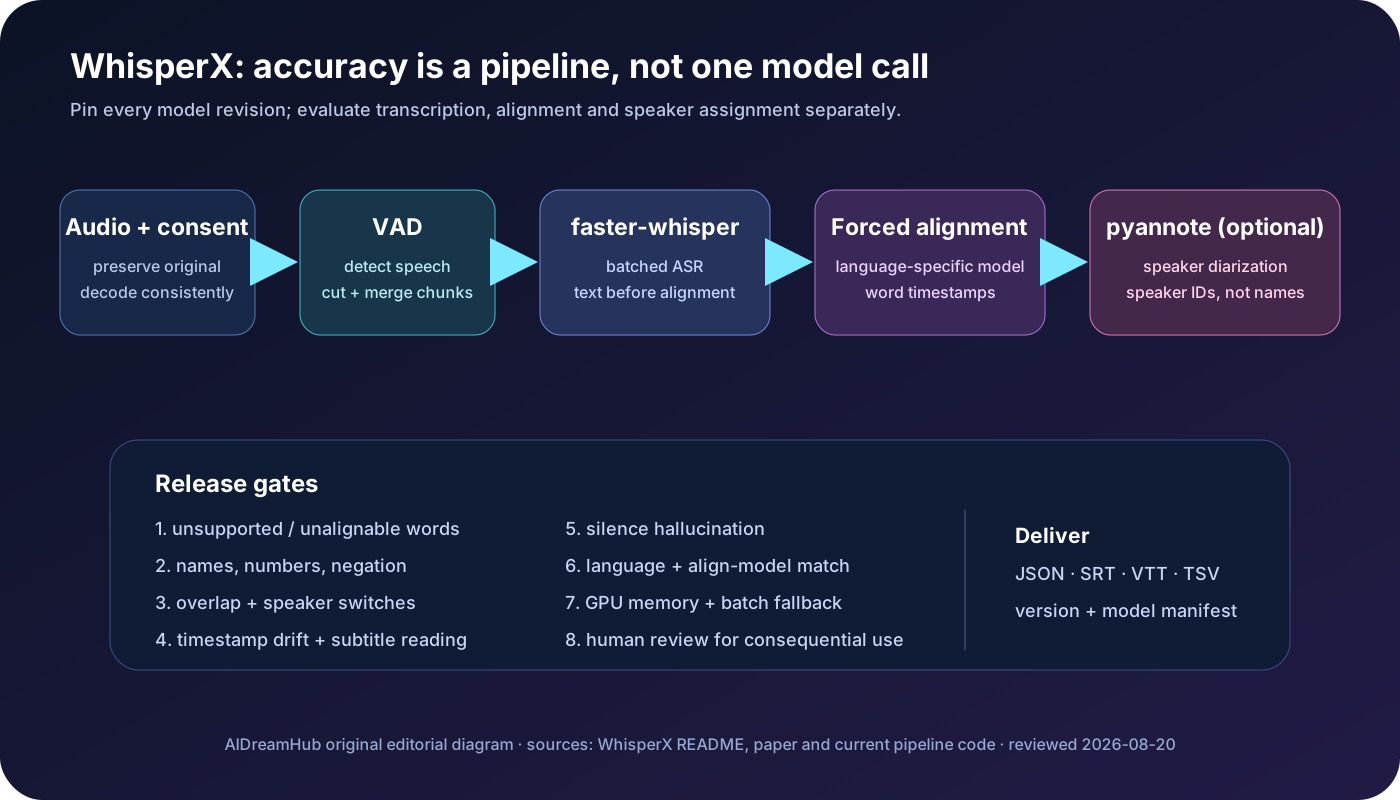
WhisperX ist eine Open-Source-Pipeline für lange Audiodateien, die faster-whisper-Batches um sprachspezifisches Wort-Alignment und optionale pyannote-Sprecherdiarisierung ergänzt.

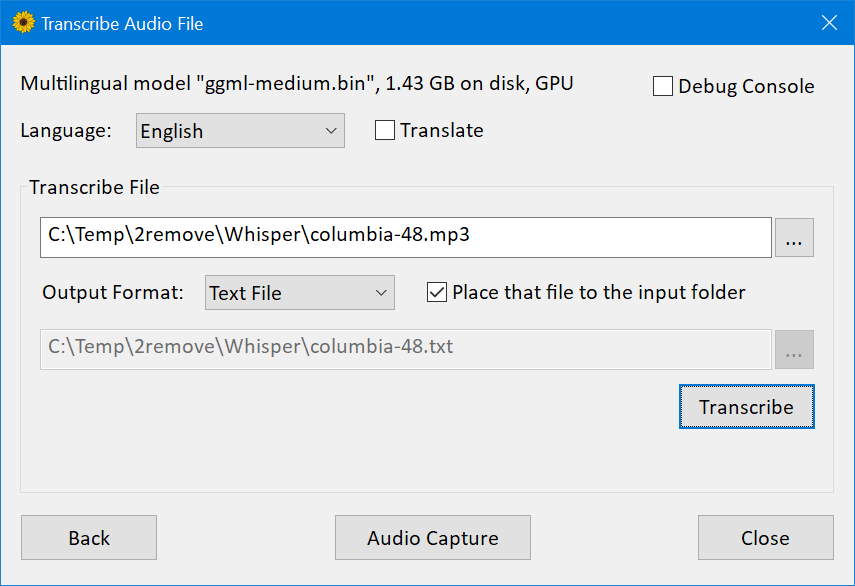
WhisperDesktop ist eine Windows-Desktop-App und DirectCompute-Implementierung zum lokalen Ausführen von OpenAI Whisper auf Audio-, Video- und Mikrofoneingaben. In diesem Handbuch werden Einrichtung, Modelle, GPUs, Untertitel, Datenschutz und Alternativen behandelt.

Buzz ist eine kostenlose, vom MIT lizenzierte Desktop-App für lokale Whisper-Transkription, Untertitel, Live-Untertitel, Übersetzung und Sprecherkennzeichnung auf macOS, Windows und Linux. In diesem Leitfaden werden Backends, Hardware, Datenschutz, Genauigkeitstests, Untertitel-Qualitätssicherung, CLI-Automatisierung und Cloud-Alternativen verglichen.

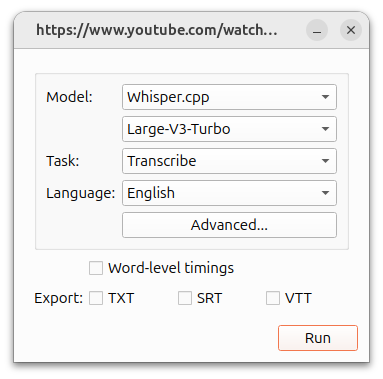
Whisper.cpp ist eine abhängigkeitsarme C/C++-Implementierung von OpenAI Whisper für lokale Transkription, Übersetzung, Streaming, Server und eingebettete Apps. Dieser Leitfaden behandelt Modelle, Quantisierung, Backends, Genauigkeit, Datenschutz und Bereitstellung.