AnyGen
AnyGen es un workspace de IA para informes, documentos, presentaciones, análisis, planes y entregables profesionales.
AnyGenAI workspaceAI assistant
1990
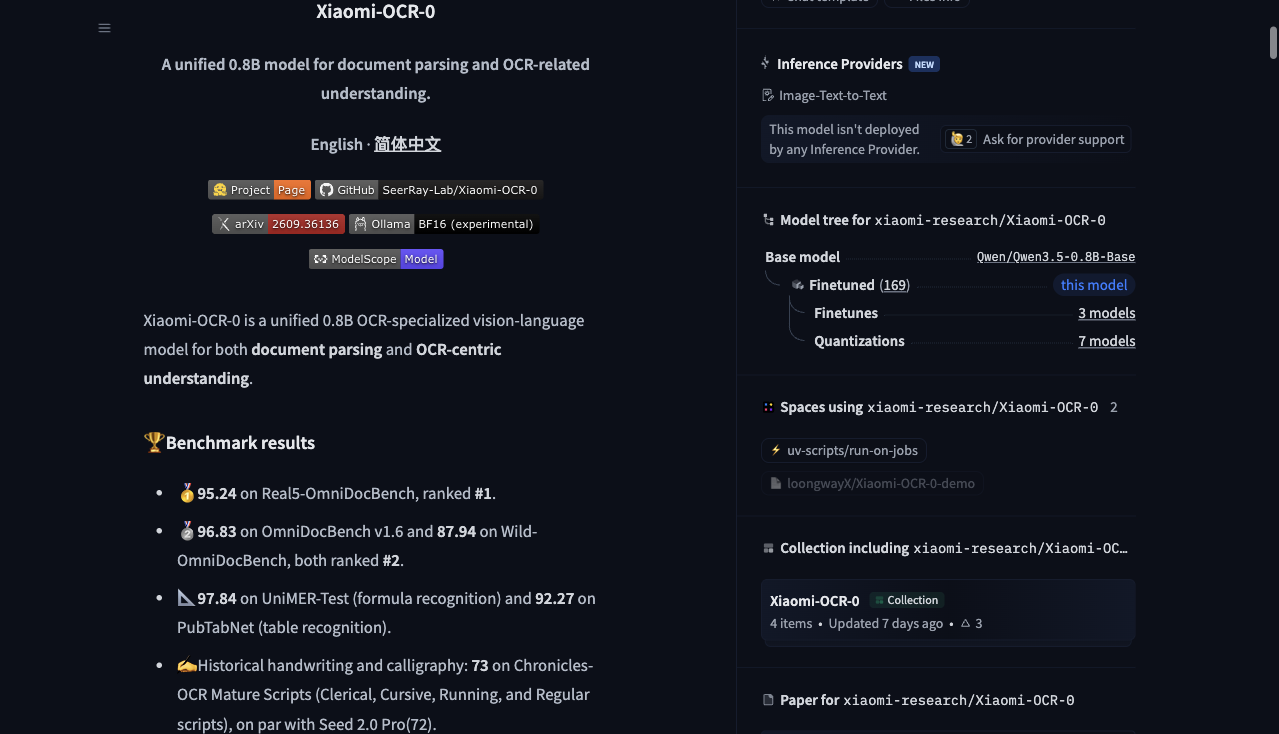
Xiaomi-OCR-0 es un modelo documental de 0,8B para páginas, tablas, fórmulas, preguntas y extracción de campos. La validación posterior determina su utilidad real.
0
Views
0
Likes
Nov 2026
Added
huggingface.co
Website
A quick visual look at Xiaomi-OCR-0 before you visit the official site.
Editorial Review
Fuentes comprobadas el 6 de noviembre de 2026. Se distinguen afirmaciones del editor y experiencias ajenas; no es un benchmark propio de AIDreamHub.
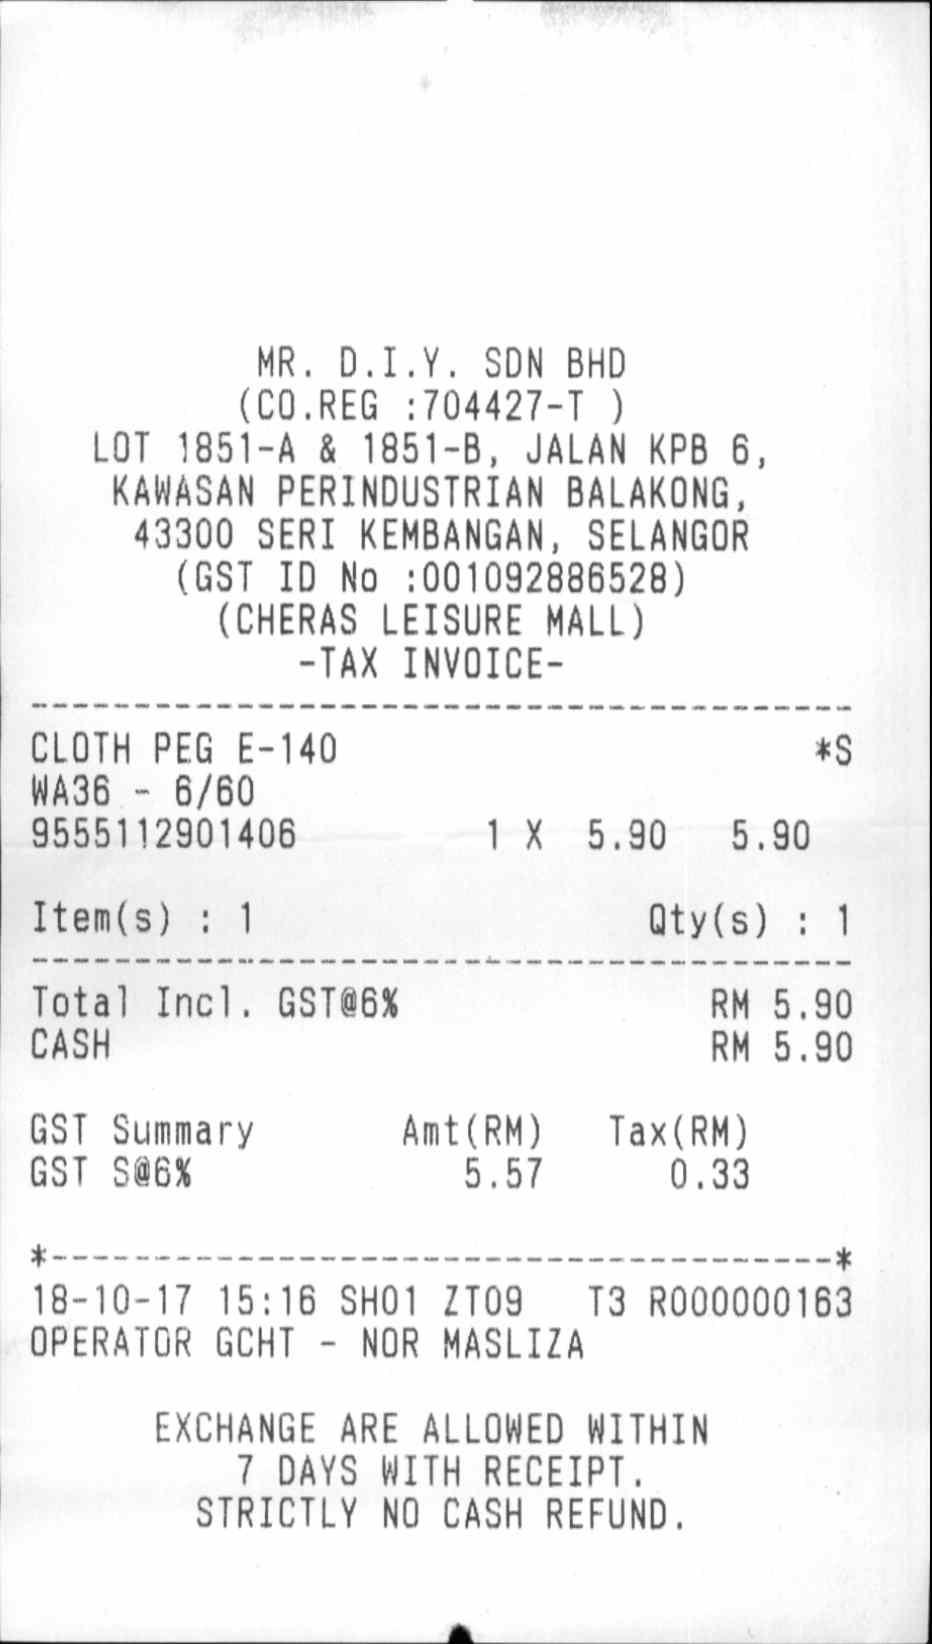
Xiaomi-OCR-0 parte de Qwen3.5-0.8B-Base y combina análisis documental, preguntas centradas en OCR y extracción de información. Un piloto útil puede limitarse a proveedor, fecha, moneda e importe de una familia concreta de recibos.
La salida no es un asiento validado. La aplicación necesita preparar imágenes, manejar páginas PDF, definir esquema, comprobar reglas, revisar excepciones y exportar. El objetivo es reducir correcciones, no producir un CSV de apariencia completa.
Página oficial capturada por AIDreamHub, no ejecución local del producto.
El editor publica 96,83 en OmniDocBench v1.6, 95,24 en Real5 y 87,94 en Wild. Son métricas de parsing, no exactitud de campos de facturas ni porcentaje de páginas perfectas. El informe usa PP-DocLayoutV3 en Real5; una inferencia de página completa no hereda esa cifra sin reproducir el proceso.
PaddleOCR-VL-1.6 figura con 96,33, 93,19 y 87,36 en la misma tabla. La cercanía no prueba una ventaja en tus documentos. Revisamos fuentes primarias, sin ejecutar un benchmark. La búsqueda devolvió principalmente noticias de lanzamiento, no un consenso amplio de pruebas independientes.
| Comparación del editor | OmniDocBench v1.6 | Real5 | Wild |
|---|---|---|---|
| Xiaomi-OCR-0 · 0.8B | 96.83 | 95.24 | 87.94 |
| PaddleOCR-VL-1.6 · 0.9B | 96.33 | 93.19 | 87.36 |
El repositorio documenta Python 3.10+, demo web, MCP y backends separados. SGLang o vLLM requieren un entorno compatible; Ollama experimental emplea un paquete BF16 comunitario. Los comandos siguientes recogen la ruta oficial de demo, no una instalación probada por nosotros.
Mantén Ollama activo, revisa dependencias en un entorno aislado y abre http://127.0.0.1:8787. Descargar el modelo no configura por sí solo preprocesado y decodificación: usa Demo o MCP. El modo de regiones añade PaddlePaddle, PaddleX y PP-DocLayoutV3; OCR de página completa, KIE y VQA no los necesitan.
ollama pull longwayxu/xiaomi-ocr-0:bf16
git clone https://github.com/xiaomi-research/Xiaomi-OCR-0.git
cd Xiaomi-OCR-0
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
export XIAOMI_OCR_BACKEND=ollama
export XIAOMI_OCR_MODEL=longwayxu/xiaomi-ocr-0:bf16
export XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:11434/v1
python demo/server.py --port 8787Usa muestras reales anonimizadas. Define supplier, document_number, invoice_date, currency, subtotal, tax y total antes de extraer. Permite null cuando no se lea y prohíbe adivinar. Conserva imagen, respuesta bruta y fila normalizada para rastrear cada corrección.
Separa desarrollo y prueba reservada por proveedor o plantilla. Incluye desenfoque, rotación, moneda ausente, devoluciones y varias páginas. Mide campos exactos y filas totalmente correctas por separado: nueve aciertos no compensan un total equivocado.
Valida primero la estructura JSON. Guarda identificadores como texto con sus ceros iniciales y normaliza fechas y monedas solo sin ambigüedad. Concilia importes considerando descuentos, cargos y redondeo. Marca diferencias; no inventes una corrección para cuadrarlas.
Neutraliza prefijos de fórmula en cadenas CSV no confiables antes de abrirlas en una hoja de cálculo. Guarda por separado el original y la exportación segura. Además de latencia, mide minutos de corrección por fila aceptada y porcentaje enviado a revisión humana.
| Campo | Comprobación | Si falla |
|---|---|---|
| Número | Texto y ceros iniciales | Comparar con la imagen |
| Fecha / moneda | Formato y significado inequívocos | Dejar vacío o revisar |
| Importes | Precisión y conciliación | Registrar discrepancia |
| Texto CSV | Evitar ejecución de fórmulas | Separar original y exportación |
Compara PaddleOCR-VL en documentos con mucho diseño, OCR tradicional con reglas en formularios estables y un VLM más potente cuando predomine la interpretación. Son opciones por flujo, no una clasificación de calidad medida aquí.
Usa las mismas imágenes reservadas, campos y reglas. Solo el consumo real, mantenimiento y carga de corrección permiten valorar la ventaja del modelo pequeño. 0,8B no fija RAM total, tiempo por página ni compatibilidad de cualquier cuantización.
| Ruta | Motivo | Pregunta de aceptación |
|---|---|---|
| Xiaomi-OCR-0 | Parsing y extracción compactos | ¿Son correctas las filas completas? |
| PaddleOCR-VL | Estructura documental | ¿Reduce omisiones de diseño? |
| OCR + reglas | Formularios estables | ¿Resiste cambios de plantilla? |
El checkpoint indica Apache-2.0, pero los componentes conservan términos propios. Descarga archivos antes del uso sin conexión y revisa imágenes, registros y PDF temporales. Un modelo local no convierte una demo remota en privada.
Ollama es experimental y sus siete ejemplos de alineación no prueban paridad general. Un enlace GGUF comunitario no estuvo disponible durante la revisión y no se recomienda aquí. Sigue la integración oficial vigente y registra modelo, proyector y runtime. El dibujo es una metáfora, no un resultado OCR generado.
Necesita esquema, fechas, monedas, conciliación, seguridad de fórmulas y revisión de excepciones. Guarda imagen y respuesta original. La unidad útil es una fila completa aceptada; JSON válido no significa datos correctos.
No automáticamente. El benchmark original y unas muestras de alineación no demuestran equivalencia de todas las conversiones. Preprocesado, proyector visual, runtime y decodificación importan. Evalúa el paquete real con documentos reservados.
El número de parámetros no garantiza hardware. Backend, imágenes, contexto y modelos de diseño opcionales añaden requisitos. Prepara archivos y verifica soporte del sistema; la documentación distingue GPU compatible y Ollama experimental.
Visit the official website to get started
Have an AI tool to share?
Get your product in front of people actively exploring AI tools.
Submit Your ToolAnyGen es un workspace de IA para informes, documentos, presentaciones, análisis, planes y entregables profesionales.
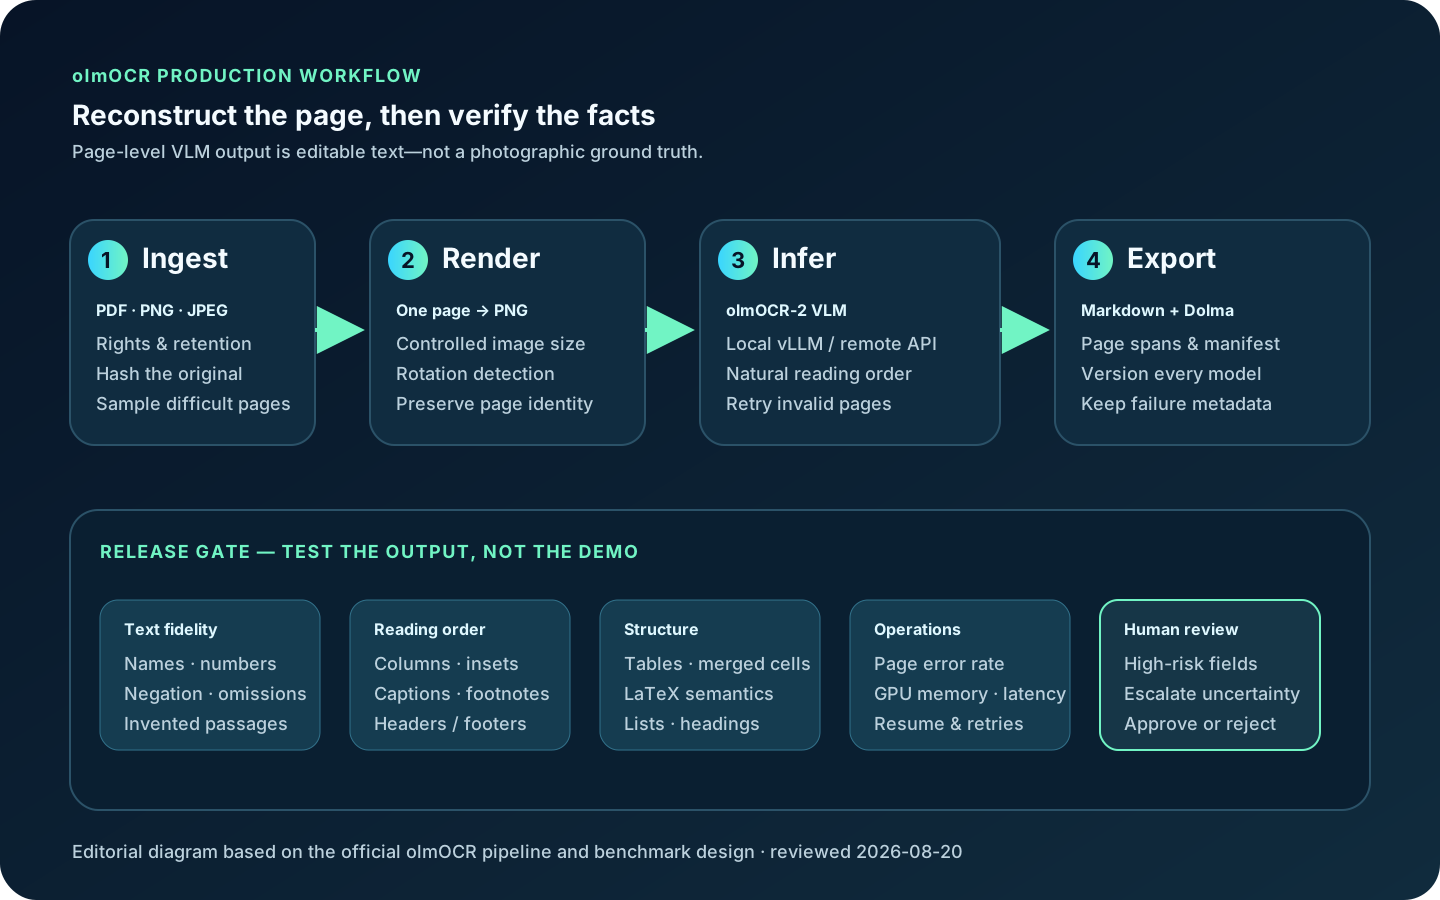
olmOCR es el sistema open source de AI2 para reconstruir documentos con GPU: convierte páginas PDF, PNG y JPEG en Markdown o texto de orden natural, incluidas tablas y fórmulas.
Gamma es un espacio de trabajo asistido por IA para crear presentaciones, documentos, páginas web, publicaciones sociales y gráficos editables. Esta guía independiente cubre los modos de creación, los límites actuales del plan, las importaciones y exportaciones, el control de calidad de la marca y la accesibilidad, la verificación de datos, la publicación del sitio, la privacidad y las alternativas.
Read AI Digital Twin - work digital twin. A partir de fuentes oficiales y públicas fiables, esta ficha resume usos, fortalezas, límites y alternativas. Antes de adoptarlo conviene revisar precio, permisos, privacidad, disponibilidad y calidad real.