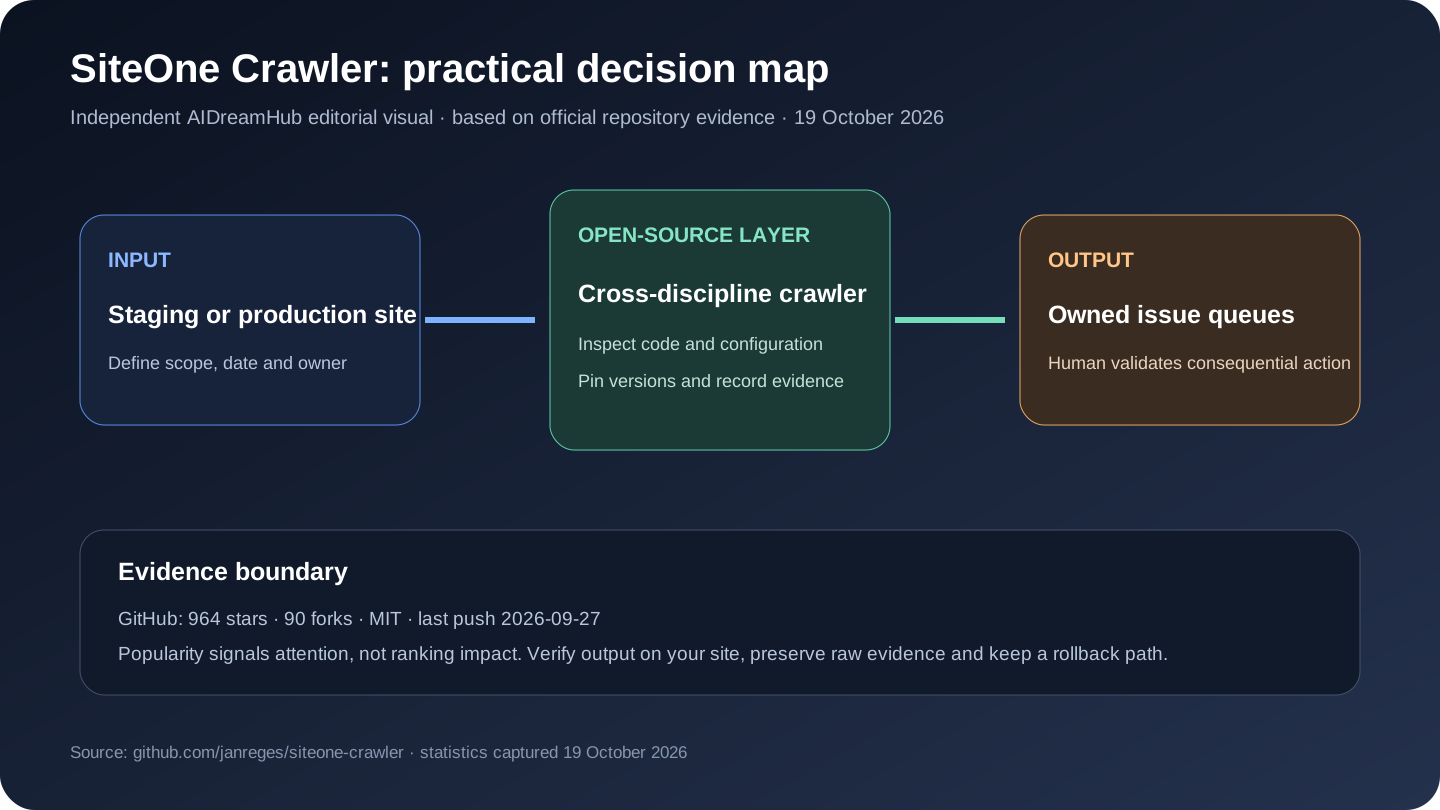
Veredicto independiente:SiteOne Crawler es un rastreador y analizador multiplataforma con licencia MIT que abarca SEO, seguridad, accesibilidad, rendimiento y garantía de calidad. Su mejor opción son los equipos que desean un inventario de sitio web repetible que alimente varios controles de calidad de ingeniería y marketing. El principal error de adopción sería tratar un repositorio abierto o un alto número de estrellas como prueba de que sus recomendaciones, datos o puntuaciones son correctos para cada sitio.
El informe multifuncional sólo es útil si el propietario envía los hallazgos; de lo contrario, la amplitud se convierte en un gran atraso sin regla de decisión.
Qué hace realmente SiteOne Crawler
SiteOne Crawler debe evaluarse como una herramienta de rastreo, no como una plataforma universal SEO. La descripción del repositorio verificado es: "SiteOne Crawler es un rastreador y analizador de sitios web multiplataforma para SEO, seguridad, accesibilidad y optimización del rendimiento, ideal para desarrolladores, DevOps, ingenieros de control de calidad y consultores. Compatible con Windows, macOS y Linux (x64 y arm64)". La distinción es importante porque un rastreador, una biblioteca de datos estructurados y un conector MCP resuelven diferentes capas del flujo de trabajo SEO.
| Capacidad verificada | Significado práctico |
|---|---|
| Se ejecuta en Windows, macOS y Linux, incluidas las compilaciones x64 y arm64 documentadas por el proyecto. | Verifique la configuración y la versión oficiales antes de confiar en ellas. |
| Combina el rastreo de sitios web con múltiples disciplinas de calidad, lo que lo hace útil para desarrolladores, DevOps, control de calidad y consultores. | Trate las integraciones como límites separados de confianza y costos. |
| Una cobertura amplia aumenta el trabajo de clasificación: un único rastreo puede combinar resultados de clasificación, seguridad, accesibilidad y rendimiento con diferentes propietarios y modelos de gravedad. | Compare el comportamiento en un sitio o cuenta representativa. |
Instantánea de evidencia actual GitHub
La siguiente tabla se capturó el 19 de octubre de 2026. "Último" significa actividad reciente del repositorio en esta revisión, mientras que "caliente" es una combinación de atención y actividad. Ninguno de los términos es una garantía de calidad.
| evidencia | Observado | como interpretarlo |
|---|---|---|
| Actividad del repositorio | 964 estrellas · 90 tenedores | Atención comunitaria y señal de reutilización; no es prueba de los resultados SEO |
| último empujón | 2026-09-27 | Actividad de código reciente; inspeccionar lanzamientos y cambios importantes antes de la producción |
| Licencia | MIT | Confirmar las obligaciones de distribución, uso de SaaS y modificaciones. |
| Pila primaria | óxido | Indica las habilidades de mantenimiento probables, no la integridad de las funciones. |
Flujos de trabajo que mejor se adaptan
Mejor ajuste:equipos que desean un inventario de sitio web repetible que alimente varios controles de calidad de ingeniería y marketing.
- Audite un sitio de prueba antes de lanzar un rediseño.
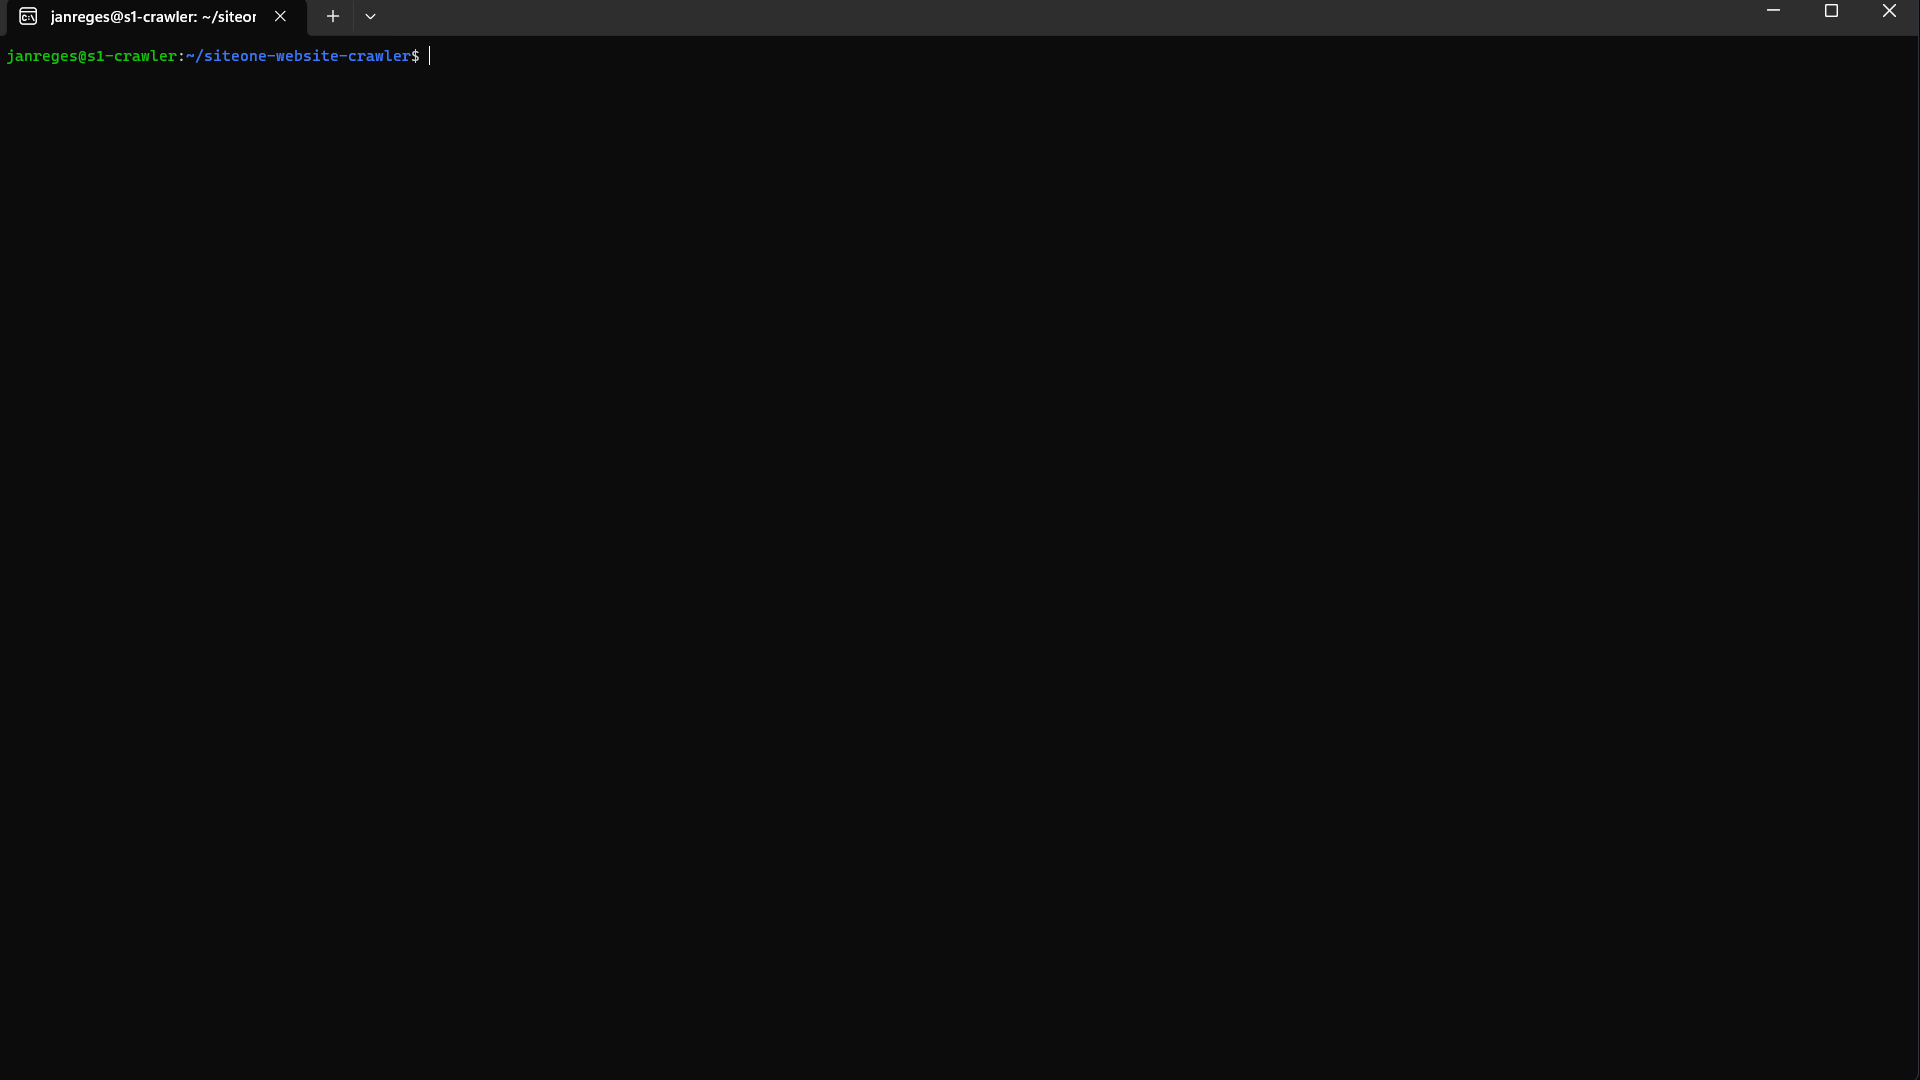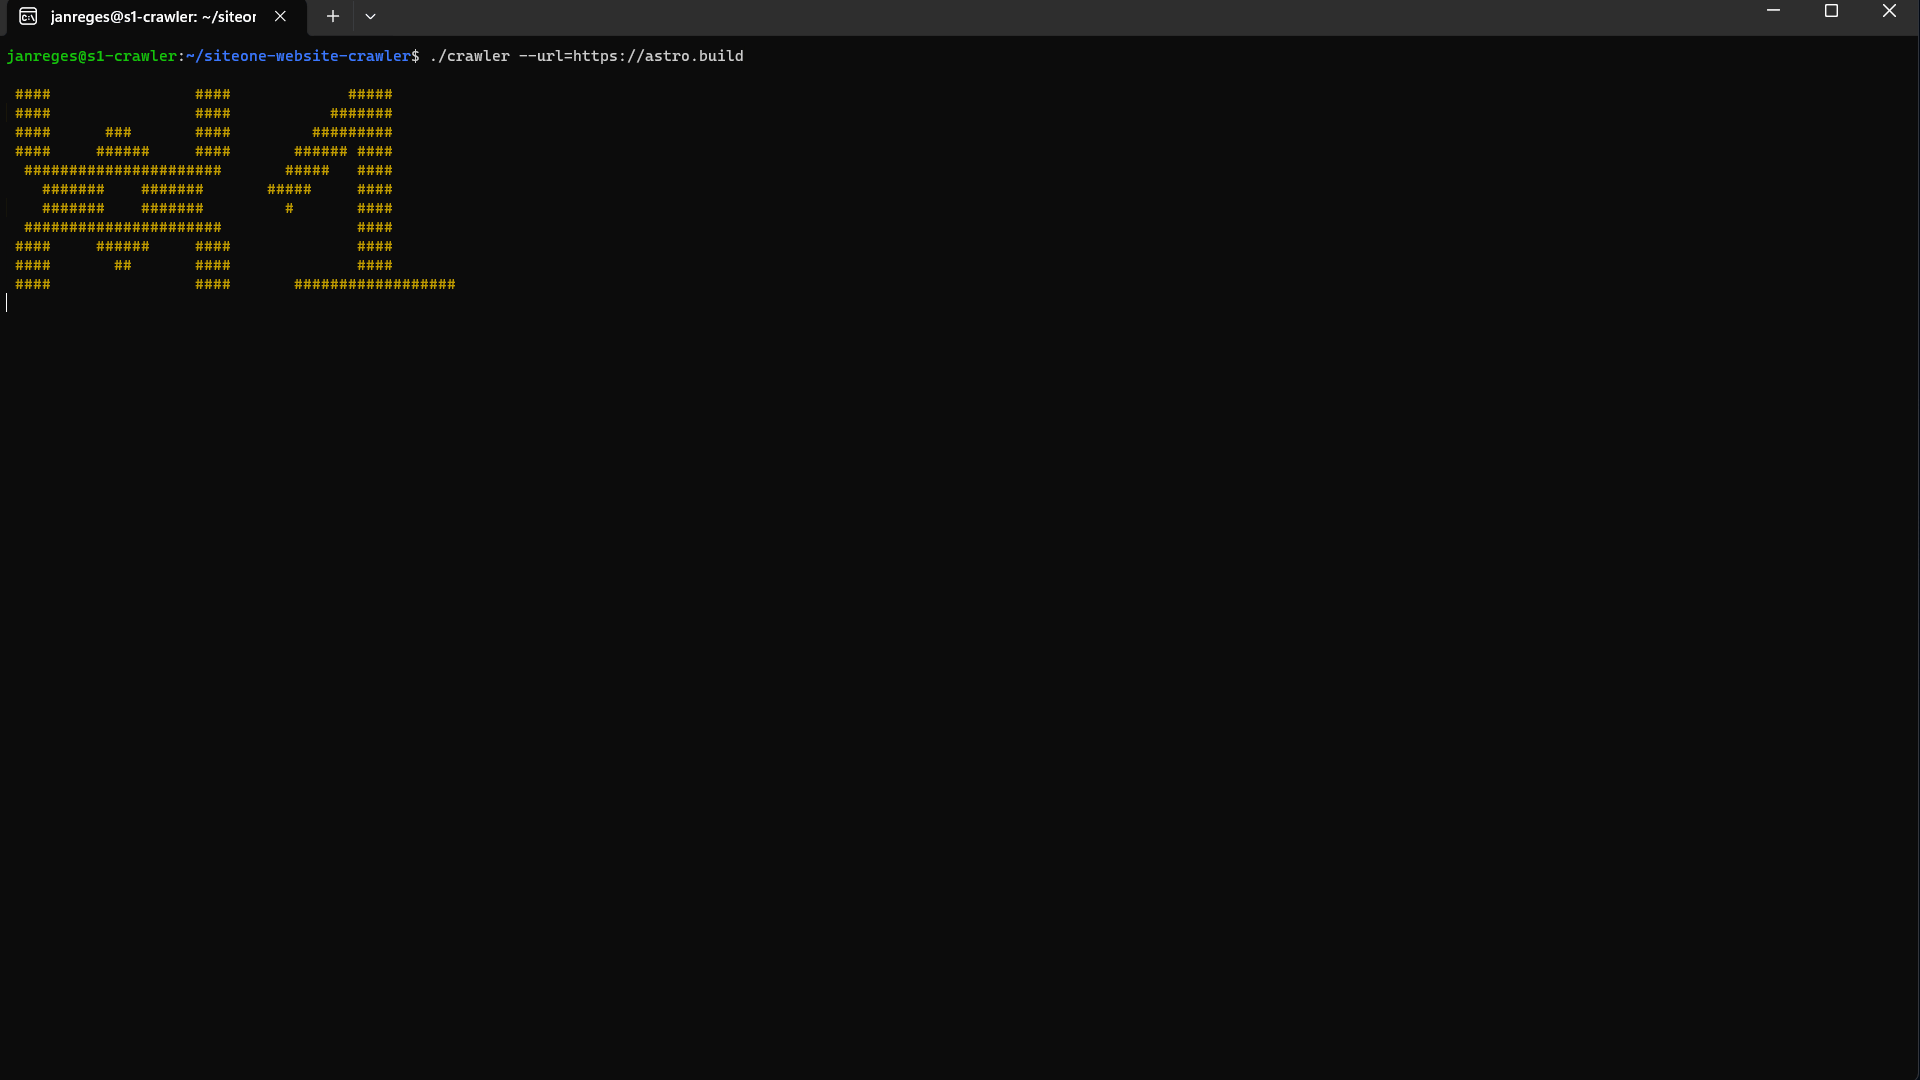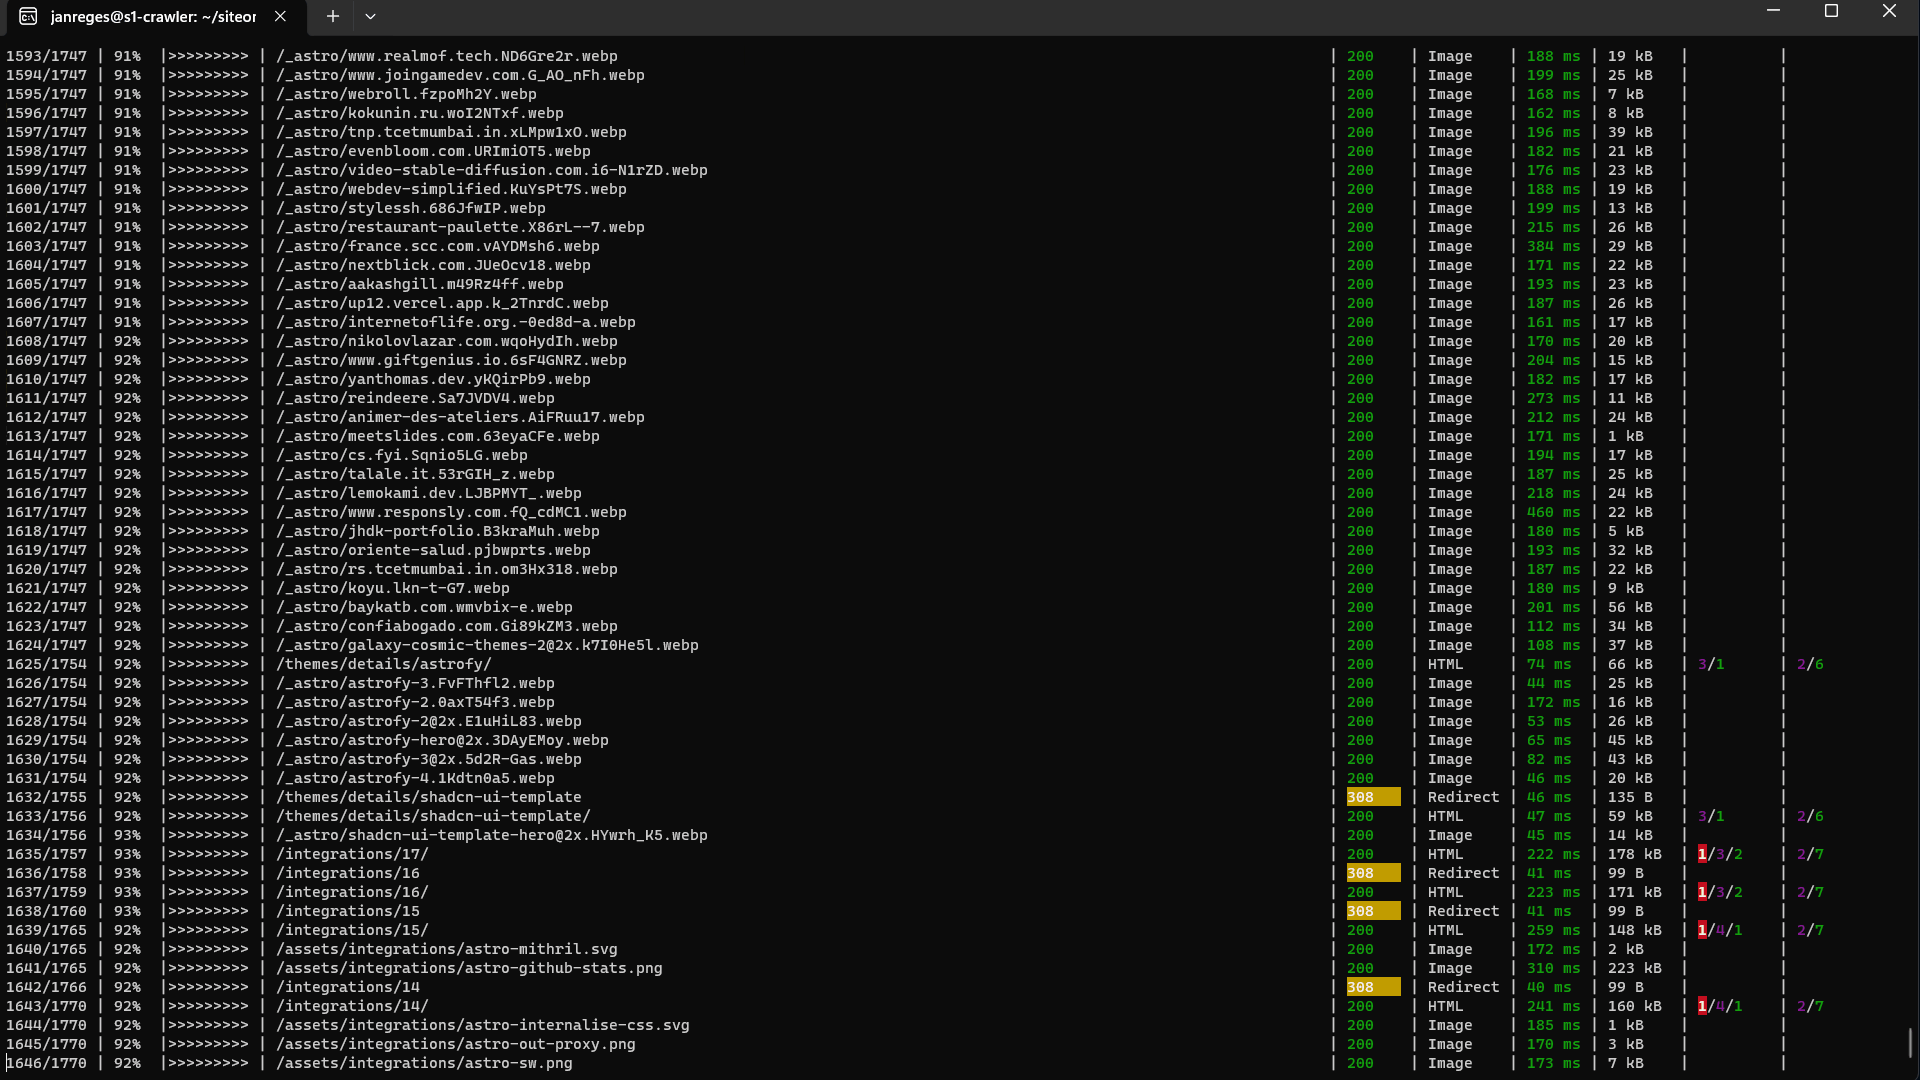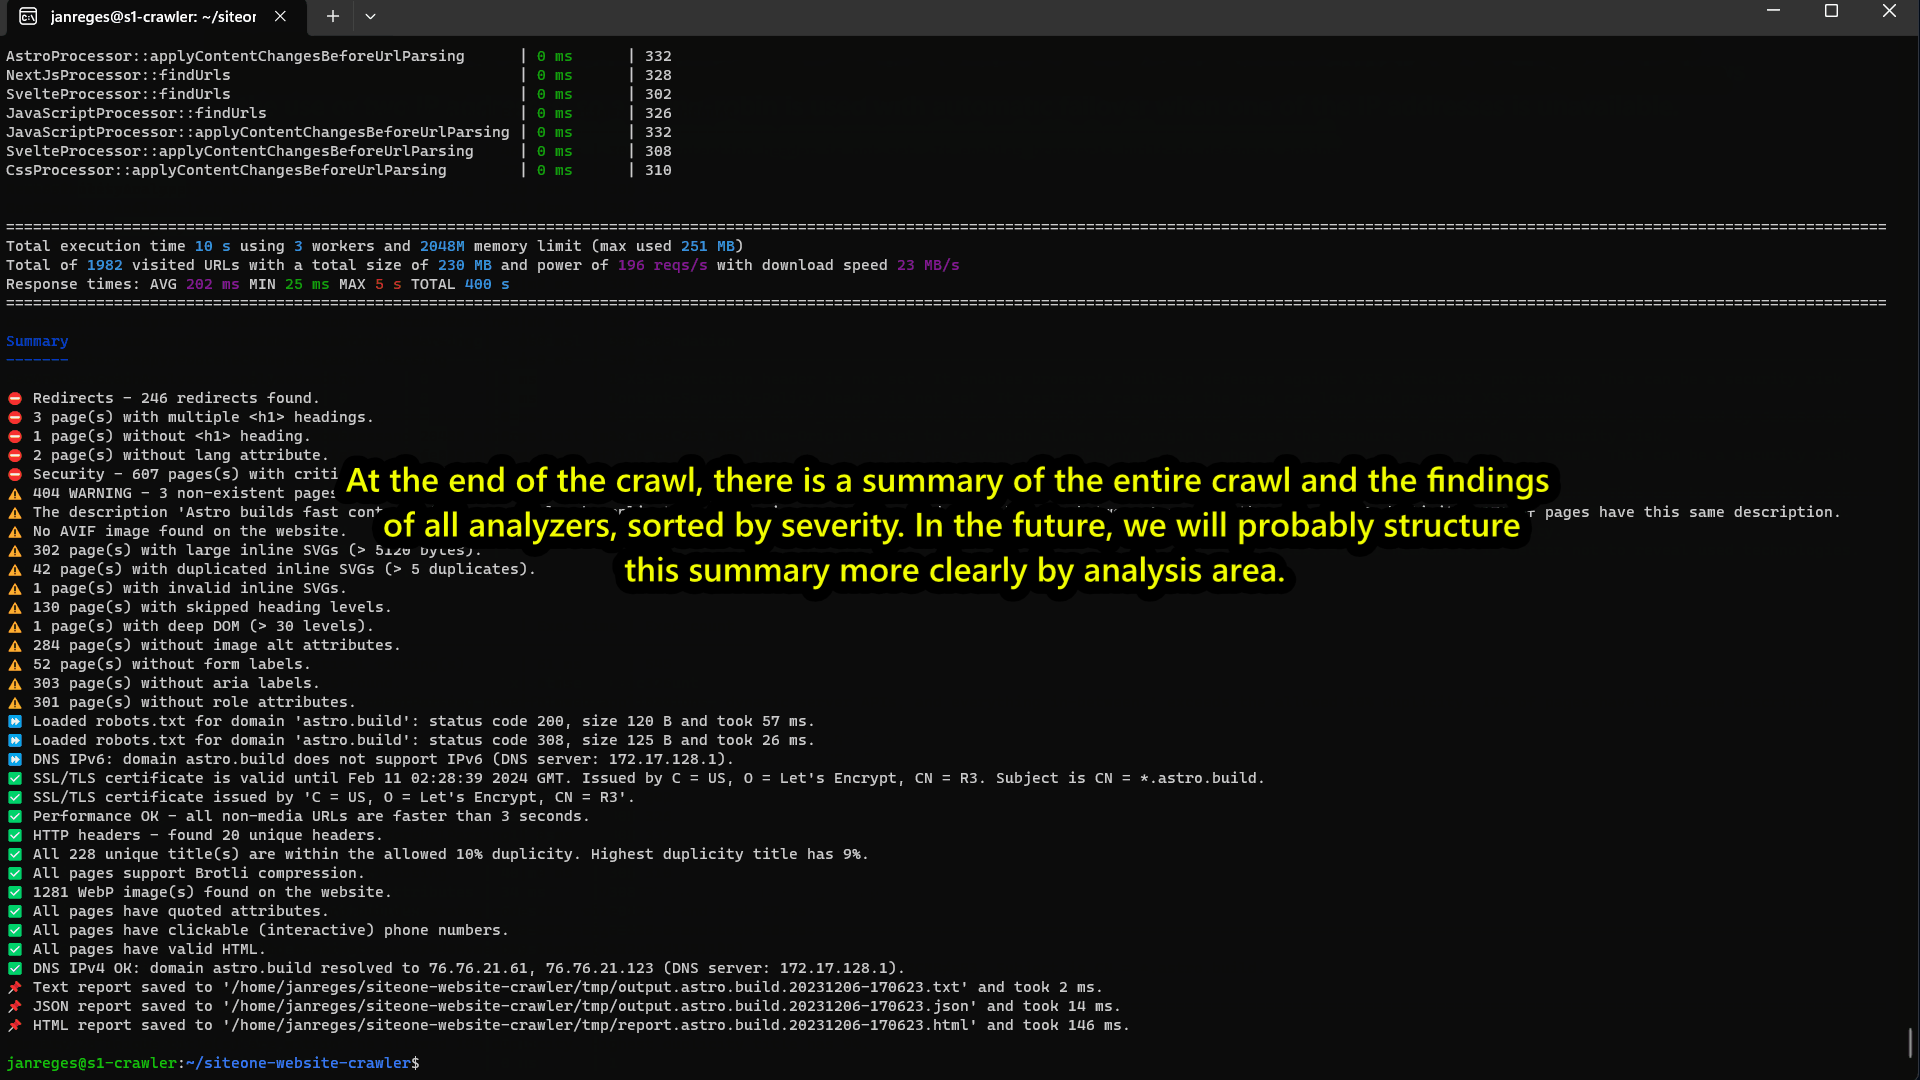
- Cree un informe de problemas multifuncional para SEO, propietarios de seguridad y accesibilidad.
- Ejecute comprobaciones repetibles de línea de comandos en una canalización de entrega.
Punto de partida práctico:Defina límites de rastreo y credenciales, ejecute una muestra provisional, dirija cada clase de problema al propietario adecuado, verifique los hallazgos críticos manualmente y luego establezca puertas de regresión estrechas.
Limitaciones, seguridad y coste operativo.
- Un escáner amplio puede ser menos especializado que herramientas dedicadas a cada disciplina.
- Las aplicaciones autenticadas y altamente interactivas requieren una configuración de rastreo cuidadosa.
- La gravedad debe reflejar el impacto en el usuario y en la empresa, no sólo en la etiqueta del escáner.
El código abierto elimina una forma de bloqueo, pero no elimina el tiempo de ingeniería, los cargos por modelo o API, los costos del navegador/proxy, los términos del proveedor de datos, el trabajo de autenticación, las copias de seguridad o el riesgo de actualización. Mapee cada servicio externo y cada acción con capacidad de escritura antes de su uso en producción.
SiteOne Crawler comparado con alternativas
| Opción | Elígelo cuando | Compensación |
|---|---|---|
| LibreCrawl | Rastreo y personalización locales centrados en SEO | alcance más limitado y producto más joven |
| SEOmator | gran conjunto de reglas deterministas con opciones de escritorio y agente | más SEO puntuación, informes diferentes |
| Escáneres especializados separados | trabajo regulado o profundo de seguridad/accesibilidad | Profundidad más precisa, mayor coordinación de herramientas. |
La comparación se basa en tareas, no en la afirmación de que un producto sea universalmente mejor. Una biblioteca estrecha puede superar a una suite dentro de su marco, mientras que un rastreador comercial maduro puede ser más barato que mantener una herramienta abierta a gran escala.
Una evaluación de siete pasos antes de la adopción
- 1.Defina una decisión y un conjunto de pruebas acotado antes de instalar o conectar cuentas.
- 2.Fije la revisión o versión del repositorio y registre la configuración utilizada.
- 3.Verifique varias salidas con la página en vivo, la consola de origen u otra herramienta independiente.
- 4.Separe las observaciones deterministas de las puntuaciones, estimaciones y recomendaciones escritas por modelos.
- 5.Mida los falsos positivos, la cobertura faltante, el tiempo de ejecución y el costo del proveedor en una muestra realista.
- 6.Utilice credenciales con privilegios mínimos; requieren aprobación para ediciones, envíos, depuraciones o publicaciones.
- 7.Mantenga las exportaciones sin procesar y un plan de reversión para que el resultado pueda auditarse después de una actualización.
Nuestra visión independiente
El informe multifuncional sólo es útil si el propietario envía los hallazgos; de lo contrario, la amplitud se convierte en un gran atraso sin regla de decisión. Ése es también el límite de decisión: conservar la herramienta si produce evidencia reproducible y reduce el trabajo en un sitio real; Rechazarlo si el equipo recibe principalmente más partituras, prosa o volumen de números sin decisiones más claras.
Preguntas frecuentes
¿Es realmente de código abierto?
La API GitHub informó MIT el 19 de octubre de 2026. Revise el archivo de licencia del repositorio y las licencias de dependencia para conocer los derechos y obligaciones exactos. Una API en la nube conectada o un servicio alojado puede tener términos separados incluso cuando el código del cliente está abierto.
¿La popularidad de GitHub significa que mejora la clasificación?
No. Las estrellas y las bifurcaciones indican atención y reutilización, no elevación en la clasificación, precisión de los datos o idoneidad para un sitio en particular. Utilice una evaluación controlada con Search Console, análisis y resultados verificados manualmente.
¿Para quién es mejor?
SiteOne Crawler es más adecuado para equipos que desean un inventario de sitio web repetible que alimente varios controles de calidad de ingeniería y marketing. No encaja bien cuando el equipo no puede operar su tiempo de ejecución, verificar su evidencia o poseer los permisos que solicita.
¿Qué se debe probar primero?
Utilice un flujo de trabajo representativo: audite un sitio de prueba antes de que se lance un rediseño. Registre los insumos, la producción bruta, el tiempo, las fallas y cualquier costo externo, luego compárelo con el método actual del equipo.
¿Puede reemplazar una suite comercial SEO?
Por lo general, solo para una parte definida del trabajo. Las herramientas de auditoría y flujo de trabajo de código abierto rara vez incluyen el mismo índice de vínculo de retroceso patentado, cobertura SERP histórica, organización de soporte, permisos e informes de cliente pulidos que una suite paga madura.
Cómo utilizar SiteOne Crawler: Quick Start
Este flujo de trabajo está condensado del archivo README y la documentación oficiales del proyecto. Ejecútelo primero en un sitio de prueba, propiedad de prueba o entorno local; verifique la fuente vinculada nuevamente cuando cambien las versiones.
Requisitos previos
- Un sistema Windows, macOS o Linux compatible
- Un binario precompilado o Homebrew en macOS/Linux
- Permisos y límites para el sitio de destino.
Instalar y ejecutar
brew install janreges/tap/siteone-crawler

# First crawl
siteone-crawler --url=https://example.com

# JavaScript rendering when required
siteone-crawler --url=https://example.com --browser --screenshots
Flujo de trabajo de primer uso
- Instale un binario prediseñado o el paquete Homebrew; Elija la variante de Linux compatible cuando glibc sea más antiguo.
- Ejecute el primer rastreo sin renderizar el navegador en un sitio pequeño.
- Revise el informe generado en las categorías SEO, seguridad, accesibilidad y rendimiento.
- Habilite --browser solo cuando la representación del cliente cambie materialmente la página.
- Asigne cada clase de problema verificado al propietario de ingeniería, contenido o seguridad correcto.
Cómo confirmar que funcionó
El rastreo se completa con un inventario de URL auditable y los hallazgos de alta gravedad verificados manualmente coinciden con la respuesta en vivo y la página representada.
Antes del uso en producción
La representación del navegador y las capturas de pantalla aumentan el tiempo de ejecución. No combine todas las categorías de escáneres en un trabajo pendiente sin propietario; Utilice puertas de regresión y gravedad específicas de la disciplina.
Fuente oficial Quick Start: janreges/siteone-crawler LÉAME.
Fuentes revisadas
- Repositorio oficial GitHub
- LÉAME oficial
- Lanzamientos oficiales
- Historial de compromisos
- Sitio web oficial del proyecto o documentación.
- Licencia de repositorio
Revisión editorial actualizada el 19 de octubre de 2026. Las estadísticas del repositorio, la documentación, las dependencias y los términos del servicio alojado pueden cambiar. Verifique las fuentes oficiales vinculadas antes de la instalación, adquisición o implementación.