Veredicto independiente:LibreCrawl es un rastreador SEO de escritorio con licencia MIT posicionado como una alternativa gratuita y personalizable para rastrear sitios, extraer datos SEO y exportar resultados. Su mejor opción son los consultores independientes y los equipos técnicos que valoran el control local y están dispuestos a probar un rastreador más joven. El principal error de adopción sería tratar un repositorio abierto o un alto número de estrellas como prueba de que sus recomendaciones, datos o puntuaciones son correctos para cada sitio.
Su diferenciador más fuerte es la inspeccionabilidad. La adopción aún debe decidirse mediante la paridad de rastreo y la tasa de falsos positivos en el sitio del propio equipo.
Qué hace realmente LibreCrawl
LibreCrawl debe evaluarse como una herramienta de rastreo, no como una plataforma universal SEO. La descripción del repositorio verificado es: "Rastreador SEO de escritorio gratuito: alternativa de código abierto a Screaming Frog y herramientas similares. Rastree sitios web, analice enlaces, extraiga datos SEO y exporte resultados sin tarifas de suscripción. ¡Totalmente personalizable y extensible!" La distinción es importante porque un rastreador, una biblioteca de datos estructurados y un conector MCP resuelven diferentes capas del flujo de trabajo SEO.
| Capacidad verificada | Significado práctico |
|---|---|
| Se centra en el rastreo de escritorios locales sin una suscripción de software recurrente. | Verifique la configuración y la versión oficiales antes de confiar en ellas. |
| El código abierto se puede ampliar para extracción personalizada y comprobaciones específicas del equipo. | Trate las integraciones como límites separados de confianza y costos. |
| El proyecto comenzó en 2025, por lo que su comportamiento de escala, cobertura de renderizado y pulido de informes deben compararse en lugar de inferirse de la lista de características. | Compare el comportamiento en un sitio o cuenta representativa. |
Instantánea de evidencia actual GitHub
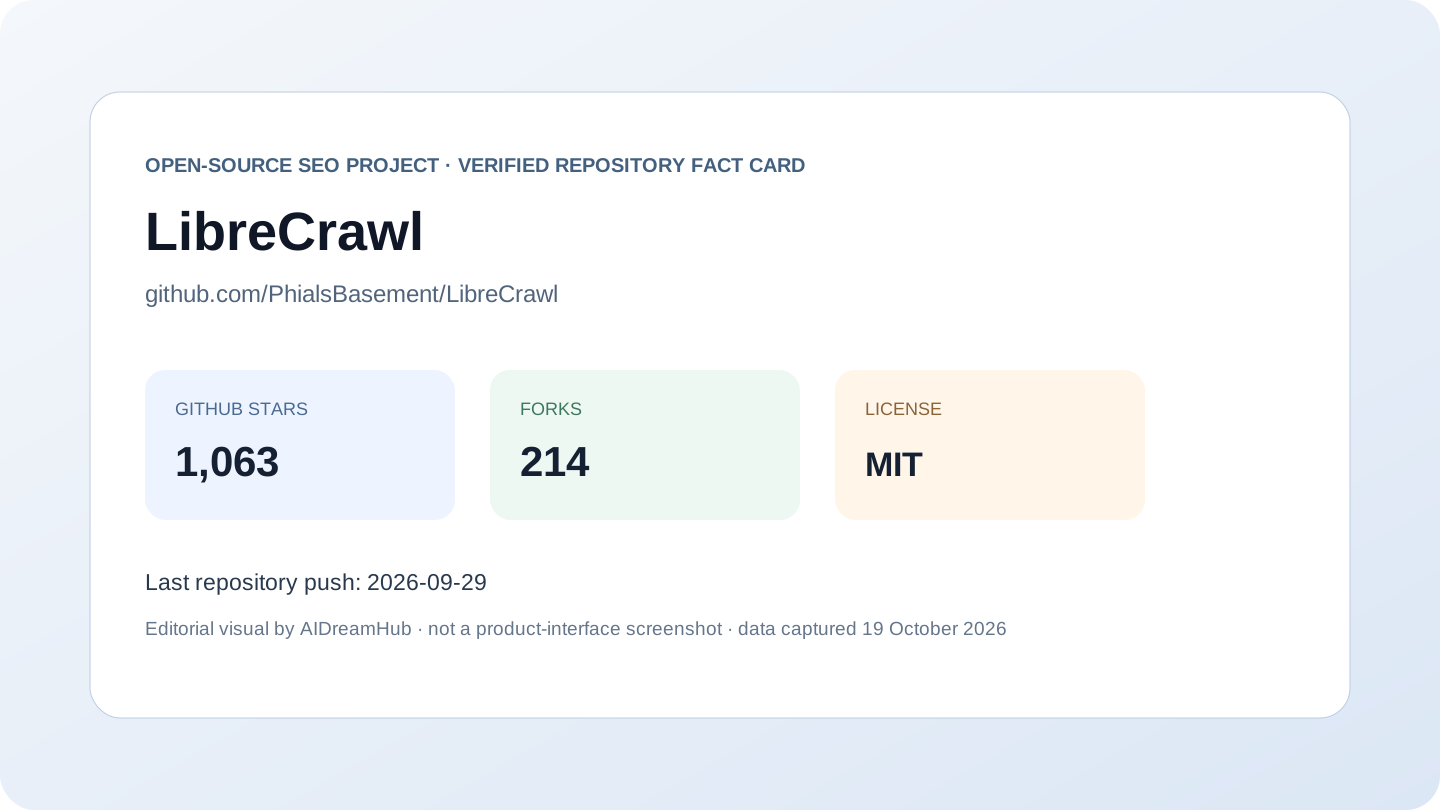
La siguiente tabla se capturó el 19 de octubre de 2026. "Último" significa actividad reciente del repositorio en esta revisión, mientras que "caliente" es una combinación de atención y actividad. Ninguno de los términos es una garantía de calidad.
| evidencia | Observado | como interpretarlo |
|---|---|---|
| Actividad del repositorio | 1.063 estrellas · 214 tenedores | Atención comunitaria y señal de reutilización; no es prueba de los resultados SEO |
| último empujón | 2026-09-29 | Actividad de código reciente; inspeccionar lanzamientos y cambios importantes antes de la producción |
| Licencia | MIT | Confirmar las obligaciones de distribución, uso de SaaS y modificaciones. |
| Pila primaria | pitón | Indica las habilidades de mantenimiento probables, no la integridad de las funciones. |
Flujos de trabajo que mejor se adaptan
Mejor ajuste:consultores independientes y equipos técnicos que valoran el control local y están dispuestos a probar un rastreador más joven.
- Cree un inventario local de títulos, encabezamientos, canónicos y códigos de estado.
- Exporte filas de rastreo para hojas de cálculo o análisis personalizados.
- Agregue extracción específica del proyecto o reglas de emisión en una bifurcación.
Punto de partida práctico:Compare un subdirectorio representativo con un rastreador establecido, compare el descubrimiento de URL y la salida representada, mida el uso de la memoria y mantenga un archivo de configuración reproducible.
Limitaciones, seguridad y coste operativo.
- Los recursos del escritorio limitan los rastreos muy grandes y la representación de JavaScript puede aumentar el tiempo y el uso de la memoria.
- El código abierto no garantiza un modelo de problema maduro, una respuesta de soporte o una cadencia de actualización.
- Los hallazgos del rastreador aún necesitan registros, análisis y evidencia Search Console para la priorización.
El código abierto elimina una forma de bloqueo, pero no elimina el tiempo de ingeniería, los cargos por modelo o API, los costos del navegador/proxy, los términos del proveedor de datos, el trabajo de autenticación, las copias de seguridad o el riesgo de actualización. Mapee cada servicio externo y cada acción con capacidad de escritura antes de su uso en producción.
LibreCrawl comparado con alternativas
| Opción | Elígelo cuando | Compensación |
|---|---|---|
| Screaming Frog | rastreo técnico configurable maduro | licencia comercial por encima del límite gratuito |
| Rastreador SiteOne | SEO más seguridad, accesibilidad y rendimiento | alcance más amplio, flujo de trabajo diferente |
| SEOnauta | auditorías recurrentes autohospedadas | Configuración de servidor y base de datos en lugar de uso de escritorio. |
La comparación se basa en tareas, no en la afirmación de que un producto sea universalmente mejor. Una biblioteca estrecha puede superar a una suite dentro de su marco, mientras que un rastreador comercial maduro puede ser más barato que mantener una herramienta abierta a gran escala.
Una evaluación de siete pasos antes de la adopción
- 1.Defina una decisión y un conjunto de pruebas acotado antes de instalar o conectar cuentas.
- 2.Fije la revisión o versión del repositorio y registre la configuración utilizada.
- 3.Verifique varias salidas con la página en vivo, la consola de origen u otra herramienta independiente.
- 4.Separe las observaciones deterministas de las puntuaciones, estimaciones y recomendaciones escritas por modelos.
- 5.Mida los falsos positivos, la cobertura faltante, el tiempo de ejecución y el costo del proveedor en una muestra realista.
- 6.Utilice credenciales con privilegios mínimos; requieren aprobación para ediciones, envíos, depuraciones o publicaciones.
- 7.Mantenga las exportaciones sin procesar y un plan de reversión para que el resultado pueda auditarse después de una actualización.
Nuestra visión independiente
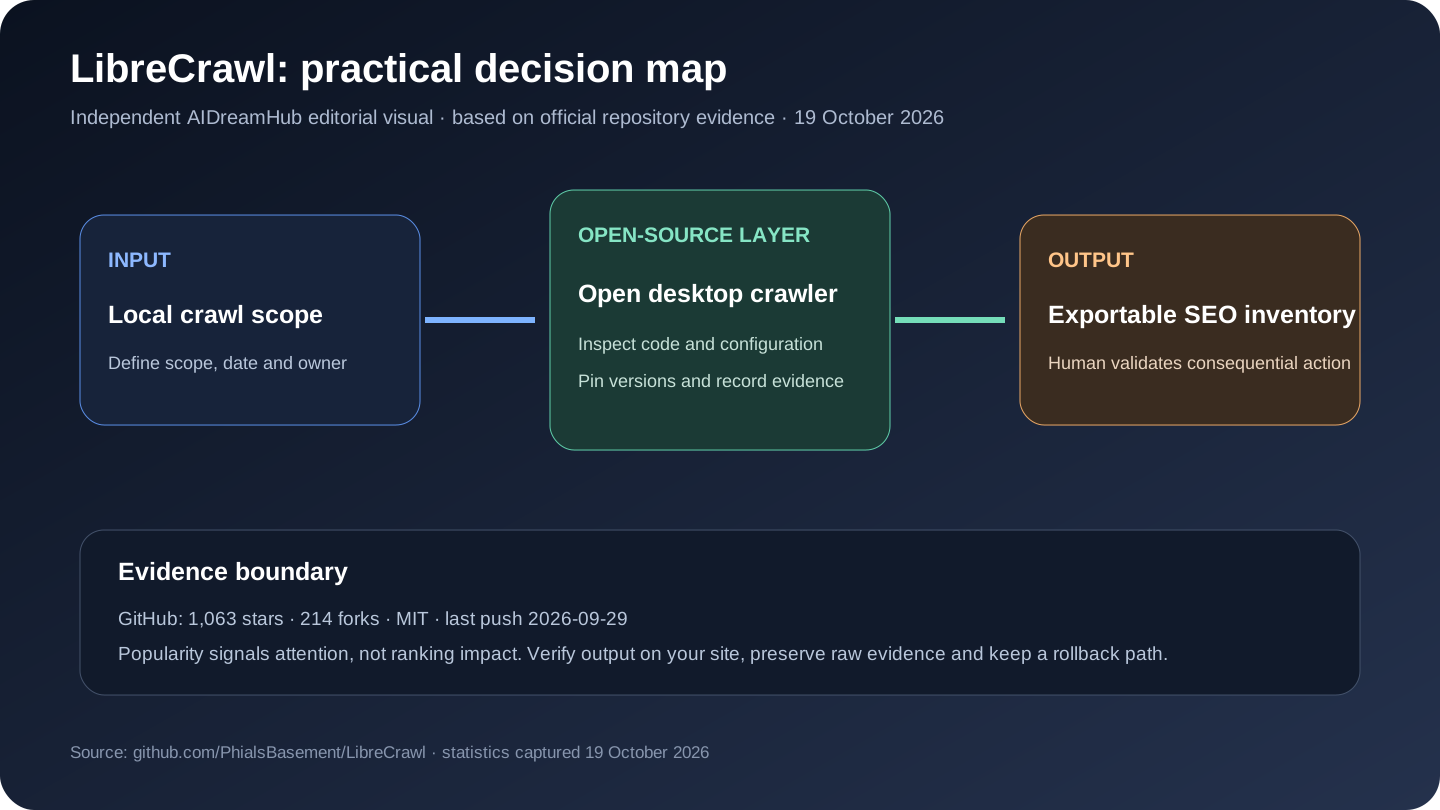
Su diferenciador más fuerte es la inspeccionabilidad. La adopción aún debe decidirse mediante la paridad de rastreo y la tasa de falsos positivos en el sitio del propio equipo. Ése es también el límite de decisión: conservar la herramienta si produce evidencia reproducible y reduce el trabajo en un sitio real; Rechazarlo si el equipo recibe principalmente más partituras, prosa o volumen de números sin decisiones más claras.
Preguntas frecuentes
¿Es realmente de código abierto?
La API GitHub informó MIT el 19 de octubre de 2026. Revise el archivo de licencia del repositorio y las licencias de dependencia para conocer los derechos y obligaciones exactos. Una API en la nube conectada o un servicio alojado puede tener términos separados incluso cuando el código del cliente está abierto.
¿La popularidad de GitHub significa que mejora la clasificación?
No. Las estrellas y las bifurcaciones indican atención y reutilización, no elevación en la clasificación, precisión de los datos o idoneidad para un sitio en particular. Utilice una evaluación controlada con Search Console, análisis y resultados verificados manualmente.
¿Para quién es mejor?
LibreCrawl es más adecuado para consultores independientes y equipos técnicos que valoran el control local y están dispuestos a probar un rastreador más joven. No encaja bien cuando el equipo no puede operar su tiempo de ejecución, verificar su evidencia o poseer los permisos que solicita.
¿Qué se debe probar primero?
Utilice un flujo de trabajo representativo: cree un inventario local de títulos, encabezados, códigos canónicos y de estado. Registre los insumos, la producción bruta, el tiempo, las fallas y cualquier costo externo, luego compárelo con el método actual del equipo.
¿Puede reemplazar una suite comercial SEO?
Por lo general, solo para una parte definida del trabajo. Las herramientas de auditoría y flujo de trabajo de código abierto rara vez incluyen el mismo índice de vínculo de retroceso patentado, cobertura SERP histórica, organización de soporte, permisos e informes de cliente pulidos que una suite paga madura.
Cómo utilizar LibreCrawl: Quick Start
Este flujo de trabajo está condensado del archivo README y la documentación oficiales del proyecto. Ejecútelo primero en un sitio de prueba, propiedad de prueba o entorno local; verifique la fuente vinculada nuevamente cuando cambien las versiones.
Requisitos previos
- Docker y Docker Redactar para la ruta recomendada
- git
- Suficiente memoria local y disco para el rastreo y la representación de JavaScript opcional.
Instalar y ejecutar
git clone https://github.com/PhialsBasement/LibreCrawl.git
cd LibreCrawl
cp .env.example .env
docker compose up -d

# Open the local interface
http://localhost:5000
Flujo de trabajo de primer uso
- Clone el repositorio y revise el archivo del entorno de muestra.
- Mantenga LOCAL_MODE habilitado solo para uso local privado e inicie los servicios Docker.
- Abra la interfaz de usuario local y cree un pequeño rastreo con URL conservadoras y límites de simultaneidad.
- Exporte el resultado y compare las URL descubiertas, las canónicas y los resultados renderizados con un segundo rastreador.
Cómo confirmar que funcionó
Se abre la interfaz local, se completa el rastreo delimitado y las filas exportadas coinciden con las páginas verificadas manualmente sin inflación de URL inexplicable.
Antes del uso en producción
El script de inicio automático puede instalar dependencias y navegadores. Revíselo antes de usarlo, nunca exponga el modo local no autenticado a Internet y compare el uso de recursos antes de rastreos grandes.
Fuente oficial Quick Start: PhialsBasement/LibreCrawl LÉAME.
Fuentes revisadas
- Repositorio oficial GitHub
- LÉAME oficial
- Lanzamientos oficiales
- Historial de compromisos
- Licencia de repositorio
Revisión editorial actualizada el 19 de octubre de 2026. Las estadísticas del repositorio, la documentación, las dependencias y los términos del servicio alojado pueden cambiar. Verifique las fuentes oficiales vinculadas antes de la instalación, adquisición o implementación.