AnyGen
AnyGen ist ein AI Workspace für Berichte, Dokumente, Präsentationen, Analysen, Pläne und professionelle Deliverables.
AnyGenAI workspaceAI assistant
1650
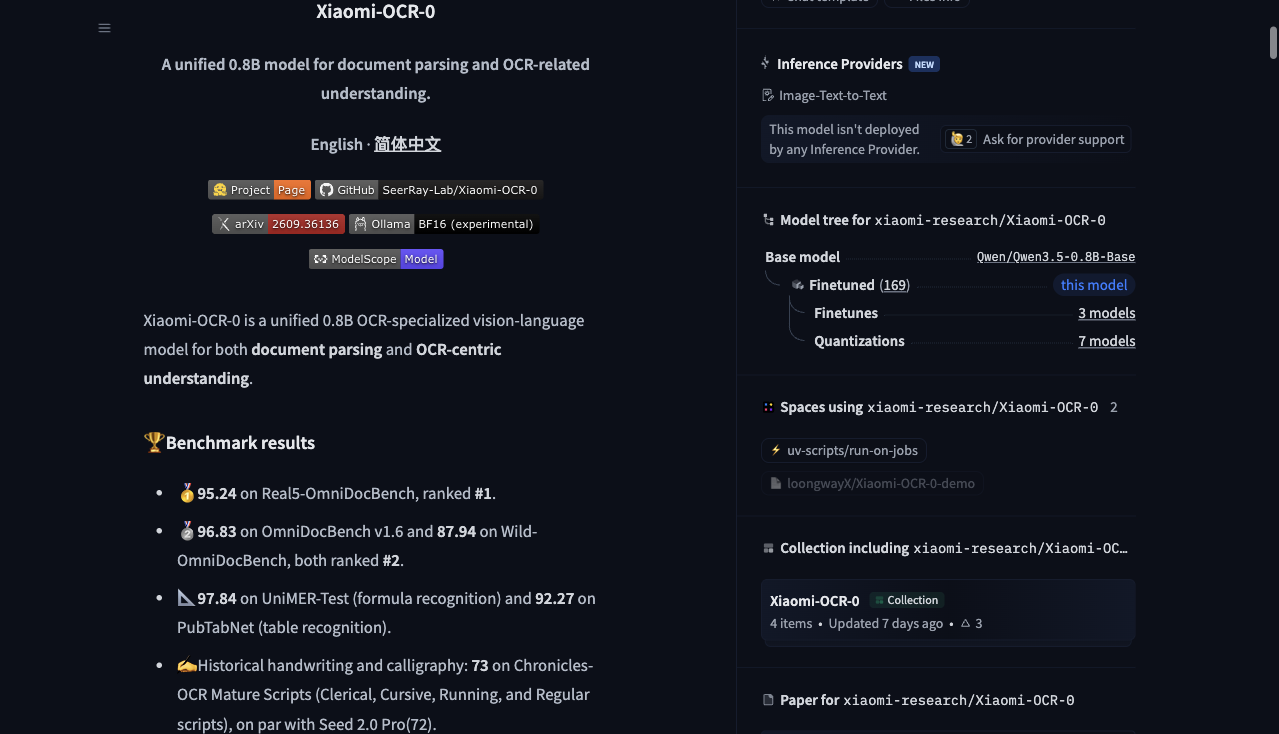
Xiaomi-OCR-0 ist ein 0,8B-Dokumentmodell für Seiten, Tabellen, Formeln, Dokumentfragen und strukturierte Felder. Entscheidend ist die Validierung nach der Extraktion.
0
Views
0
Likes
Nov 2026
Added
huggingface.co
Website
A quick visual look at Xiaomi-OCR-0 before you visit the official site.
Editorial Review
Quellenstand: 6. November 2026. Aussagen des Herausgebers und Drittversuche sind getrennt; kein eigener AIDreamHub-Benchmark.
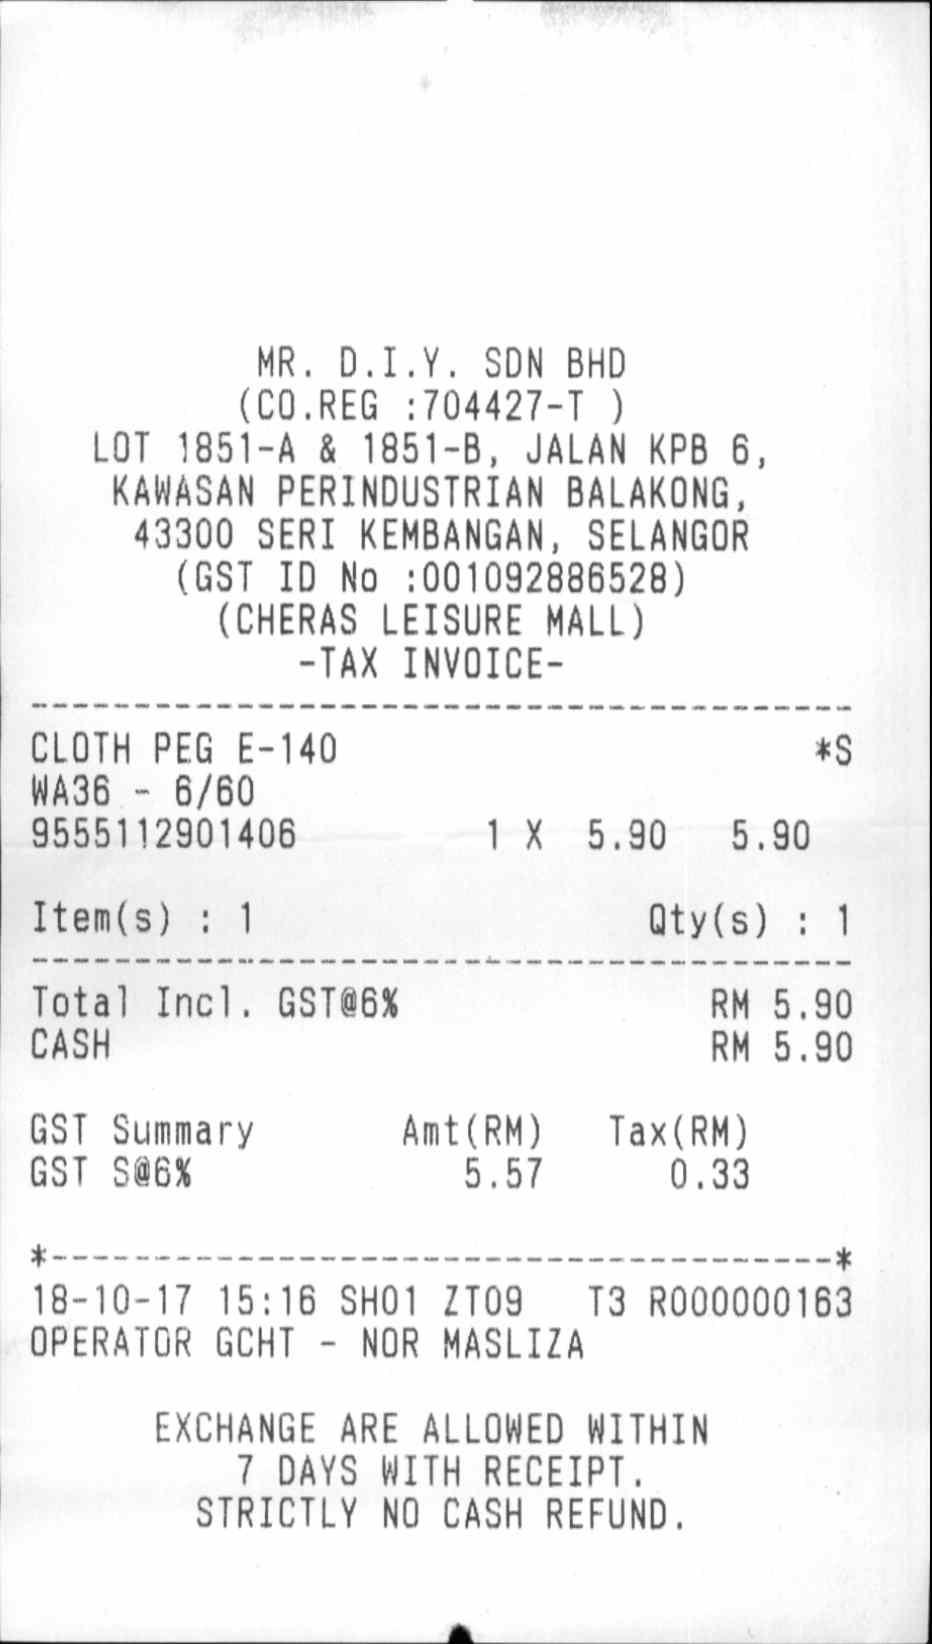
Xiaomi-OCR-0 basiert auf Qwen3.5-0.8B-Base und verbindet Parsing, OCR-bezogene Fragen und Schlüsselinformationsextraktion. Ein sinnvoller Pilot beschränkt sich etwa auf Lieferant, Datum, Währung und Gesamtbetrag einer klar definierten Belegfamilie.
Die Ausgabe ist noch kein geprüfter Buchungsdatensatz. Bildvorbereitung, PDF-Seiten, Schema, deterministische Prüfungen, Ausnahmen und Export gehören zur Anwendung. Ihr Nutzen liegt in weniger Korrekturarbeit, nicht in einer lediglich vollständig aussehenden CSV.
Von AIDreamHub aufgenommene offizielle Projektseite, kein lokal ausgeführtes Produkt.
Der Herausgeber nennt 96,83 auf OmniDocBench v1.6, 95,24 auf Real5 und 87,94 auf Wild. Das sind Parsingwerte, keine Rechnungsfeldgenauigkeit und kein Anteil vollständig korrekter Seiten. Für Real5 verwendet der Bericht PP-DocLayoutV3; eine reine Ganzseiteninferenz darf diesen Wert nicht ohne Reproduktion übernehmen.
PaddleOCR-VL-1.6 erreicht in derselben Tabelle 96,33, 93,19 und 87,36. Daraus folgt kein sicherer Geschäftsvorteil auf eigenen Belegen. Wir haben Primärquellen geprüft, aber keinen Benchmark ausgeführt. Die Recherche ergab überwiegend Veröffentlichungsberichte, keinen breiten unabhängigen Genauigkeitskonsens.
| Herausgebervergleich | OmniDocBench v1.6 | Real5 | Wild |
|---|---|---|---|
| Xiaomi-OCR-0 · 0.8B | 96.83 | 95.24 | 87.94 |
| PaddleOCR-VL-1.6 · 0.9B | 96.33 | 93.19 | 87.36 |
Das Repository dokumentiert Python 3.10+, Browser-Demo, MCP und getrennte Inferenz-Backends. SGLang oder vLLM benötigen eine kompatible Umgebung; experimentelles Ollama verwendet ein Community-BF16-Paket. Die folgenden Befehle geben den offiziellen Demo-Weg wieder, nicht eine von uns getestete Installation.
Ollama weiterlaufen lassen, Abhängigkeiten in einer isolierten Umgebung prüfen und danach http://127.0.0.1:8787 öffnen. Ein Modell-Pull allein richtet Vorverarbeitung und Dekodierung nicht ein. Dafür Demo oder MCP verwenden. Region-Modus braucht zusätzlich PaddlePaddle, PaddleX und PP-DocLayoutV3; Ganzseiten-OCR, KIE und VQA nicht.
ollama pull longwayxu/xiaomi-ocr-0:bf16
git clone https://github.com/xiaomi-research/Xiaomi-OCR-0.git
cd Xiaomi-OCR-0
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
export XIAOMI_OCR_BACKEND=ollama
export XIAOMI_OCR_MODEL=longwayxu/xiaomi-ocr-0:bf16
export XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:11434/v1
python demo/server.py --port 8787Beginnen Sie mit anonymisierten realistischen Bildern. Definieren Sie supplier, document_number, invoice_date, currency, subtotal, tax und total vorab. Unlesbare Werte dürfen null sein, Raten ist untersagt. Verknüpfen Sie Original, rohe Antwort und normalisierte Zeile.
Teilen Sie Entwicklungs- und zurückgehaltene Testdaten nach Lieferant oder Vorlage. Unschärfe, Drehung, fehlende Währung, Erstattung und Mehrseitigkeit gehören hinein. Feldtreffer und vollständig richtige Zeilen getrennt zählen: Ein falscher Gesamtbetrag bleibt ein gescheiterter Datensatz, auch wenn neun andere Felder stimmen.
JSON zunächst gegen das Schema validieren. Nummern als Strings mit führenden Nullen erhalten; Datum und Währung nur eindeutig normalisieren. Beträge unter Berücksichtigung von Rabatten, Gebühren und Rundung prüfen. Eine Differenz markieren, nicht durch erfundene Korrekturen beseitigen.
Nicht vertrauenswürdige CSV-Strings gegen Formelausführung in Tabellenprogrammen absichern. Rohdaten und sichere Exportfassung getrennt aufbewahren. Messen Sie Korrekturminuten pro akzeptierter Zeile, Latenz und Weiterleitungsquote an Menschen.
| Bereich | Prüfung | Bei Fehler |
|---|---|---|
| Belegnummer | String, führende Nullen | Original vergleichen |
| Datum / Währung | Eindeutige Bedeutung | Leer lassen oder prüfen |
| Beträge | Präzision und Abstimmung | Differenz markieren |
| CSV-Strings | Formelpräfixe entschärfen | Roh- und Exportdaten trennen |
PaddleOCR-VL eignet sich als Vergleich bei komplexem Layout, klassisches OCR plus Regeln bei stabilen Formularen und ein stärkeres VLM bei ungewöhnlicher Interpretation. Das sind Arbeitsweisen, keine von uns gemessene Rangliste.
Verwenden Sie dieselben Testbilder, Felder und Abnahmeregeln. Erst tatsächlicher Speicherbedarf, Wartung und Korrekturen zeigen, ob das kleine Modell günstiger ist. 0,8B Parameter bestimmen weder Gesamtspeicher noch Seitenzeit oder Kompatibilität jeder Quantisierung.
| Weg | Vergleichsgrund | Abnahmefrage |
|---|---|---|
| Xiaomi-OCR-0 | Kompaktes Parsing und Extraktion | Sind vollständige Zeilen richtig? |
| PaddleOCR-VL | Dokumentlayout | Weniger ausgelassene Inhalte? |
| OCR + Regeln | Stabile Formulare | Robust gegen Vorlagenänderung? |
Der Checkpoint trägt Apache-2.0; weitere Komponenten behalten eigene Bedingungen. Für Offlinebetrieb zuerst Dateien laden und Speicherorte von Bildern, Logs und temporären PDFs prüfen. Eine entfernte Demo ist nicht allein durch das lokale Modell privat.
Ollama ist experimentell; sieben Alignment-Beispiele belegen keine allgemeine Benchmark-Parität. Ein verlinktes Community-GGUF war bei der Prüfung nicht erreichbar und wird nicht empfohlen. Nutzen Sie aktuelle offizielle Anleitungen und dokumentieren Sie Modell, Projektor und Runtime. Die Zeichnung ist eine Prozessmetapher, kein erzeugtes OCR-Ergebnis.
Nein: Schema, Datum, Währung, Beträge, Formelsicherheit und Ausnahmen müssen geprüft werden. Original und rohe Antwort bleiben erhalten. Entscheidend ist die vollständig akzeptierte Zeile, nicht bloß syntaktisch gültiges JSON.
Nicht automatisch. Original-Benchmarks und wenige Alignment-Beispiele beweisen keine Gleichwertigkeit jeder Konvertierung. Vorverarbeitung, Vision-Projektor, Runtime und Dekodierung beeinflussen das Ergebnis. Testen Sie das tatsächlich eingesetzte Paket auf eigenen zurückgehaltenen Dokumenten.
Die Größe ist keine Hardwaregarantie. Backend, Bildverarbeitung, Kontext und optionale Layoutmodelle bringen zusätzliche Anforderungen mit. Dateien vorab laden und Betriebssystem-Unterstützung prüfen; offizielle GPU- und experimentelle Ollama-Wege sind getrennt zu betrachten.
Visit the official website to get started
Have an AI tool to share?
Get your product in front of people actively exploring AI tools.
Submit Your ToolAnyGen ist ein AI Workspace für Berichte, Dokumente, Präsentationen, Analysen, Pläne und professionelle Deliverables.
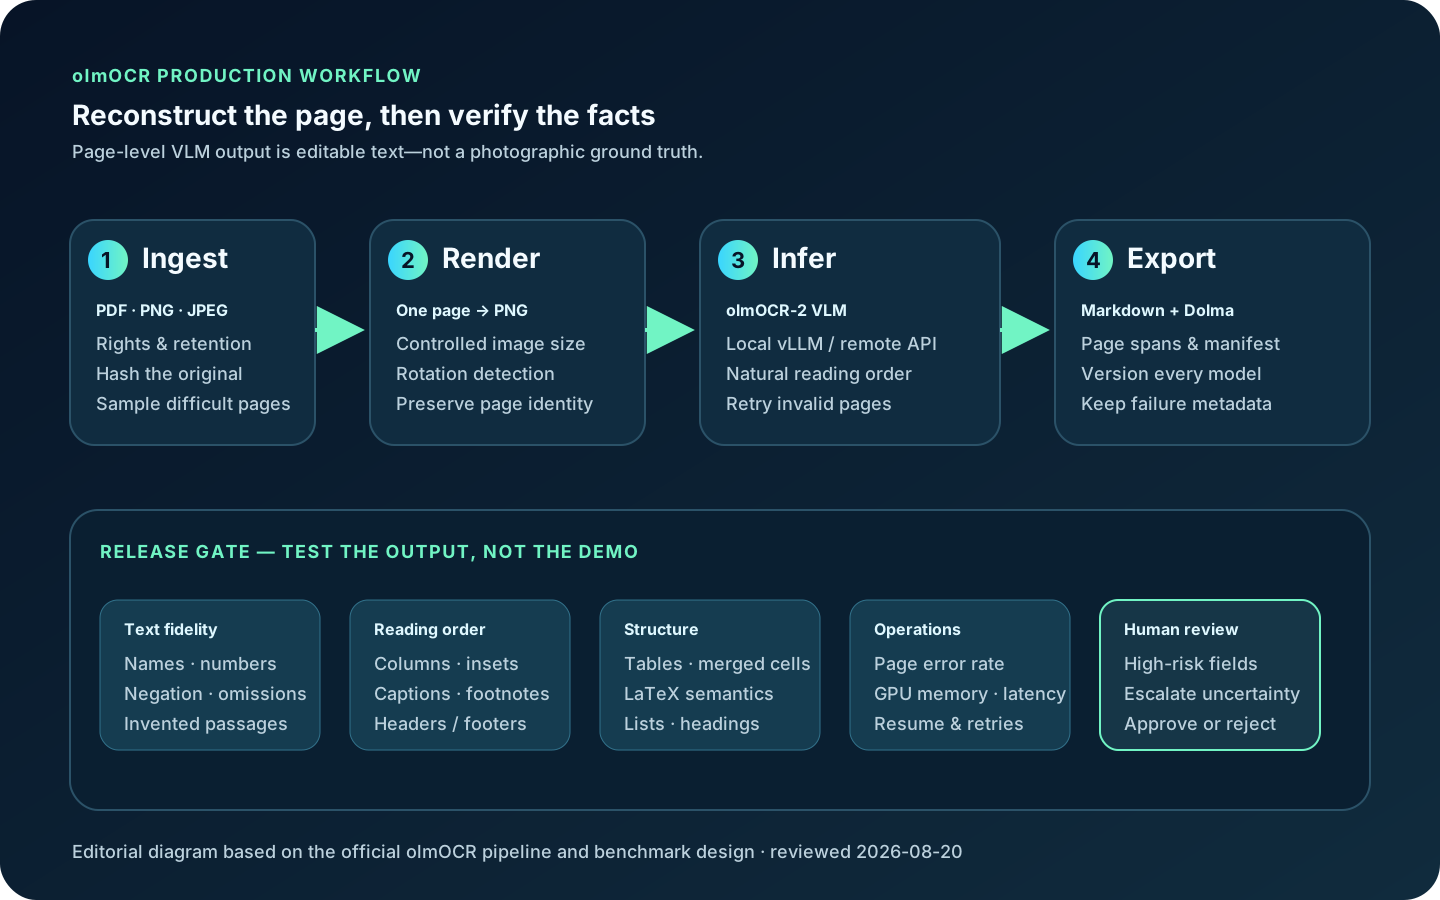
olmOCR ist AI2s quelloffenes GPU-Werkzeug zur Dokumentrekonstruktion: Es wandelt PDF-, PNG- und JPEG-Seiten mit Tabellen und Formeln in natürlich geordnetes Markdown oder Text um.
Gamma ist ein KI-gestützter Arbeitsbereich zum Erstellen bearbeitbarer Präsentationen, Dokumente, Webseiten, Social-Media-Beiträge und Grafiken. Dieser unabhängige Leitfaden behandelt Erstellungsmodi, aktuelle Plangrenzen, Importe und Exporte, Marken- und Zugänglichkeits-QA, Faktenprüfung, Website-Veröffentlichung, Datenschutz und Alternativen.
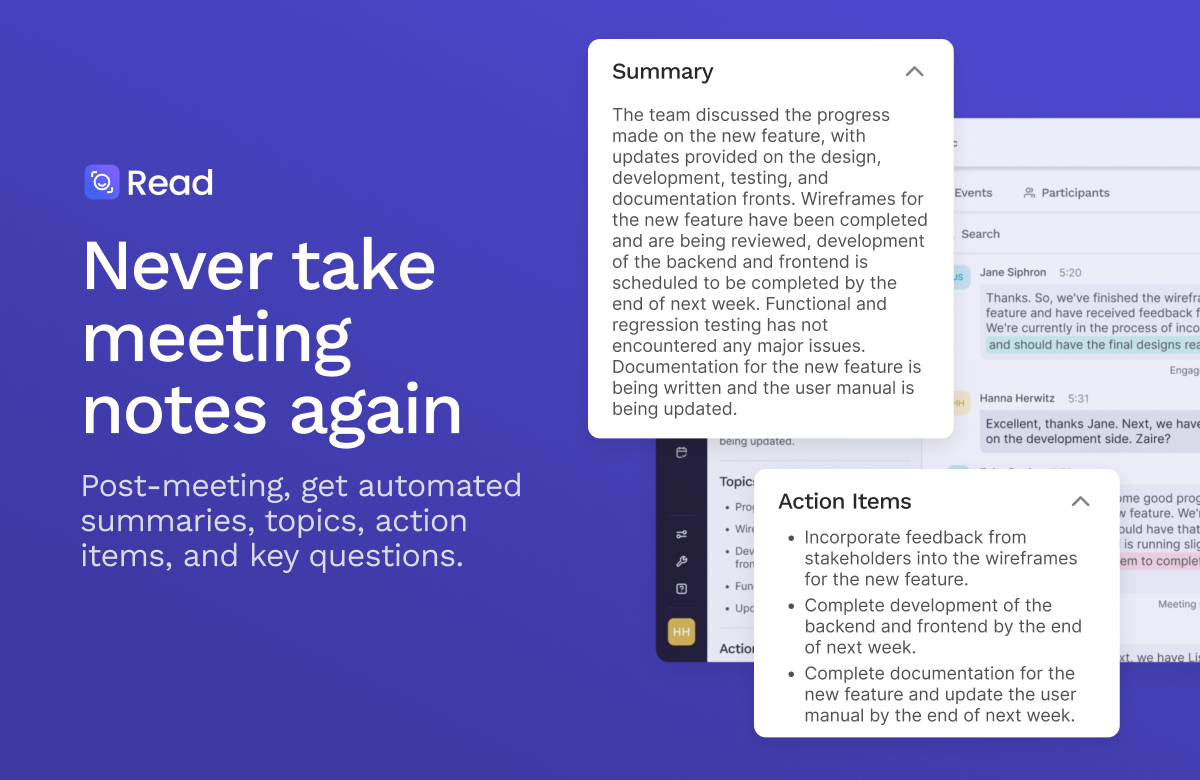
Read AI Digital Twin - work digital twin. Auf Basis offizieller und verlässlicher öffentlicher Quellen werden Nutzen, Stärken, Grenzen und Alternativen eingeordnet. Vor dem Einsatz sind Preise, Berechtigungen, Datenschutz, Verfügbarkeit und reale Qualität zu prüfen.