Unabhängiges Urteil:LibreCrawl ist ein MIT-lizenzierter Desktop-SEO-Crawler, der als kostenlose, anpassbare Alternative zum Crawlen von Websites, zum Extrahieren von SEO-Daten und zum Exportieren von Ergebnissen positioniert ist. Die stärkste Lösung sind unabhängige Berater und technische Teams, die Wert auf lokale Kontrolle legen und bereit sind, einen jüngeren Crawler zu testen. Der größte Fehler bei der Einführung bestünde darin, ein offenes Repository oder eine hohe Sternezahl als Beweis dafür zu betrachten, dass die Empfehlungen, Daten oder Bewertungen für jede Site korrekt sind.
Sein stärkstes Unterscheidungsmerkmal ist die Prüfbarkeit. Die Akzeptanz sollte weiterhin durch Crawl-Parität und Falsch-Positiv-Rate auf der eigenen Website des Teams entschieden werden.
Was LibreCrawl eigentlich macht
LibreCrawl sollte als Crawler-Tool und nicht als universelle SEO-Plattform bewertet werden. Die verifizierte Repository-Beschreibung lautet: „Kostenloser Desktop-Crawler SEO – Open-Source-Alternative zu Screaming Frog und ähnlichen Tools. Websites crawlen, Links analysieren, SEO-Daten extrahieren und Ergebnisse ohne Abonnementgebühren exportieren. Vollständig anpassbar und erweiterbar!“ Die Unterscheidung ist wichtig, da ein Crawler, eine Bibliothek für strukturierte Daten und ein MCP-Connector verschiedene Ebenen des SEO-Workflows lösen.
| Bestätigte Fähigkeit | Praktische Bedeutung |
|---|---|
| Konzentriert sich auf das lokale Desktop-Crawling ohne wiederkehrendes Softwareabonnement. | Überprüfen Sie das offizielle Setup und die Version, bevor Sie sich darauf verlassen. |
| Der offene Code kann für benutzerdefinierte Extraktion und teamspezifische Prüfungen erweitert werden. | Behandeln Sie Integrationen als separate Vertrauens- und Kostengrenzen. |
| Das Projekt begann im Jahr 2025, daher sollten das Skalierungsverhalten, die Rendering-Abdeckung und die Berichtsqualität einem Benchmarking unterzogen und nicht aus der Funktionsliste abgeleitet werden. | Vergleichen Sie das Verhalten auf einer repräsentativen Website oder einem repräsentativen Konto. |
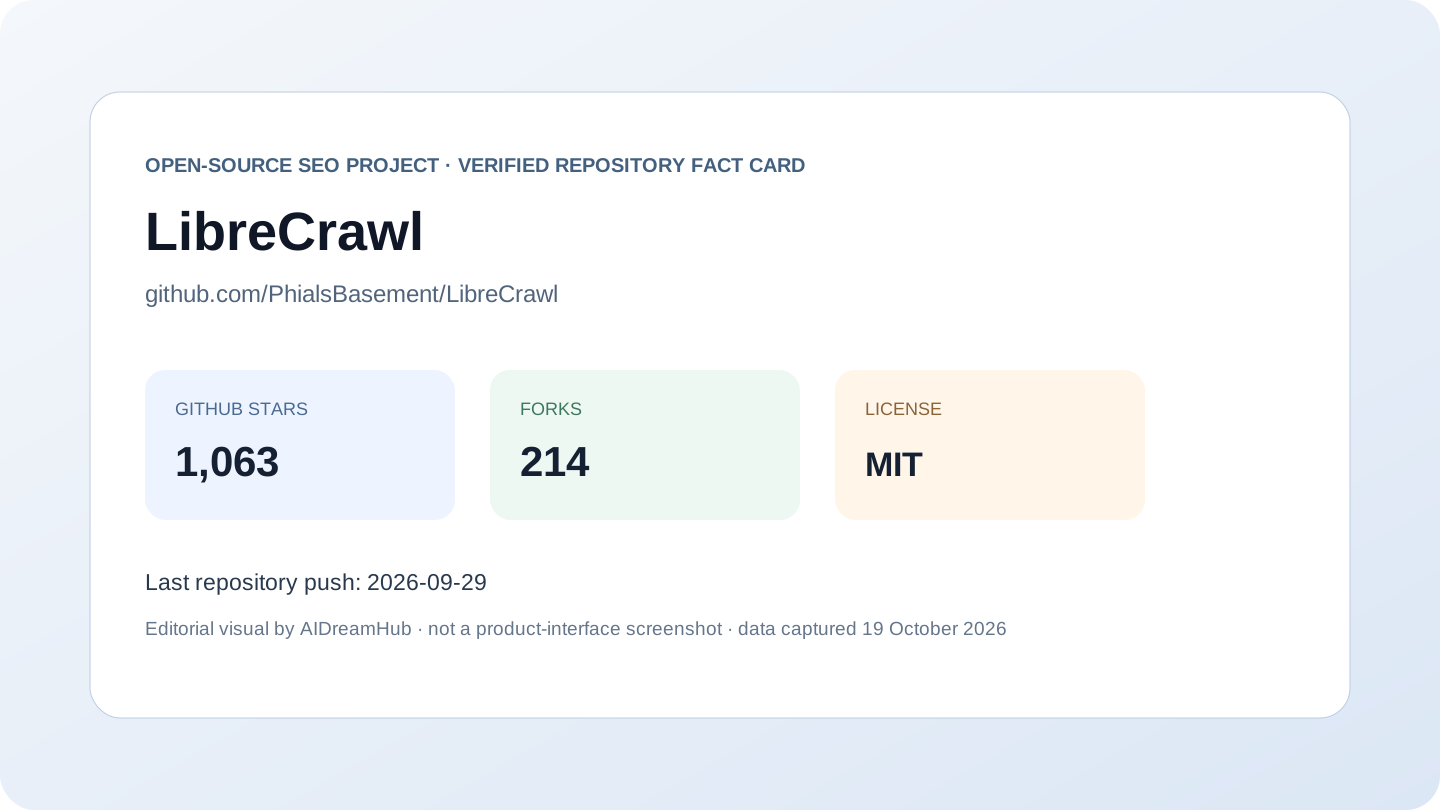
Aktueller GitHub Beweisschnappschuss
Die folgende Tabelle wurde am 19. Oktober 2026 erfasst. „Neueste“ bedeutet in dieser Überprüfung die aktuelle Repository-Aktivität, während „heiß“ eine Mischung aus Aufmerksamkeit und Aktivität ist. Beide Begriffe stellen keine Qualitätsgarantie dar.
| Beweise | Beobachtet | Wie man es interpretiert |
|---|---|---|
| Repository-Aktivität | 1.063 Sterne · 214 Gabeln | Community-Aufmerksamkeit und Wiederverwendungssignal; kein Beweis für SEO Ergebnisse |
| Letzter Stoß | 2026-09-29 | Aktuelle Codeaktivität; Überprüfen Sie Releases und Breaking Changes vor der Produktion |
| Lizenz | MIT | Bestätigen Sie die Verpflichtungen zur Verbreitung, SaaS-Nutzung und Änderungen |
| Primärer Stapel | Python | Zeigt die wahrscheinlichen Wartungsfähigkeiten an, nicht die Vollständigkeit der Funktionen |
Optimale Arbeitsabläufe
Beste Passform:unabhängige Berater und technische Teams, die Wert auf lokale Kontrolle legen und bereit sind, einen jüngeren Crawler zu testen.
- Erstellen Sie ein lokales Inventar von Titeln, Überschriften, Kanonika und Statuscodes.
- Exportieren Sie Crawl-Zeilen für Tabellenkalkulationen oder benutzerdefinierte Analysen.
- Fügen Sie projektspezifische Extraktions- oder Issue-Regeln in einem Fork hinzu.
Praktischer Ausgangspunkt:Vergleichen Sie ein repräsentatives Unterverzeichnis mit einem etablierten Crawler, vergleichen Sie die URL-Erkennung und die gerenderte Ausgabe, messen Sie die Speichernutzung und führen Sie eine reproduzierbare Konfigurationsdatei.
Einschränkungen, Sicherheit und Betriebskosten
- Desktop-Ressourcen schränken sehr große Crawls ein und JavaScript-Rendering kann den Zeit- und Speicherverbrauch erhöhen.
- Open Source garantiert kein ausgereiftes Problemmodell, keine Support-Antwort oder Update-Rhythmus.
- Crawler-Ergebnisse benötigen weiterhin Protokolle, Analysen und Search Console Beweise für die Priorisierung.
Open Source beseitigt eine Form der Bindung, aber es beseitigt nicht die Entwicklungszeit, die Modell- oder API-Gebühren, die Browser-/Proxy-Kosten, die Bedingungen des Datenanbieters, den Authentifizierungsaufwand, die Sicherungen oder das Upgrade-Risiko. Ordnen Sie jeden externen Dienst und jede schreibfähige Aktion vor dem Produktionseinsatz zu.
LibreCrawl im Vergleich mit Alternativen
| Option | Wählen Sie es wann | Kompromiss |
|---|---|---|
| Screaming Frog | ausgereiftes konfigurierbares technisches Crawling | kommerzielle Lizenz über dem kostenlosen Limit |
| SiteOne-Crawler | SEO plus Sicherheit, Zugänglichkeit und Leistung | breiterer Anwendungsbereich, anderer Arbeitsablauf |
| SEOnaut | selbst durchgeführte wiederkehrende Audits | Server- und Datenbank-Setup statt Desktop-Nutzung |
Der Vergleich erfolgt aufgabenbezogen und stellt keinen Anspruch darauf dar, dass ein Produkt allgemein besser ist. Eine schmale Bibliothek übertrifft möglicherweise eine Suite innerhalb ihres Frameworks, während ein ausgereifter kommerzieller Crawler möglicherweise günstiger ist als die Wartung eines offenen Tools im großen Maßstab.
Eine siebenstufige Bewertung vor der Einführung
- 1.Definieren Sie eine Entscheidung und einen begrenzten Testsatz, bevor Sie Konten installieren oder verbinden.
- 2.Pinnen Sie die Repository-Revision oder -Release an und notieren Sie die verwendete Konfiguration.
- 3.Überprüfen Sie mehrere Ausgaben anhand der Live-Seite, der Quellkonsole oder eines anderen unabhängigen Tools.
- 4.Trennen Sie deterministische Beobachtungen von Bewertungen, Schätzungen und modellbasierten Empfehlungen.
- 5.Messen Sie Fehlalarme, fehlende Abdeckung, Laufzeit und Anbieterkosten anhand einer realistischen Stichprobe.
- 6.Verwenden Sie Anmeldeinformationen mit den geringsten Rechten. Für Bearbeitungen, Übermittlungen, Löschungen oder Veröffentlichungen ist eine Genehmigung erforderlich.
- 7.Behalten Sie Rohexporte und einen Rollback-Plan bei, damit das Ergebnis nach einem Update überprüft werden kann.
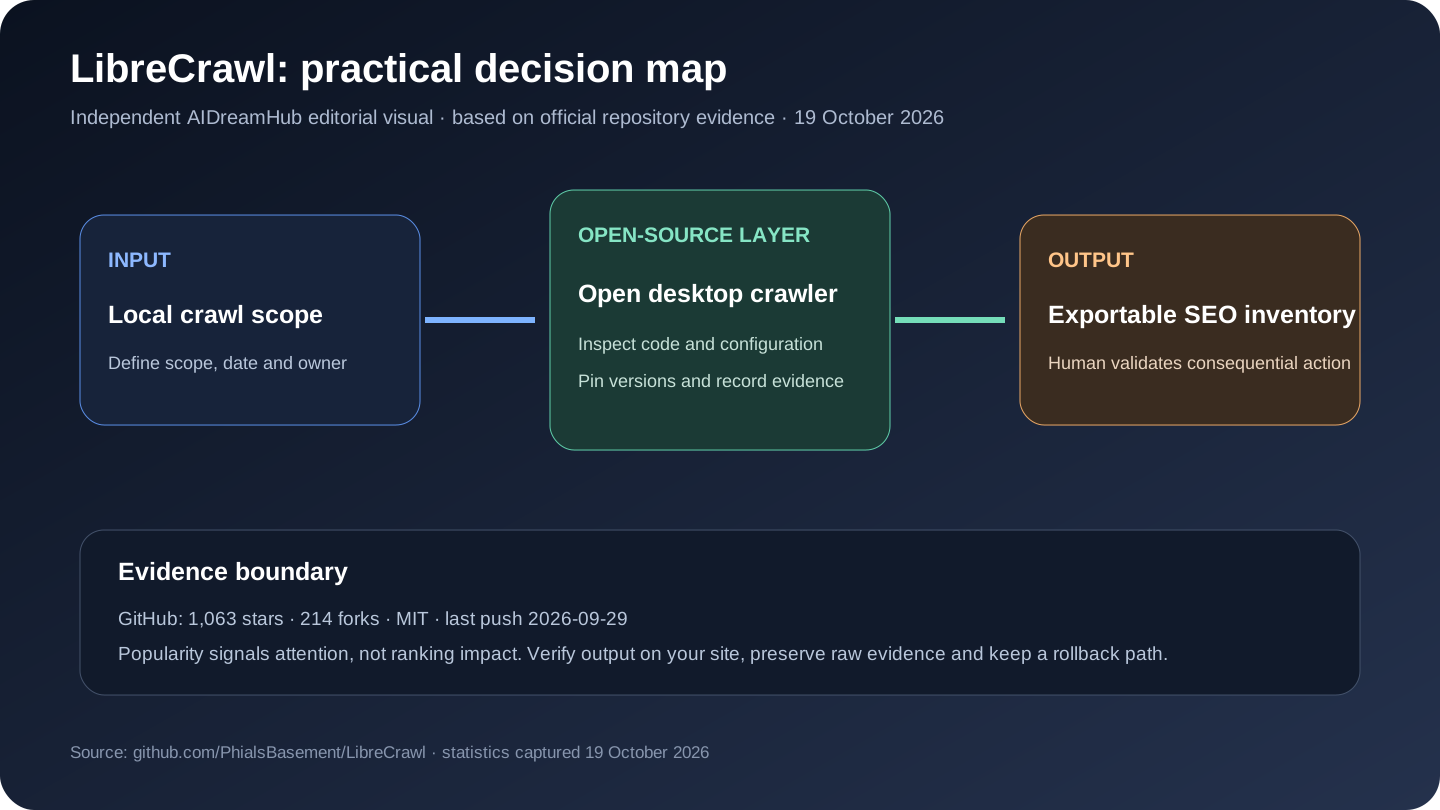
Unsere unabhängige Meinung
Sein stärkstes Unterscheidungsmerkmal ist die Prüfbarkeit. Die Akzeptanz sollte weiterhin durch Crawl-Parität und Falsch-Positiv-Rate auf der eigenen Website des Teams entschieden werden. Das ist auch die Entscheidungsgrenze: Behalten Sie das Tool, wenn es reproduzierbare Beweise liefert und die Arbeit an einer realen Site reduziert; lehnen Sie es ab, wenn das Team hauptsächlich mehr Punkte, Prosa oder Ausgabevolumen ohne klarere Entscheidungen erhält.
Häufig gestellte Fragen
Ist es wirklich Open Source?
Die API GitHub hat am 19. Oktober 2026 MIT gemeldet. Überprüfen Sie die Lizenzdatei und die Abhängigkeitslizenzen des Repositorys auf die genauen Rechte und Pflichten. Eine verbundene Cloud-API oder ein gehosteter Dienst kann separate Bedingungen haben, selbst wenn der Clientcode geöffnet ist.
Bedeutet die Popularität von GitHub, dass sie das Ranking verbessert?
Nein. Sterne und Verzweigungen weisen auf Aufmerksamkeit und Wiederverwendung hin, nicht auf Ranking-Steigerung, Datengenauigkeit oder Eignung für eine bestimmte Website. Nutzen Sie eine kontrollierte Auswertung mit Search Console, Analysen und manuell verifizierter Ausgabe.
Für wen ist es am besten?
LibreCrawl eignet sich am besten für unabhängige Berater und technische Teams, die Wert auf lokale Kontrolle legen und bereit sind, einen jüngeren Crawler zu testen. Es ist schlecht geeignet, wenn das Team seine Laufzeit nicht bedienen, seine Beweise nicht überprüfen oder die von ihm angeforderten Berechtigungen nicht besitzen kann.
Was sollte zuerst getestet werden?
Nutzen Sie einen repräsentativen Arbeitsablauf: Erstellen Sie ein lokales Inventar von Titeln, Überschriften, Kanonika und Statuscodes. Erfassen Sie Inputs, Rohoutput, Zeit, Ausfälle und alle externen Kosten und vergleichen Sie sie dann mit der aktuellen Methode des Teams.
Kann es eine kommerzielle SEO-Suite ersetzen?
Normalerweise nur für einen definierten Arbeitsabschnitt. Open-Source-Workflow- und Audit-Tools umfassen selten den gleichen proprietären Backlink-Index, die gleiche historische SERP-Abdeckung, die gleiche Support-Organisation, die gleichen Berechtigungen und die ausgefeilte Kundenberichterstattung wie eine ausgereifte kostenpflichtige Suite.
So verwenden Sie LibreCrawl: Quick Start
Dieser Arbeitsablauf ist eine Zusammenfassung der offiziellen README-Datei und Dokumentation des Projekts. Führen Sie es zunächst auf einer Test-Site, einer Test-Eigenschaft oder einer lokalen Umgebung aus. Überprüfen Sie die verlinkte Quelle erneut, wenn sich die Versionen ändern.
Voraussetzungen
- Docker und Docker Verfassen Sie für den empfohlenen Pfad
- Git
- Genügend lokaler Speicher und Festplatte für den Crawl und optionales JavaScript-Rendering
Installieren und ausführen
git clone https://github.com/PhialsBasement/LibreCrawl.git
cd LibreCrawl
cp .env.example .env
docker compose up -d

# Open the local interface
http://localhost:5000
Arbeitsablauf bei der ersten Verwendung
- Klonen Sie das Repository und überprüfen Sie die Beispielumgebungsdatei.
- Lassen Sie LOCAL_MODE nur für den privaten lokalen Gebrauch aktiviert und starten Sie die Docker-Dienste.
- Öffnen Sie die lokale Benutzeroberfläche und erstellen Sie einen kleinen Crawl mit konservativen URL- und Parallelitätsbeschränkungen.
- Exportieren Sie das Ergebnis und vergleichen Sie entdeckte URLs, Canonicals und gerenderte Ausgaben mit einem zweiten Crawler.
So bestätigen Sie, dass es funktioniert hat
Die lokale Schnittstelle wird geöffnet, der begrenzte Crawl wird abgeschlossen und exportierte Zeilen stimmen mit manuell überprüften Seiten überein, ohne dass es zu einer unerklärlichen URL-Inflation kommt.
Vor dem Produktionseinsatz
Das automatische Startskript kann Abhängigkeiten und Browser installieren. Überprüfen Sie es vor der Verwendung, setzen Sie den nicht authentifizierten lokalen Modus niemals dem Internet aus und vergleichen Sie die Ressourcennutzung vor großen Crawls.
Offizielle Quick Start-Quelle: PhialsBasement/LibreCrawl README.
Quellen überprüft
- Offizielles GitHub-Repository
- Offizielle README
- Offizielle Veröffentlichungen
- Commit-Verlauf
- Repository-Lizenz
Redaktionelle Überprüfung aktualisiert am 19. Oktober 2026. Repository-Statistiken, Dokumentation, Abhängigkeiten und Bedingungen für gehostete Dienste können sich ändern. Überprüfen Sie vor der Installation, Beschaffung oder Bereitstellung die verlinkten offiziellen Quellen.